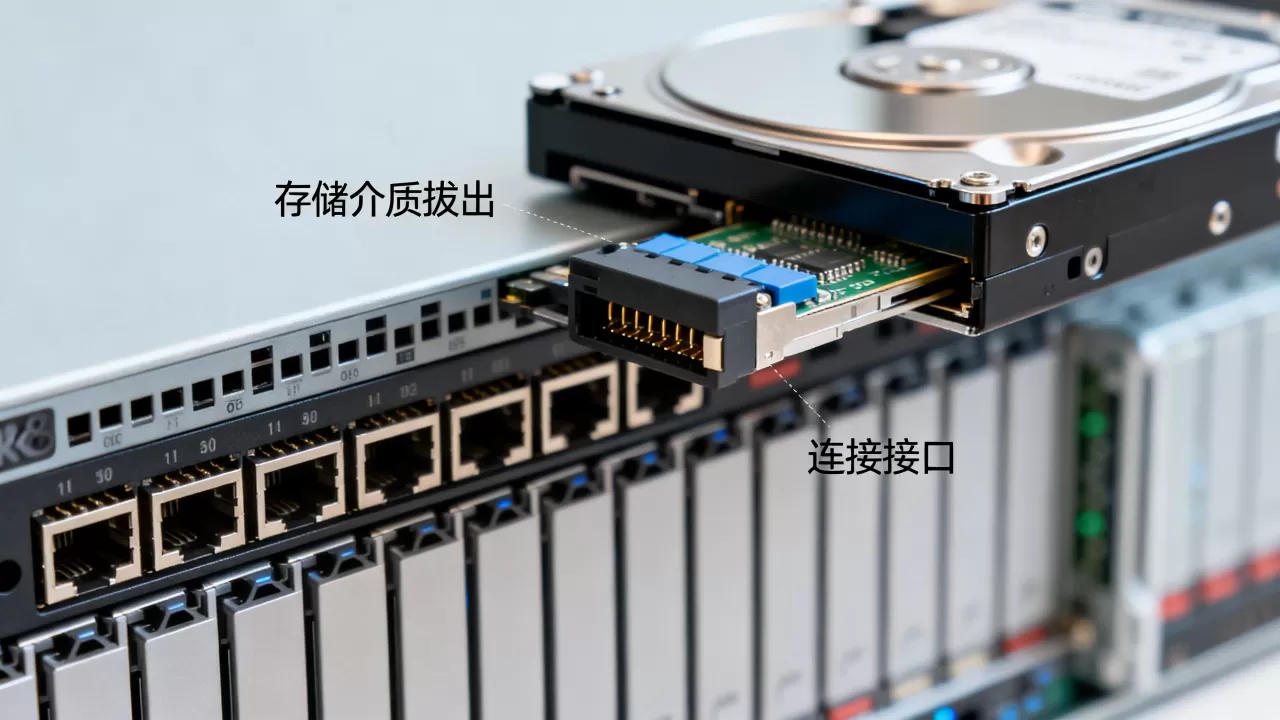
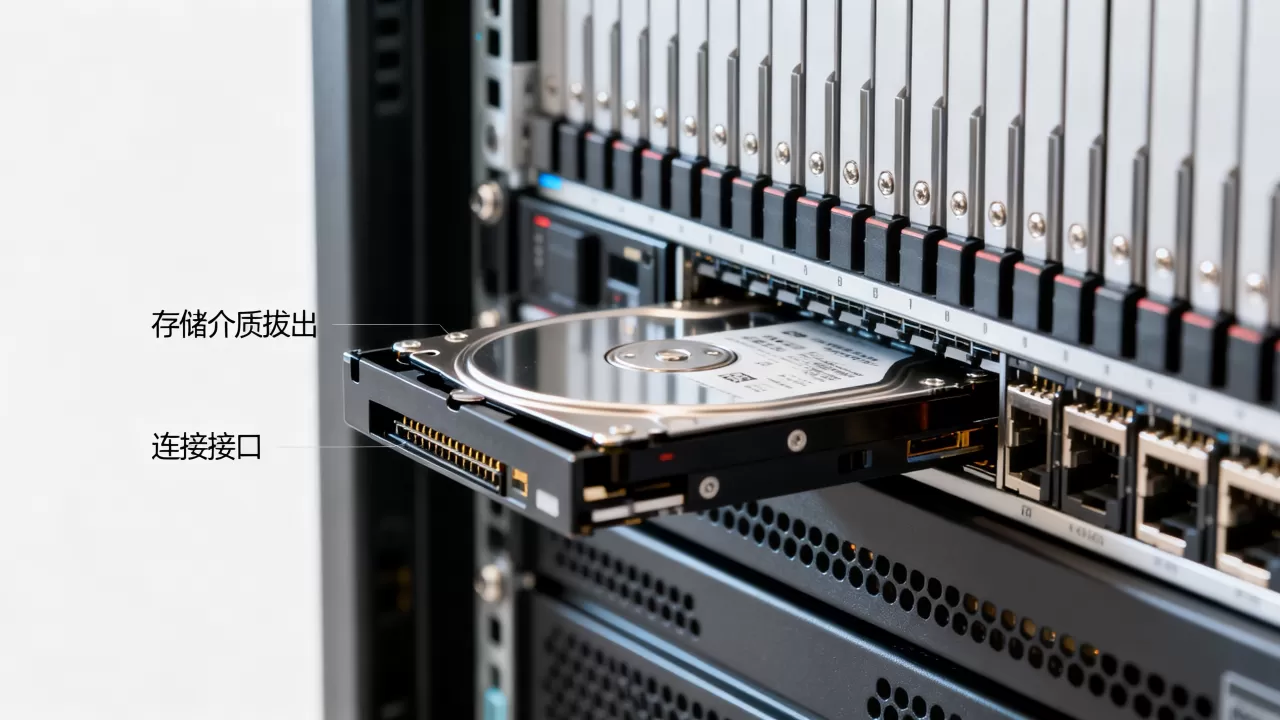
ALM-4287373399 存储介质拔出告警意味着服务器检测到某块硬盘或SSD已经从插槽中移除,此时应立刻确认硬件状态并评估业务风险,避免数据丢失或服务中断。
ALM-4287373399 存储介质拔出原因及快速定位
告警编号背后的含义
ALM-4287373399 是服务器存储管理模块在检测到存储介质(硬盘或SSD)从背板或接口断开时触发的标准告警,该编号常见于华为等企业级服务器,告警级别通常为“紧急”或“警告”,取决于介质是否在读写状态下被拔出,行业共识认为,这类告警往往由硬件状态变化直接触发,并非软件误报。

常见原因分类
- 人为误操作:机房巡检或维护时,操作人员不慎碰触硬盘托架,导致热插拔连接松动;或者未按流程卸载硬盘直接拔出,触发告警。
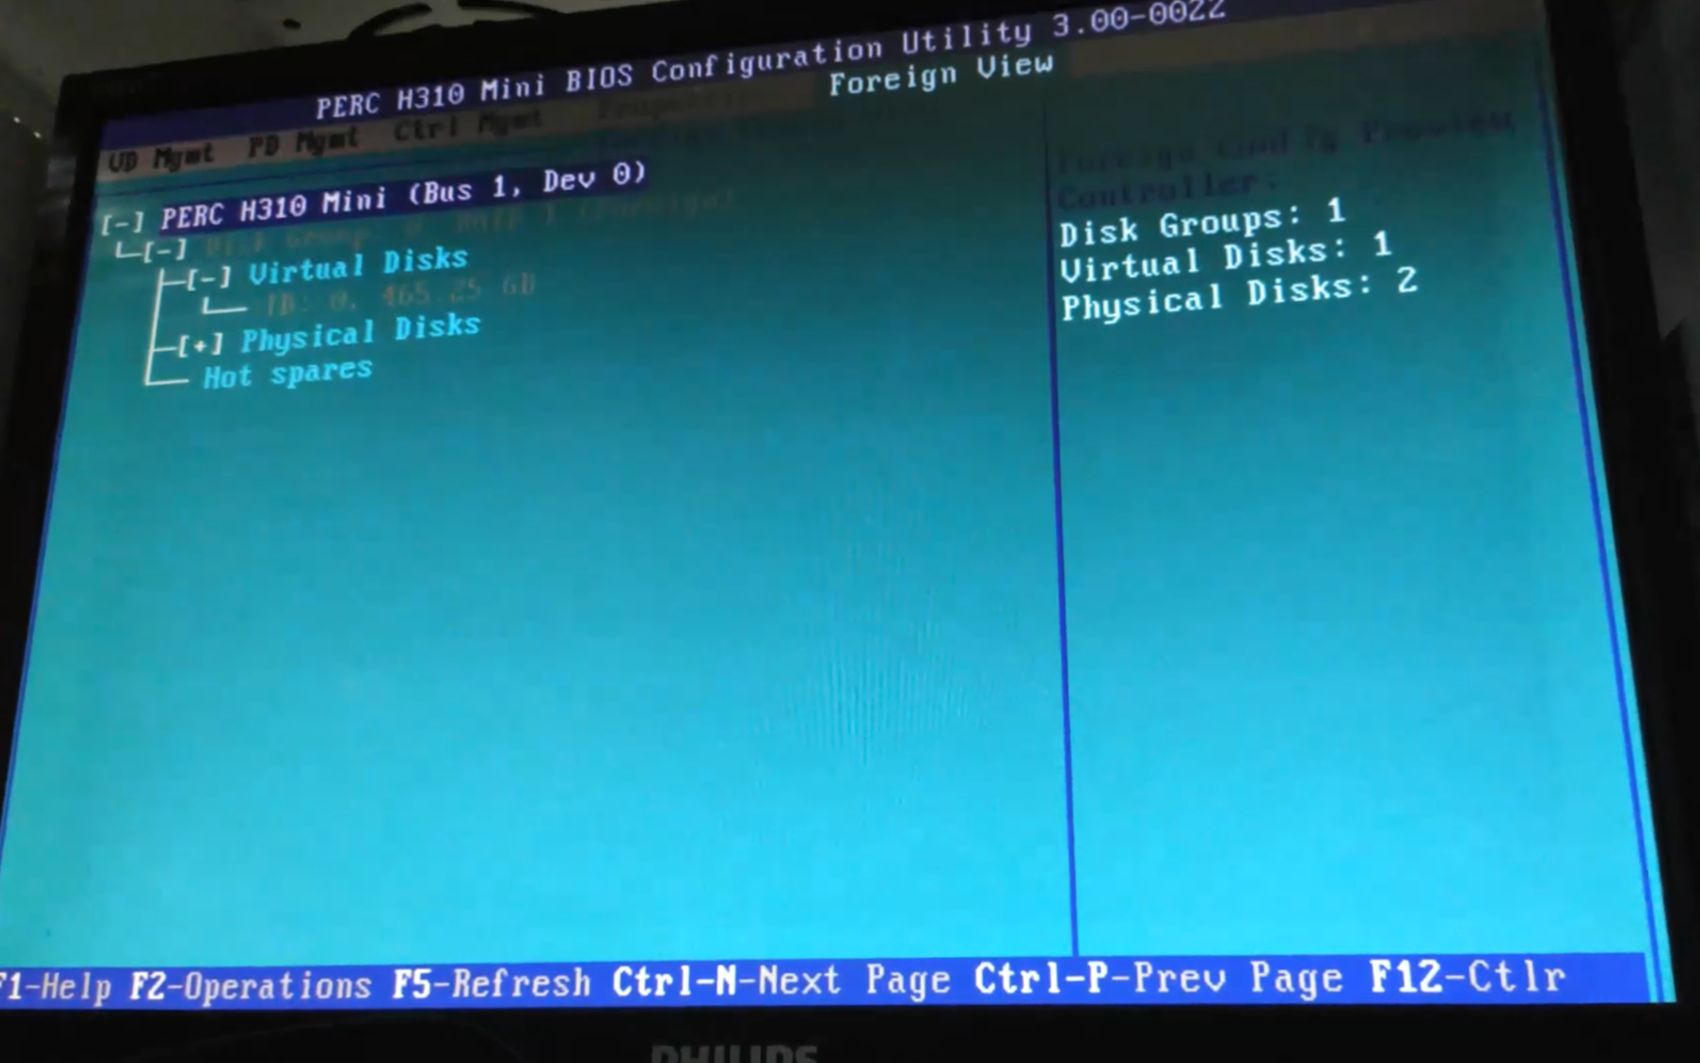
- 硬件故障:硬盘本身损坏导致与背板接触不良;背板接口松动、电源不稳或RAID卡故障,导致系统误认为介质已拔出。
- 环境因素:机柜受到冲击或震动,导致硬盘从插槽中微微弹出;温度过高使连接器膨胀变形,引发接触中断。
快速定位方法
- 登录服务器管理界面(如iBMC、iLO、DRAC)查看告警详情,确认槽位号(如Slot 0-3)。
- 现场检查对应硬盘指示灯:正常状态为绿色常亮,若指示灯熄灭或琥珀色闪烁,则可能存在物理拔出或故障。
- 查看系统日志:在Linux下执行
dmesg | grep -i "removed",或检查/var/log/messages中关于SCSI/SATA设备移除的记录。 - 使用存储管理命令:以MegaRAID为例,运行
MegaCli -PDList -aALL,检查“Firmware state”是否为“Missing”或“Unconfigured(bad)”。
存储介质拔出对服务器业务的影响
不同RAID级别下的后果
拔出硬盘的影响取决于RAID配置和业务负载,下表列出常见场景:
| RAID级别 | 拔出一块盘的影响 | 数据是否丢失 |
|---|---|---|
| RAID 0 | 整个阵列失效,业务中断 | 数据完全丢失 |
| RAID 1 | 阵列降级为单盘,读性能下降 | 数据不丢失 |
| RAID 5 | 阵列降级,读性能下降,写性能受影响 | 数据不丢失 |
| RAID 6 | 阵列降级,仍可容忍一块盘故障 | 数据不丢失 |
| RAID 10 | 阵列降级,取决于故障盘所在镜像组 | 数据不一定丢失 |
关键点:若拔出的是RAID 0的盘,或正在执行写入操作时拔出,可能导致文件系统损坏或数据永久丢失,多数情况下,RAID 1/5/6/10在拔出单盘后仍能继续运行,但必须尽快修复。
对业务连续性的影响
- 读写性能下降:阵列降级后,系统需要从剩余磁盘重建数据,读请求需要额外计算,延迟增加30%-50%。
- 服务中断风险:如果在此期间又发生第二块盘故障,整个阵列可能崩溃,业务完全中断。
- 数据一致性风险:若拔出时正在缓存写操作,未落盘的数据可能丢失,导致数据库事务异常。
服务器存储介质拔出告警怎么处理?实操步骤
第一步:确认告警状态
- 通过管理界面确认告警是否清除,若拔出后已插回,告警可能自动消失。
- 若告警持续,记录槽位号和硬盘序列号,准备进一步排查。
第二步:检查硬件连接
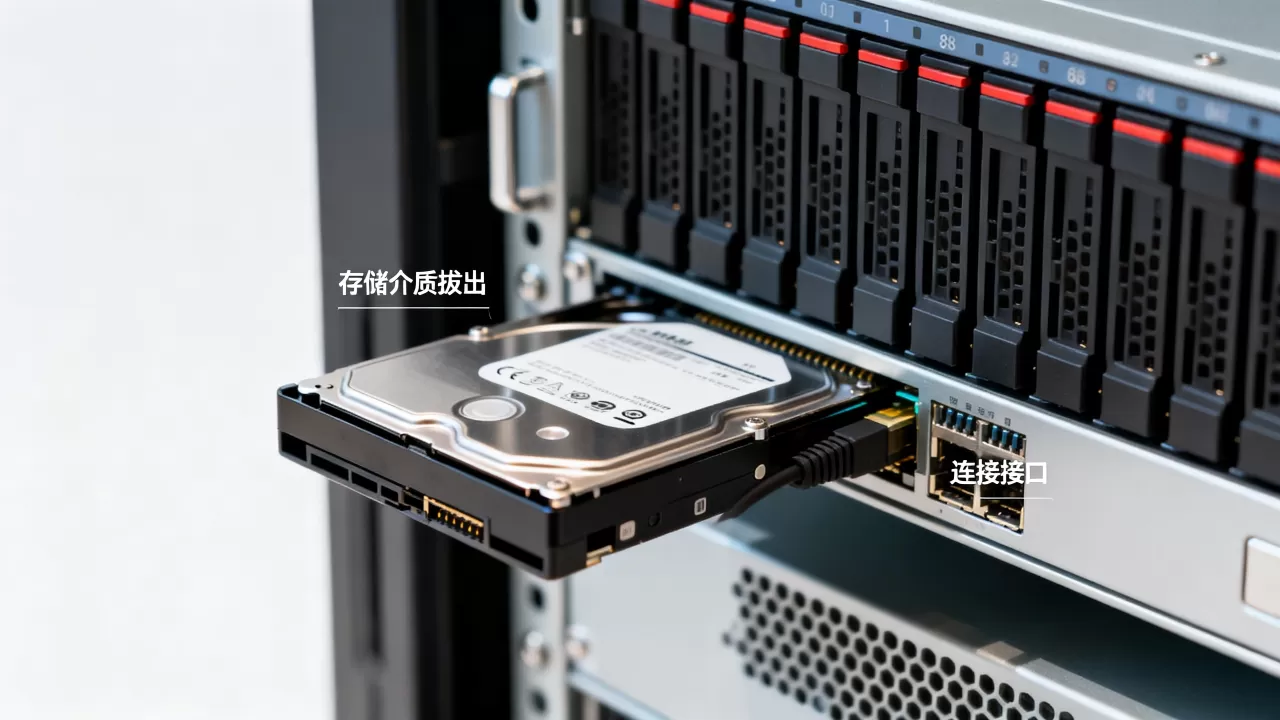
- 在服务器断电或热插拔支持下,轻推硬盘托架,确保其完全卡入插槽。
- 观察硬盘指示灯变化:若插回后指示灯恢复正常,告警通常会在几秒内清除。
- 若指示灯仍异常,尝试更换同型号硬盘(务必先确认保修状态)。
第三步:通过命令行验证
- 使用系统工具确认硬盘是否被识别:
lsblk
fdisk -l
- 对于RAID控制器,执行:
storcli /c0 /eall /sall show
查看“State”字段是否为“Onln”或“DHS”。
第四步:处理硬盘故障
- 若硬盘物理损坏,需更换新硬盘,更换后,RAID控制器会自动重建,重建时间与硬盘容量和RAID等级有关(1TB硬盘在RAID5下重建约需4-6小时)。
- 若为RAID卡故障,先尝试重启服务器或重置RAID卡,无效时,联系厂商更换RAID卡。
第五步:业务恢复验证
- 重建完成后,检查文件系统挂载状态,执行
mount确认。 - 对数据库业务,运行完整性检查(如MySQL的
CHECK TABLE)。 - 监控告警界面,确保ALM-4287373399已解除。
如何预防存储介质意外拔出:维护与规范
物理安全措施
- 使用带锁的机柜,限制非授权人员接触。
- 确保硬盘托架安装牢固,必要时使用螺丝固定。
- 在机柜底部安装减震垫,减少震动导致的松动。
操作流程规范
- 热插拔前必须通过系统卸载硬盘:在Linux下执行
echo 1 > /sys/block/sdX/device/delete,或使用存储管理软件先“下电”。 - 禁止在硬盘读写指示灯闪烁时拔出,等待指示灯熄灭后再操作。
- 建立操作记录表,每次拔插需登记时间、槽位、操作人。
监控与告警优化
- 设置告警阈值,如介质状态变化后立即发送短信或邮件。
- 定期检查硬盘健康状态(SMART信息),提前更换有坏道的盘。
- 使用集中管理平台(如Zabbix、Prometheus)监控服务器硬件告警,实现自动派单。
关于服务器存储介质拔出告警的常见问题
问:ALM-4287373399 告警出现后该如何快速定位?
答:首先查看告警中的槽位号,然后现场观察对应硬盘指示灯,如果指示灯熄灭,登录管理界面或使用MegaCli -PDList -aALL确认硬盘状态是否为“Missing”,若系统检测不到硬盘,则基本确认为物理拔出或故障,此时应检查连接是否松动,并查看系统日志中的设备移除记录。
问:存储介质拔出后数据会丢失吗?
答:这取决于拔出时是否在读写,以及RAID级别,在RAID1或RAID5下,拔出一块盘通常不会立即丢失数据,但阵列会降级,如果拔出的是RAID0的盘,或正在写入时拔出,数据可能损坏或丢失,即使数据未丢失,也建议在恢复后立即进行完整备份。
问:如何区分是误告警还是真实拔出?
答:检查硬盘指示灯:如果指示灯正常亮起,但告警出现,可能是背板接触不良或RAID卡误报,此时可以尝试重新插拔硬盘,观察告警是否清除,如果指示灯熄灭且系统日志显示“Device removed”,则为真实拔出,查看告警时间附近是否有其他硬件变动,如电源波动或机柜震动,辅助判断。
无论哪种情况,都应优先保证业务冗余,及时处理降级阵列,避免二次故障引发数据灾难。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/536816.html