在Python开发中,将httplib模块与日志模块结合,能够高效记录HTTP请求的详细信息,是调试和监控的必备技能。
Python httplib模块使用教程:基础操作与日志记录
开始使用httplib模块前,你需要明确它并非第三方库,而是Python标准库中的http.client(旧版称为httplib),这个模块提供了HTTP和HTTPS协议客户端的底层接口,许多开发者选择它,是因为它无需额外安装,且能精细控制请求的每个环节。
httplib模块日志记录:为什么需要整合
当你直接调用httplib发送请求时,默认情况下它几乎不输出任何信息,一旦请求失败或返回异常,你只能看到空泛的错误提示,无法定位具体原因,整合日志模块后,可以记录以下内容:
- 请求的URL、方法、请求头
- 响应状态码和响应体摘要
- 连接建立和关闭的时间点
- 网络异常和超时详情
这在实际场景中非常有用,比如排查线上接口问题、审计API调用频率、或者分析第三方服务的响应延迟,据Python官方文档,http.client支持通过设置debuglevel来输出调试信息,但默认输出到标准错误流,不利于集中管理,通过日志模块接管这些输出,你就能按需控制日志级别、格式和存储位置。
Python日志模块配置:设置日志级别和输出格式
Python的logging模块是标准库中最灵活的日志工具,配置它时,需要明确三个要素:日志器、处理器和格式化器,以httplib场景为例,一个典型的配置步骤如下:
- 创建日志器并设置级别,例如logger = logging.getLogger(‘httplib_logger’),然后设置logger.setLevel(logging.DEBUG)。
- 添加处理器,比如StreamHandler输出到控制台,或FileHandler写入文件。
- 设置格式化器,定义日志内容的模板,%(asctime)s – %(levelname)s – %(message)s’。
- 将处理器添加到日志器。
关键点在于,httplib本身并不直接使用你的日志器,你需要将httplib内部的调试输出捕获并转发到日志,一种常见做法是:设置http.client.HTTPConnection.debuglevel为非零值,然后自定义一个流类,重写write方法,将输出重定向到logging.getLogger,下面是一个简化示例:
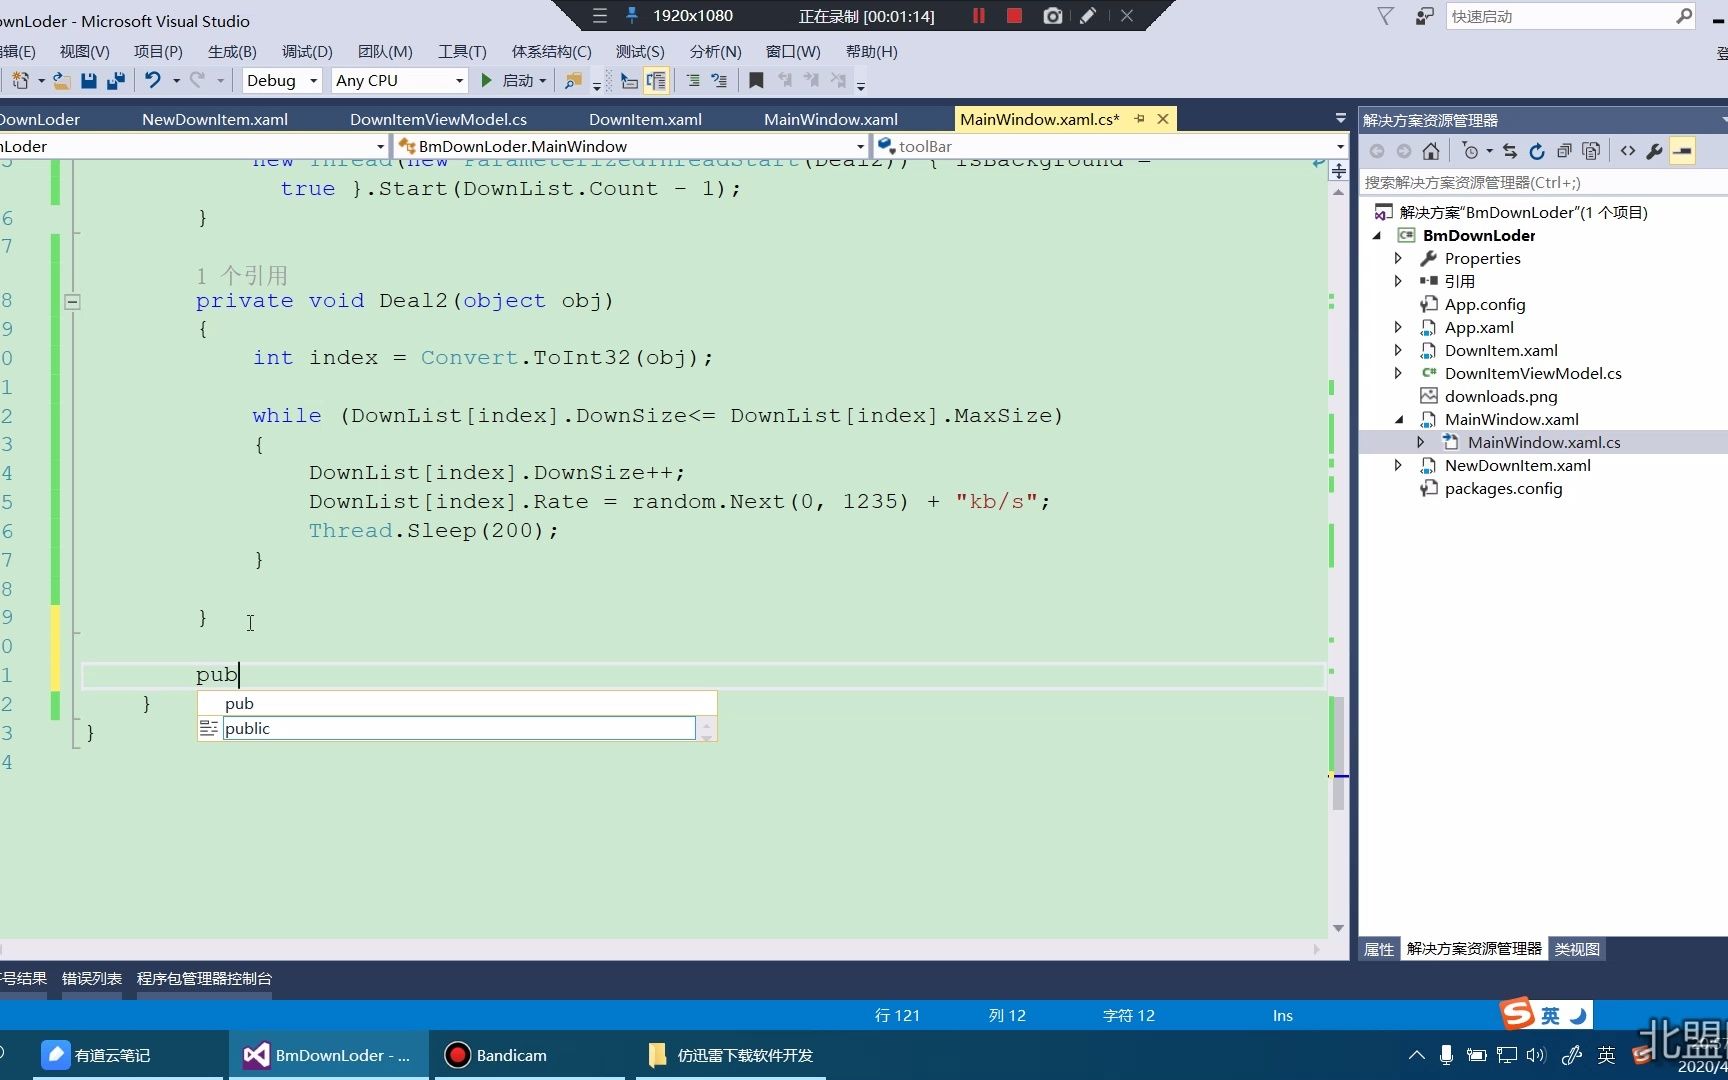
import http.client
import logging
import sys
logging.basicConfig(level=logging.DEBUG, format='%(asctime)s - %(message)s')
logger = logging.getLogger(__name__)
class HttpLoggingHandler(logging.Handler):
    def emit(self, record):
        # 将httplib的调试信息写入日志
        logger.log(record.levelno, record.getMessage())
# 设置debuglevel并重定向输出
http.client.HTTPConnection.debuglevel = 1
logging.captureWarnings(True)
这段代码使用captureWarnings捕捉httplib内部的警告,并通过debuglevel开启详细输出,但更简洁的方式是通过设置http.client.HTTPConnection的debuglevel,并将标准错误流重定向到日志,具体操作可参考官方文档中的Logging HOWTO。
Python http请求日志:实战配置步骤
下面是一套完整的实操路径,能让你在项目中快速落地httplib的日志记录。
配置httplib的debuglevel为0到4
httplib的debuglevel有5个等级,从0到4,0表示不输出任何调试信息,4输出最详细的内容,包括原始传输的数据,推荐在开发阶段设置为2或3,在生产环境设置为1或0,设置方法很简单:
import http.client
http.client.HTTPConnection.debuglevel = 2
但这样输出会直接打到标准错误流,要将其纳入日志系统,你需要创建一个自定义的流对象,并替换sys.stderr。
import sys
import logging
class LoggingStream(object):
    def __init__(self, logger, level=logging.DEBUG):
        self.logger = logger
        self.level = level
        self.linebuf = ''
    def write(self, buf):
        for line in buf.rstrip().splitlines():
            self.logger.log(self.level, line.rstrip())
    def flush(self):
        pass
logger = logging.getLogger('httplib_debug')
logger.setLevel(logging.DEBUG)
handler = logging.StreamHandler()
handler.setFormatter(logging.Formatter('%(asctime)s %(message)s'))
logger.addHandler(handler)
sys.stderr = LoggingStream(logger)
在这之后,任何httplib的调试输出都会被日志器捕获,并按照你设定的格式处理。
自定义日志适配器记录请求和响应
除了直接使用debuglevel,你还可以通过继承http.client.HTTPConnection或http.client.HTTPResponse,在关键方法中插入日志代码,这种方式更灵活,可以精确记录你关心的字段。

重写request方法,在发送前记录请求行和头:
class LoggingHTTPConnection(http.client.HTTPConnection):
    def request(self, method, url, body=None, headers={}):
        logger.info(f'Request: {method} {url}')
        logger.debug(f'Headers: {headers}')
        if body:
            logger.debug(f'Body: {body}')
        super().request(method, url, body, headers)
类似地,你可以重写getresponse方法,记录响应状态和头,这样你就能获得结构化的日志,而不仅仅是原始文本流。
Python httplib模块异常处理与日志记录
网络请求注定会碰到各种异常,比如连接超时、DNS解析失败、服务器拒绝连接等,httplib会抛出http.client.HTTPException及其子类,以及socket.error等,将这些异常记录到日志,是排查问题的关键。
日志记录httplib的异常信息
在调用httplib的地方包裹try-except,并使用logging.exception方法,该方法会自动附加当前异常的回溯信息,比普通的logging.error更详细。
import http.client
import logging
logger = logging.getLogger(__name__)
try:
    conn = http.client.HTTPConnection('example.com', timeout=5)
    conn.request('GET', '/')
    response = conn.getresponse()
    logger.info(f'Status: {response.status}')
except Exception as e:
    logger.exception('httplib请求失败')
finally:
    conn.close()
logging.exception默认使用ERROR级别,并自动包含异常堆栈,这比手动格式化异常信息更高效。
最佳实践:日志轮转和性能考虑
如果程序频繁发送HTTP请求,日志量会迅速增长,建议使用RotatingFileHandler或TimedRotatingFileHandler来分割日志文件,设置合适的日志级别:生产环境使用INFO或WARNING,避免记录太多DEBUG信息,你还可以添加过滤器,只记录特定URL或特定状态码的日志。
行业共识认为,日志记录应该对业务性能影响最小化,在日志处理中避免同步写入远程存储,优先使用异步日志处理器或本地文件缓存,据多年运维经验,日志滚动保留7到30天,即可满足大部分排查需求。
Python httplib和requests对比:日志记录差异
很多开发者纠结于选择httplib还是requests库,从日志记录角度看,两者有显著差异。
requests的日志记录方式
requests库底层使用urllib3,它通过logging.getLogger(‘urllib3’)输出日志,默认仅记录错误,要开启更详细的信息,需要设置urllib3的日志级别,并启用调试模式。
import logging
logging.getLogger('urllib3').setLevel(logging.DEBUG)
但requests对日志的定制程度有限,你无法颗粒度控制每个请求的日志输出,比如单独记录请求头或响应体。
httplib日志记录的优势
httplib是标准库,不依赖第三方包,适合对依赖有严格要求的项目,通过自定义连接类和重定向流,你可以完全主导日志的内容和格式,httplib的debuglevel输出非常原始,包含所有传输数据,这在调试HTTP协议细节时尤为有用,如果你需要记录完整的请求和响应原始报文,httplib是更直接的选择。
如果你的项目已经使用requests,并且日志需求不复杂,直接配置urllib3的日志级别即可,但若要追求深度定制,httplib提供了更大的空间。
最终结论:将httplib模块与日志模块紧密结合,能让你在Python项目中获得对HTTP通信的全面可见性,无论是调试异常还是监控调用,都更加得心应手。
关于httplib模块日志记录的常见问题
Q1: Python httplib模块如何开启日志记录?
A: 最直接的方式是设置http.client.HTTPConnection.debuglevel为非零值,然后将标准错误流重定向到logging模块,也可以继承HTTPConnection类,在request和getresponse方法中手动记录日志。
Q2: 如何将httplib的日志输出到文件?
A: 配置logging的FileHandler或RotatingFileHandler,将日志器添加该处理器,确保在重定向stderr或自定义连接类时,使用同一个日志器实例,这样httplib的调试信息和你的自定义日志都会写入同一文件。
Q3: Python日志模块配置时需要注意什么?
A: 避免重复添加处理器,以免日志重复输出,生产环境应限制日志级别为INFO或WARNING,并启用日志轮转,使用logging.exception记录异常时,它已经包含堆栈信息,无需手动添加traceback。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/536000.html