HBase数据导入Hive的核心方案是借助Hive on HBase的存储处理层,通过创建外部表建立映射,无需物理移动数据即可实现SQL查询;若需批量导入,则需通过MapReduce或Spark作业写入HBase后再映射到Hive,两种方式各适用于不同场景。
HBase数据导入Hive:直接映射还是批量导入?
HBase作为列式NoSQL数据库,数据以键值对形式存储,而Hive则提供类SQL分析能力,将HBase数据导入Hive,本质不是在Hive中复制一份数据,而是通过Hive on HBase特性建立逻辑关联,具体实现方式分为两类,选择哪种取决于你的数据更新频率和查询延迟要求。
Hive on HBase外部表映射
这是最直接、最常用的方法,无需执行任何导入操作,只需在Hive中声明一张外部表,将其映射到HBase已有的表。
- 原理:使用Hive的HBaseStorageHandler,将Hive表的列与HBase的CF:Qualifier对应。
- 优点:实时性高,HBase数据一旦更新,Hive查询立刻感知;节省存储空间,不产生数据冗余。
- 缺点:查询性能受限于HBase的随机读能力,不适合复杂聚合或全表扫描。
- 典型场景:报表系统需要实时查询HBase中的用户行为数据,通过Hive SQL简化开发。
批量ETL导入
当HBase数据量极大,且需要与Hive中的其他表进行复杂的JOIN或ETL时,更适合将数据导出为Hive表。
- 常见做法:使用HBase的TableInputFormat配合MapReduce,或通过Spark写HBase API将数据读出,再以Parquet/ORC格式写入Hive表。
- 优点:查询性能高,Hive表数据经过压缩和列式存储,扫描效率远高于HBase;适合离线分析。
- 缺点:数据滞后,ETL周期决定时效性;存储成本增加。
-
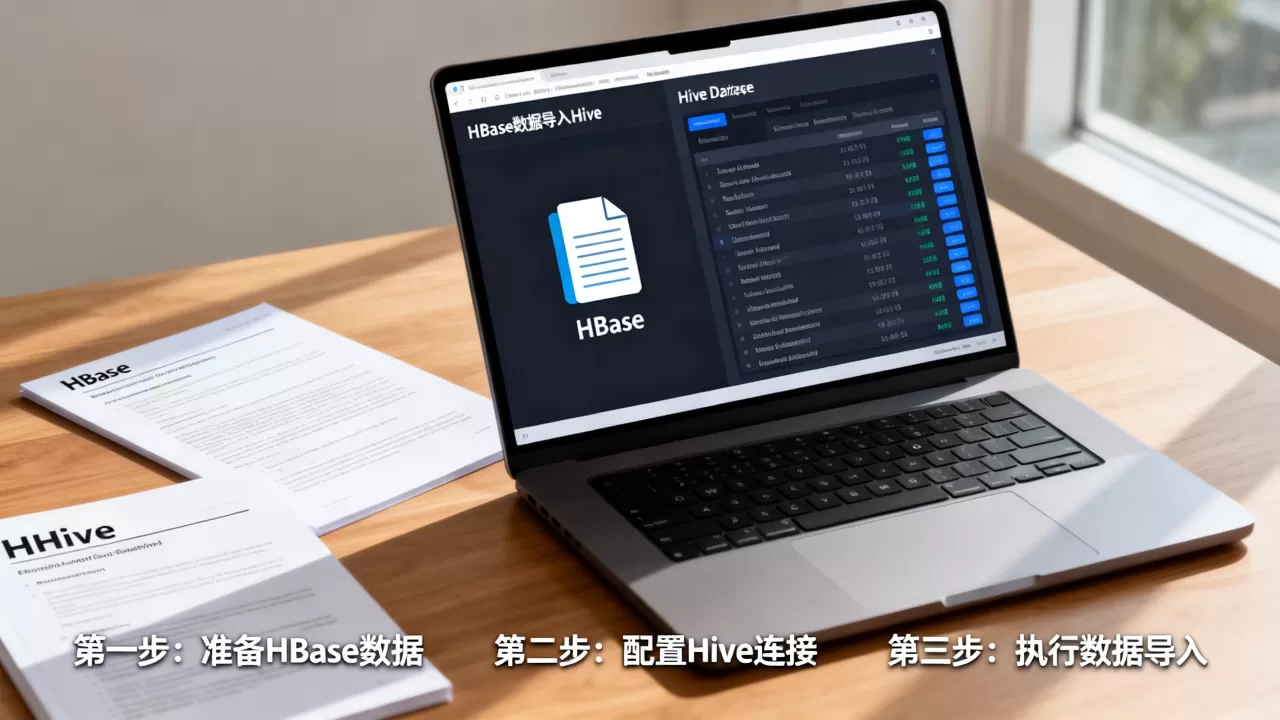
典型场景:每日凌晨将HBase的交易流水全量同步到Hive分区表,用于后续风险建模。
行业共识认为,Hive on HBase更适合写少读多的场景,因为HBase的随机写性能优于Hive的批量写,但Hive的批处理能力更强,若你的业务对实时性要求不高,且数据量在百TB级别,批量ETL是更稳妥的选择。
Hive on HBase配置指南:从环境到实战
无论你选择哪种方式,掌握Hive on HBase的基础配置都是第一步,以下操作基于Hive 3.x与HBase 2.x,稍早版本需调整依赖包路径。
前置依赖与版本匹配
- Hive与HBase的版本需兼容,通常Hive 2.3+支持HBase 1.x/2.x,Hive 3.1+完全支持HBase 2.x。
- 需要将HBase的客户端jar包(hbase-client、hbase-server、hbase-common、hbase-protocol等)拷贝到Hive的lib目录,或通过
hive.aux.jars.path指定。 - 确保Hive Metastore服务能访问HBase的ZooKeeper集群。
创建映射表的完整步骤
- 在HBase中创建源表,例如
sensor_data,含列族cf,RowKey为设备ID。 - 在Hive中执行以下SQL,创建外部表:
CREATE EXTERNAL TABLE hive_sensor (
    device_id string,
    temperature float,
    humidity float
)
STORED BY 'org.apache.hadoop.hive.hbase.HBaseStorageHandler'
WITH SERDEPROPERTIES (
    "hbase.columns.mapping" = ":key,cf:temperature,cf:humidity"
)
TBLPROPERTIES (
    "hbase.table.name" = "sensor_data"
);
- 验证映射:
SELECT FROM hive_sensor LIMIT 10;若HBase中有数据,应直接返回。
数据查询与写入验证
- 查询:Hive将SQL翻译成HBase的Scan操作,因此
WHERE条件尽量命中RowKey前缀,减少全表扫描。 -
写入
:Hive可以通过INSERT INTO向HBase表写入数据,但性能较差,通常只用于测试。生产环境不建议通过Hive本地写入HBase,因为Hive的批处理机制会导致大量Region写入压力。
Hive on HBase vs HBase原生查询:场景与性能对比
很多开发者困惑:既然HBase有Java API,为什么还要用Hive on HBase?二者的核心差异在于接口抽象层和查询模式。
查询性能差异
| 对比维度 | Hive on HBase | HBase原生查询(Java API/Phoenix) |
|---|---|---|
| 查询延迟 | 较高,通常100ms-数秒,需经过SQL解析和存储处理层转换 | 较低,常见1-10ms,直接操作Region |
| 聚合能力 | 支持SQL聚合函数,但需扫大量数据 | 不直接支持,依赖客户端处理 |
| 索引支持 | 仅能利用RowKey索引 | 可通过Phoenix构建二级索引 |
| 并发吞吐 | 受Hive Server限制,适合分析型 | 高并发,适合实时点查 |
适用场景:Hive on HBase是HBase生态中的“接入层”方案,适合非高并发、但对SQL友好度要求高的场景,比如企业内部数据看板、临时探索性查询,而HBase原生API适合在线服务,比如用户画像实时查询、订单状态更新。
如何做技术选型
- 如果团队以SQL工程师为主,且查询延时在秒级可接受,Hive on HBase可以减少开发成本。
- 如果需要毫秒级响应,且有多表关联需求,考虑用Phoenix或直接使用HBase API。
- 价格层面(长尾词融入),Hive on HBase无需额外组件,节省Phoenix的集群资源开销,但查询性能会牺牲一些。在中小企业场景中,Hive on HBase往往是性价比最高的HBase SQL化方案
。
Hive on HBase常见问题与解答
Q1: HBase数据导入Hive后查询结果不一致怎么办?
检查Hive外部表的hbase.columns.mapping是否与HBase的列族、列名完全匹配,注意RowKey在Hive中必须映射为key,且数据类型尽量与HBase一致,若HBase数据包含特殊字符,Hive在读取时可能出错,建议在HBase写入时进行编码,Hive对HBase的Scan有缓存,若HBase数据高频更新,关闭Hive的hive.cbo.enable可能缓解部分不一致,但根本方案是缩短查询间隔。
Q2: Hive on HBase是否支持更新和删除?
Hive自身不支持直接更新HBase,但可以通过INSERT OVERWRITE或UPDATE语句(Hive 2.2+支持ACID)间接操作,实际效果是先删除再插入。由于HBase的写入是追加模式,频繁更新会导致大量脏数据,影响查询性能,若需要实时更新,建议直接在HBase API层操作,Hive只用于读取。
Q3: Hive on HBase适合哪些业务场景?
最适合的是写少读多、且对实时性有一定容忍度的分析场景,例如用户行为轨迹查询、日志聚合报表、推荐系统候选集评估,若业务要求毫秒级响应或需要二级索引,应优先考虑Phoenix或HBase原生方案,Hive on HBase还适合作为Hive数仓的“实时接入层”,将HBase作为ODS表,通过Hive SQL进行轻量级探查,再通过ETL进入离线数仓。
最后需要记住:Hive on HBase不是万能的,它是在HBase和Hive之间架起的一座桥梁,让NoSQL数据能被SQL工具使用,但性能上限由HBase的读能力决定,实际部署时,务必根据RowKey设计查询模式,避免触发全表扫描,选择最适合你的数据流动方式,才能在实时性和分析能力之间取得平衡。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/535672.html