HBase MapReduce入门的核心是掌握TableInputFormat和TableOutputFormat两个类,配合HBase API即可高效读写HBase表,实现大规模数据的批量处理。 无论你是初次接触HBase,还是希望将MapReduce作业与HBase集成,这条路都不复杂,本文从环境搭建到代码实战,再到性能优化,一步步带你上手。
HBase MapReduce入门教程:环境与依赖准备
在编写第一个HBase MapReduce作业前,你需要确认开发环境满足以下条件:
- Hadoop与HBase集群已部署,版本建议选CDH或Apache稳定版(如Hadoop 2.7+、HBase 1.4+)
- Java JDK 1.8及以上
- Maven 3.6+用于项目管理
创建Maven项目后,在pom.xml中添加核心依赖:
<dependency>
    <groupId>org.apache.hbase</groupId>
    <artifactId>hbase-client</artifactId>
    <version>2.4.17</version>
</dependency>
<dependency>
    <groupId>org.apache.hbase</groupId>
    <artifactId>hbase-mapreduce</artifactId>
    <version>2.4.17</version>
</dependency>
注意版本号需与集群匹配,业内专家指出,依赖版本不一致是入门阶段最常见的错误,建议直接使用与集群相同的HBase版本。
配置连接信息时,将hbase-site.xml放到classpath下,或通过Configuration对象手动设置zookeeper地址:
Configuration config = HBaseConfiguration.create();
config.set("hbase.zookeeper.quorum", "zk1,zk2,zk3");
config.set("hbase.zookeeper.property.clientPort", "2181");
至此,环境准备完毕,下一步进入实战环节。
HBase MapReduce实战:读取HBase表数据
读取场景常见于全表扫描或范围扫描后做聚合、过滤,官方提供的TableInputFormat能自动将HBase的Row按Region切分,交给Mapper处理。
Mapper类继承TableMapper,输入键为ImmutableBytesWritable(行键),输入值为Result对象,下面是一个读取用户表并统计活跃用户的示例:
public class ActiveUserMapper extends TableMapper<Text, IntWritable> {
    private final static IntWritable one = new IntWritable(1);
    private Text userId = new Text();
    @Override
    protected void map(ImmutableBytesWritable key, Result value, Context context)
            throws IOException, InterruptedException {
        // 假设列族info中有字段last_login,非空表示活跃
        byte[] lastLogin = value.getValue(Bytes.toBytes("info"), Bytes.toBytes("last_login"));
        if (lastLogin != null && lastLogin.length > 0) {
            userId.set(key.get());
            context.write(userId, one);
        }
    }
}
驱动类中设置扫描器和输出路径:
Scan scan = new Scan();
scan.setCaching(500); // 优化:调大Region缓存行数
scan.setCacheBlocks(false); // 批量作业建议关闭块缓存
Job job = Job.getInstance(config, "ActiveUserCount");
TableMapReduceUtil.initTableMapperJob(
    "user_behavior",  // 输入表名
    scan,
    ActiveUserMapper.class,
    Text.class,
    IntWritable.class,
    job
);
job.setReducerClass(IntSumReducer.class);
job.setOutputFormatClass(TextOutputFormat.class);
FileOutputFormat.setOutputPath(job, new Path("/output/active_users"));
注意:如果表数据量极大,Scan的caching值需要根据Region Server内存调整,多数情况下设为500-2000有效减少RPC次数。
HBase MapReduce实战:写入数据到HBase表
写入场景常见于将清洗后的结果批量回写HBase,使用TableOutputFormat,Reducer输出Put即可。
Reducer类示例将计数器结果写入统计表:
public class CountReducer extends Reducer<Text, IntWritable, ImmutableBytesWritable, Put> {
    @Override
    protected void reduce(Text key, Iterable<IntWritable> values, Context context)
            throws IOException, InterruptedException {
        int sum = 0;
        for (IntWritable val : values) sum += val.get();
        Put put = new Put(Bytes.toBytes(key.toString()));
        put.addColumn(Bytes.toBytes("stats"), Bytes.toBytes("count"), Bytes.toBytes(String.valueOf(sum)));
        context.write(null, put);
    }
}
驱动中设置输出表:
TableMapReduceUtil.initTableReducerJob(
    "user_statistics",  // 输出表名
    CountReducer.class,
    job
);
job.setOutputFormatClass(TableOutputFormat.class);
注意:写入时务必在Reducer中一次输出多个Put会造成大量小事务,影响吞吐,建议在Reducer内批量累积Put,使用TableOutputFormat的批量提交特性,或继承TableReducer并重写cleanup方法统一提交。
HBase MapReduce性能优化:解决数据倾斜问题
数据倾斜是HBase MapReduce作业中典型的性能瓶颈,常见于行键分布不均或扫描范围过大,行业共识认为,以下措施能有效改善:
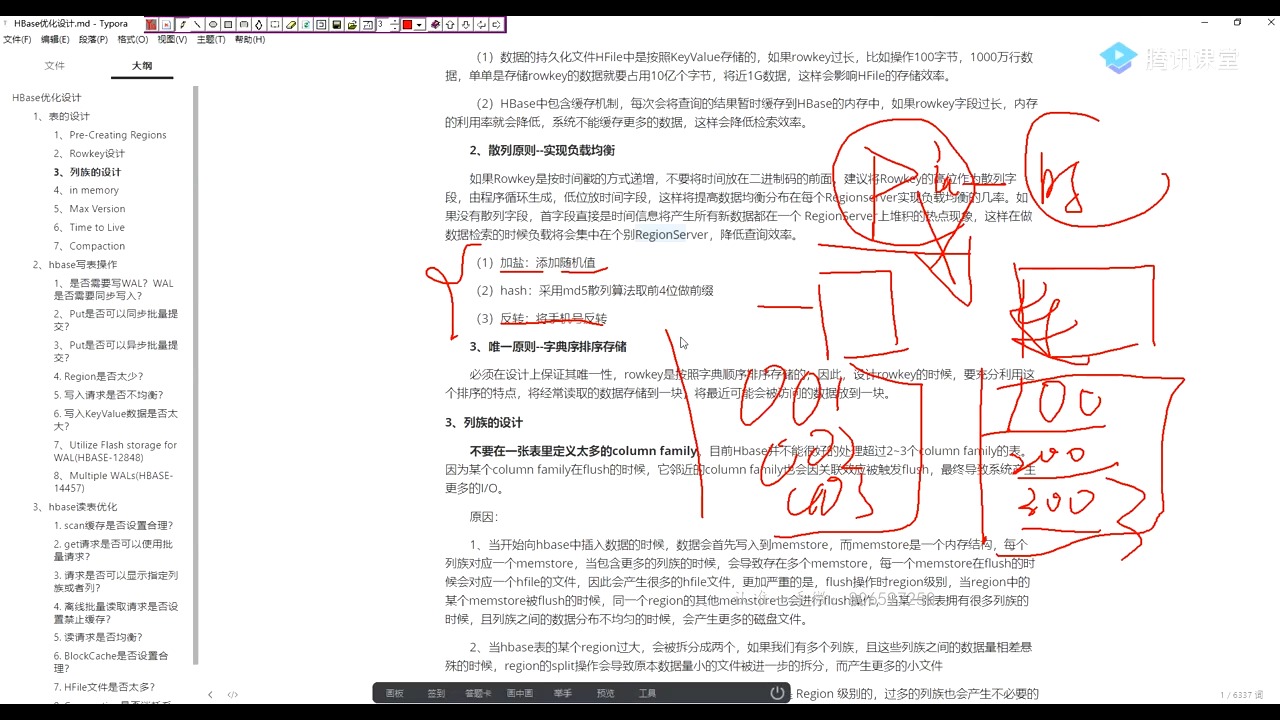
- 预分区写入:设计行键时加入盐值(salting)或哈希前缀,使数据均匀分布到多个Region。
- 调整Split策略:根据实际数据量设置合理的Region数量,避免单Region过载。
- 使用TableInputFormat的setScan方法时,指定STARTROW和STOPROW缩小扫描范围。
- 在Mapper端开启Combiner,减少网络传输量。
对于对比场景,HBase MapReduce在处理小批量随机读写时不如Hive on Tez灵活,但在需要精确控制RowKey扫描逻辑时,MapReduce直接操作HBase的API更底细,性能也更容易调优,如果你纠结于框架选型,入门阶段建议先掌握HBase MapReduce,它能帮你理解数据流动的底层原理。
HBase MapReduce入门常见问题解答
如何解决HBase MapReduce作业运行缓慢的问题?
首先检查Map数量是否合理,HBase MapReduce的Map数由表的Region数决定,如果Region数太少(比如小于10),可以手动设置mapreduce.job.maps增加并行度,但不要超过Region数,确保Scan的caching值足够大,同时关闭CacheBlocks(setCacheBlocks(false)),如果Reducer端写入HBase,建议批量提交。
HBase MapReduce与Hive对比,哪个更适合批量处理?
Hive适合SQL用户,自动生成MapReduce或Tez作业,开发效率高;HBase MapReduce更适合需要精确控制RowKey扫描、列族过滤以及自定义逻辑的场景,国内多数大数据团队在实时数仓中会混合使用:Hive做离线ETL,HBase MapReduce处理增量更新或复杂扫描,入门阶段建议两者都了解,但先掌握HBase MapReduce能让你更透彻理解HBase的存储模型。
HBase MapReduce写入数据时出现Put冲突怎么办?
如果多个Reducer写同一行,可能造成版本冲突,解决方案有:在Reducer内做去重或合并后再写入,或者使用HBase的Increment操作替代Put,适当调整HBase的写缓冲区(hbase.client.write.buffer)可以缓解频繁写入的压力。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/535516.html