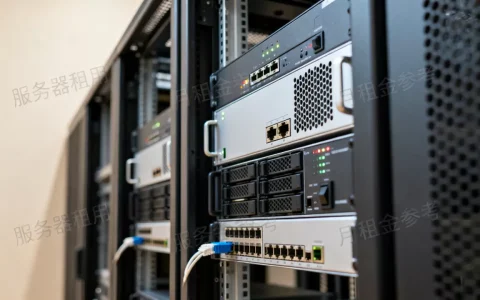
IPFS云存储设备大数据库,本质是一个记录全球IPFS存储节点(设备)信息与存储内容状态的“超级黄页”;它能让你快速找到靠谱设备、验证存储内容、监控存储状态,是确保数据安全存储与高效取回的关键基础设施。
IPFS云存储设备大数据库是什么?一个“超级黄页”的诞生
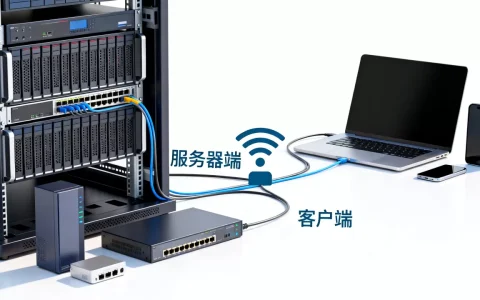
它不是一个具体的网站或App,而是一个建立在IPFS协议之上的、不断更新和扩充的索引系统,想象一下,你想租用一个仓库,但世界上有成千上万个仓库分散各地,大小、安全等级、价格都不同,你怎么找到最合适的一个?这个“大数据库”就是这个领域的“包打听”和“信用评价官”。
它主要干两件事:
- 登记注册:任何接入IPFS网络的存储设备(专业矿机、家用NAS、服务器集群),都可以自愿或通过激励机制,将自己的“身份信息”和“能力清单”记录到数据库中。
- 状态同步:持续追踪这些设备是否在线、存储了什么内容(通过唯一的CID哈希值标识)、存储冗余度如何、响应速度快慢。
相比简米云OSS,IPFS云存储优势在哪?
为了方便理解,我们直接对比主流的中心化云存储:
- 数据确权:在IPFS上,你的数据由唯一的CID(内容哈希)锁定,存到任何节点上,都无法被篡改,这是技术保证,而非一纸协议。
- 成本分摊:存储空间来源于全球闲置的存储资源,在较大规模的部署下,长期成本往往低于中心化云存储,尤其在冷存储、归档存储场景。
- 抗审查与高可用:数据被分割、加密并分布在全球多个节点,即便是单个节点或数据中心故障,甚至区域断网,只要仍有节点存储了你的数据副本,内容即可取回。
- 自带缓存加速被某人访问,就会在IPFS网络边缘节点形成缓存,后续的访问者可能直接从地理或网络距离更近的节点获取,速度更快。
怎么用这个大数据库查询设备与数据?
这涉及到两个核心查询动作:查设备和查数据,你不必关心底层的复杂协议,目前主要通过一些服务商提供的“检索市场”或“仪表盘”来操作。
操作实战:四步锁定你的数据状态
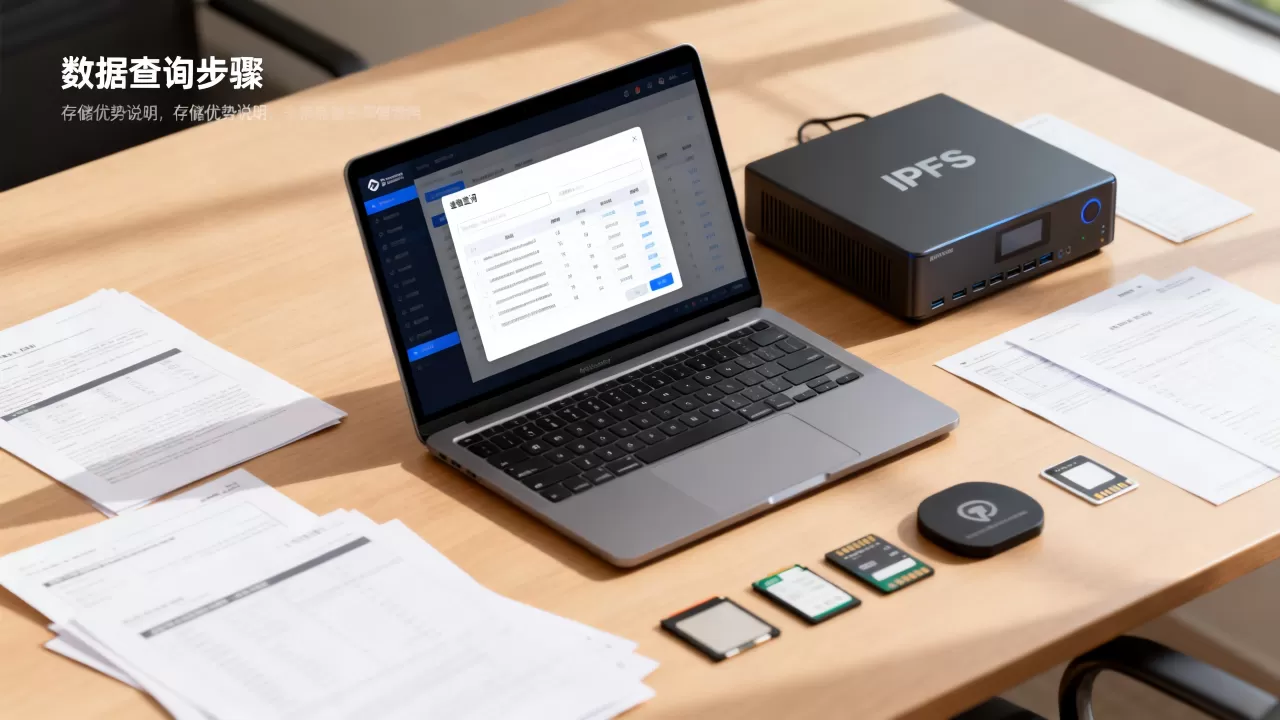
假设你已经通过类似上海IPFS数据中心哪家稳定这样的服务商上传了一份重要文件,并获得了CID(QmXxx...),现在你想知道这份文件被安全地存储在哪里了:
- 登录服务商管理后台:进入你购买存储服务的平台。
- 进入“存储状态”或“数据中心”面板:这个面板背后调用的就是设备大数据库的接口。
- 输入你的CID进行查询:
- 系统会返回一个列表,展示所有当前存储了你这份文件副本的设备信息。
- 列表信息通常包括:
- 设备地理位置/IP:法兰克福数据中心”、“东京集群节点”。
- 在线状态(最近心跳时间):展示设备最近一次报告状态的时间,判断是否活跃。
- 存储时长/合约剩余时间:显示这份数据在该设备上已存储多久,或合约何时到期。
- 节点信誉评分:这是IPFS云存储设备价格对比2026时的一个重要质量参数,评分基于历史存储成功率、在线率、服务时长等。
- 深度核查与取回:
- 如果你不放心,可以复制CID,到一些公开的IPFS网关(如
ipfs.io/ipfs/QmXxx...)尝试直接访问,验证内容完整性。 - 如果需要取回,你的服务商或你自己运行的IPFS节点会通过数据库提供的节点信息,发起检索请求,从最快的节点获取数据。
- 如果你不放心,可以复制CID,到一些公开的IPFS网关(如
核心查询工具与命令
对于开发者和高级用户,还可以通过以下方式直接与网络交互:
- 使用IPFS CLI命令:
ipfs dht findprovs <CID>:这个命令会询问分布式哈希表(DHT),直接返回当前有哪些对等节点(设备)在“广播”自己存储了该CID对应的内容。 - 通过公开的DHT监控网站:有一些网站可视化地展示了部分DHT网络的查询结果,可以辅助查看数据的分布广度。
它带来的三大核心好处:从猜疑到信任
存储透明化,每一份数据都有“足迹”
过去,你把文件交给云服务商,它说“存好了”,但你无法验证,通过数据库查询,你能看到:
- 你的数据存在了几个地方?
- 这些地方分布在全球哪些区域?
- 这些存储点已经稳定运行了多久?
这就像给你的数据装上了多个GPS追踪器,随时可查。
服务质量可量化,选择不再盲目
当你在考虑IPFS云存储设备价格对比2026时,价格只是其一,服务质量隐藏的成本(如丢失风险、取回速度慢)才是关键,大数据库使得这些服务指标变得可衡量:
- 节点信誉体系:基于历史行为(如掉线频率、存储违约次数)的打分。
- 性能基准数据:不同地区节点的平均延迟和带宽,业内共识认为,节点地域分布的多样性比单一区域的超高性能对长期可用性更为重要。
- 存储证明验证:部分网络会定期要求节点提交存储证明,证明其确实存储了声称的数据,这些验证结果也会记录在案。
驱动生态进化,激励优质服务
一个公开可查的数据库,让优质存储设备脱颖而出,劣质设备无处遁形,这直接推动了:
- 定价市场化:高信誉、高性能节点的服务可以合理溢价。
- 服务专业化:促使设备提供商从简单的“提供硬盘空间”转向提供“高可用、可验证、有保障的存储服务”。
- 网络健壮性:通过大数据分析,可以发现网络中的薄弱环节,激励更多节点在特定地域或网络拓扑中部署。
未来展望:从“存储查询”到“数据物流”
这个大数据库的价值远不止于“查询”,它正在成为下一代互联网Web3.0的数据基石,我们可以预见:
- 智能存储路由:当你上传数据时,系统能根据你的预算、对速度和冗余度的要求,自动通过数据库匹配最优的存储设备组合。
- 数据保险与金融衍生品:基于确凿的、可验证的存储状态数据,可以为重要数据承保,甚至衍生出基于数据可用性的金融产品。
- 跨链数据桥梁:在区块链生态中,IPFS常被用于存储链下大数据,这个数据库能为不同链上的应用提供统一、可信的数据状态查询入口。
IPFS云存储设备大数据库将看似分散、无序的全球存储资源,编织成一张可查询、可验证、可信任的价值网络,是数据从“被存储”迈向“被确权、被流通”的关键一步。
Q&A:关于IPFS设备与数据查询的常见疑问
IPFS数据怎么找回丢失文件?
真正的“丢失”在IPFS中(指文件彻底从全网消失)是罕见的,除非存储该文件所有副本的节点同时失效,找回流程通常是:1. 通过你持有的CID,在数据库或你的服务商后台查询剩余的存活副本位置,2. 如果服务商提供的是代管服务,且签署了服务等级协议(SLA),他们会有义务从其他备份或激励机制中恢复你的数据。对于极其重要的数据,用户自行在多地域、多服务商处保存副本是最佳实践。
家用设备可以参与IPFS存储赚钱吗?需要多大带宽?
可以,但通常不推荐普通家庭宽带用户以赚钱为主要目的参与,原因包括:1. 家用网络上行带宽窄(这是检索速度的关键),且IP地址常变动,服务质量不稳定,信誉积分难以积累,2. 需要设备24小时在线,电费和硬件损耗可能抵消收入,据统计,能稳定获得较好收益的设备,多部署在IDC机房,拥有公网IP和至少100Mbps以上的稳定上行带宽。参与网络贡献与获得稳定商业回报是两种不同的参与模式。
查询数据库是实时的吗?数据多久更新一次?
这不是一个“实时”的秒级更新系统,其更新频率取决于:1. 节点向网络宣告自身状态的周期(从几分钟到几小时不等),2. DHT(分布式哈希表)信息刷新需要时间在网络中传播,查询结果通常反映的是几分钟到一小时内的网络状态,对于存储状态监控,定期查询(如每天或每周)比依赖绝对实时性更为可靠和实际。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/535296.html