HBase数据读写示例程序的核心操作是Put和Get,通过Java API可以快速实现数据的写入和读取,掌握这些示例代码是HBase开发的基础。
HBase数据读写示例程序:Put与Get操作详解
HBase的读写操作分别对应Put和Get两个核心类,Put负责写入数据,Get负责查询数据,下面通过具体示例展示从单行操作到批量处理的基本用法。
Put写入示例:从单行到批量
单行写入是最简单的模式,先构造一个Put对象,指定行键,然后通过addColumn方法添加列族、列名和值,最后调用Table的put方法提交。
Put put = new Put(Bytes.toBytes("rowKey1"));
put.addColumn(Bytes.toBytes("cf"), Bytes.toBytes("name"), Bytes.toBytes("Alice"));
put.addColumn(Bytes.toBytes("cf"), Bytes.toBytes("age"), Bytes.toBytes("30"));
table.put(put);
当需要写入多条数据时,建议使用批量写入,将多个Put对象放入List中,调用table.put(List
List<Put> puts = new ArrayList<>();
puts.add(new Put(Bytes.toBytes("row1")).addColumn(/.../));
puts.add(new Put(Bytes.toBytes("row2")).addColumn(/.../));
table.put(puts);
在HBase Java API写入示例中,批量操作是常规推荐做法,需要注意,如果批量中某条失败,整批是否会回滚取决于配置,通常建议将一批数据控制在合理大小,避免占用过多内存。
Get读取示例:精确查询与范围扫描
精确查询使用Get对象,指定行键即可获取整行数据,也可以指定列族和列来缩小返回量。
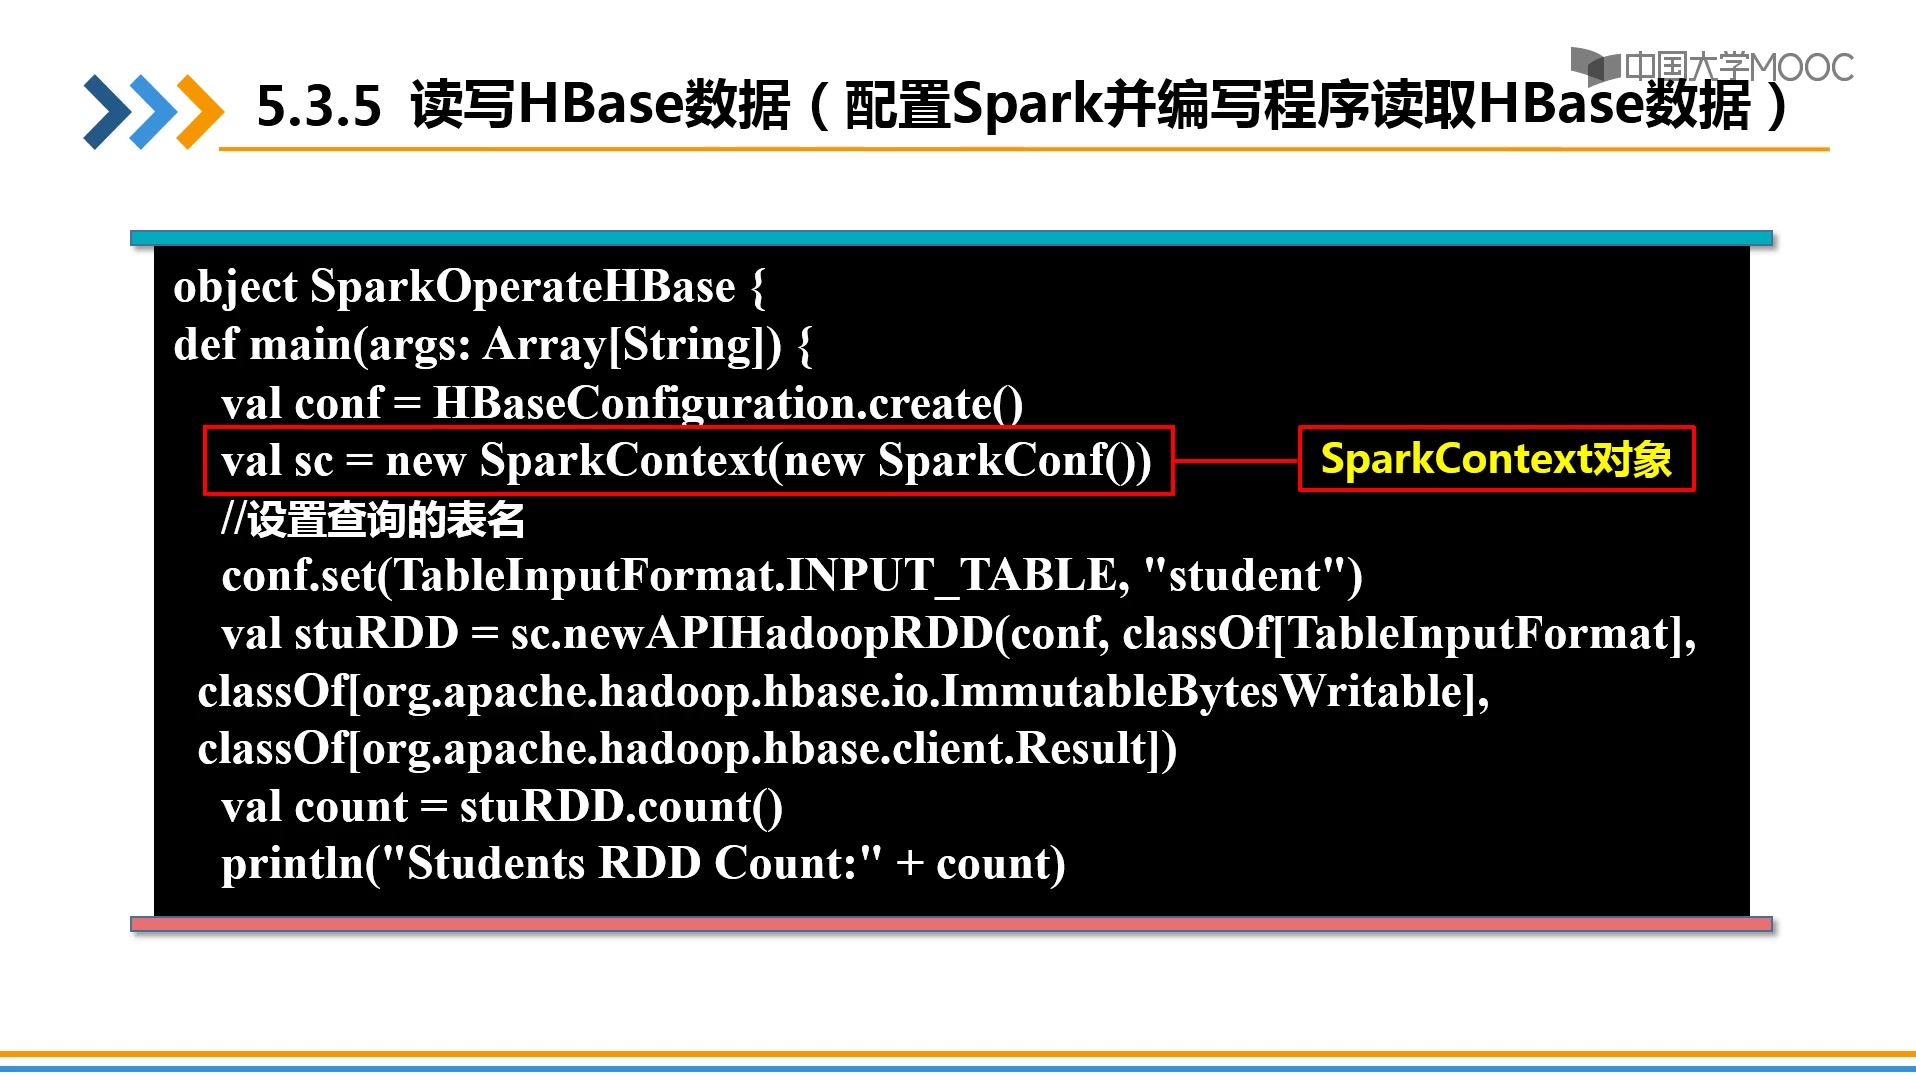
Get get = new Get(Bytes.toBytes("rowKey1"));
get.addColumn(Bytes.toBytes("cf"), Bytes.toBytes("name"));
Result result = table.get(get);
byte[] value = result.getValue(Bytes.toBytes("cf"), Bytes.toBytes("name"));
范围扫描则使用Scan对象,通过设置起始行和结束行,可以获取一个区间的多行数据,Scan还支持过滤器(如PrefixFilter、FilterList)来实现更精细的过滤。参考2
Scan scan = new Scan();
scan.setStartRow(Bytes.toBytes("row1"));
scan.setStopRow(Bytes.toBytes("row3"));
ResultScanner scanner = table.getScanner(scan);
for (Result r : scanner) {
    // 处理每一行
}
scanner.close();
扫描后必须关闭ResultScanner,否则会占用RegionServer资源,这是HBase读写操作代码示例中容易忽略的细节。
HBase存储示例:批量写入与读取优化
实际生产环境中,单条读写往往无法满足性能要求,批量写入和读取优化是HBase存储示例中最常被关注的部分,直接关系到系统吞吐量。
批量写入:提升吞吐量的关键
除了上述table.put(List)方式,还可以使用BufferedMutator,它内部维护一个写缓冲区,当缓冲区满或达到一定时间后自动批量提交,适合持续写入的场景。
BufferedMutator mutator = connection.getBufferedMutator(tableName);
mutator.mutate(put);
mutator.flush(); // 手动刷出
批量写入可以显著减少RPC调用次数,据统计,当数据量较大时,批量写入的吞吐量可能是逐条写入的5倍以上(具体数值因环境而异),但也要注意,批量大小不宜过大,否则可能触发RegionServer的写压力,导致RegionTooBusyException,建议根据Row大小和网络条件调整,一般每批1000-5000条较为常见。
读取优化:合理使用Scan缓存
Scan默认每次只从服务器拉取一行,导致大量小包交互,通过setCaching()设置缓存行数,可以一次拉取多行,减少网络往返。
scan.setCaching(500); // 一次拉取500行
缓存行数越大,查询越快,但会占用更多客户端内存。
行业共识认为,对于RowKey均匀分布的场景,设置1000左右的缓存是一个平衡点,使用过滤器(如SingleColumnValueFilter、PageFilter)可以在服务端提前过滤,避免传输无用数据。参考2
HBase读写操作代码示例:Java API 实战
下面是一个完整的示例,从创建表到写入数据,再到读取和删除,涵盖HBase读写操作代码示例的主要步骤。
完整示例:从创建表到数据读写
import org.apache.hadoop.conf.Configuration;
import org.apache.hadoop.hbase.;
import org.apache.hadoop.hbase.client.;
import org.apache.hadoop.hbase.util.Bytes;
public class HBaseDemo {
    public static void main(String[] args) throws Exception {
        Configuration conf = HBaseConfiguration.create();
        conf.set("hbase.zookeeper.quorum", "localhost:2181");
        try (Connection conn = ConnectionFactory.createConnection(conf);
             Admin admin = conn.getAdmin()) {
            TableName tableName = TableName.valueOf("test_table");
            // 创建表
            if (!admin.tableExists(tableName)) {
                TableDescriptor desc = TableDescriptorBuilder.newBuilder(tableName)
                        .setColumnFamily(ColumnFamilyDescriptorBuilder.of("cf"))
                        .build();
                admin.createTable(desc);
            }
            // 写入数据
            try (Table table = conn.getTable(tableName)) {
                Put put = new Put(Bytes.toBytes("row1"));
                put.addColumn(Bytes.toBytes("cf"), Bytes.toBytes("col1"), Bytes.toBytes("value1"));
                table.put(put);
                // 读取数据
                Get get = new Get(Bytes.toBytes("row1"));
                Result result = table.get(get);
                System.out.println(Bytes.toString(result.getValue(Bytes.toBytes("cf"), Bytes.toBytes("col1"))));
            }
            // 删除表(可选)
            // admin.disableTable(tableName);
            // admin.deleteTable(tableName);
        }
    }
}
代码中使用了try-with-resources自动关闭资源,这是推荐做法,Connection是重量级对象,应全局复用,不要每次操作都创建。
常见错误与调试
- ZooKeeper连接失败:检查hbase.zookeeper.quorum配置是否正确,端口是否开放。
- RegionTooBusyException:通常由写入超出RegionServer处理能力引起,可增大写缓冲区或增加Region数量。
- Scan没有结果:检查StartRow和StopRow的设置,注意行键是字节数组,比较是字典序。
- 表不存在异常:确认表名正确,且已经创建。
通过上述示例,你可以快速掌握HBase数据读写的基本方法,在实际项目中,结合批量操作、缓存优化和合理的表设计,能更好地发挥HBase在大数据场景下的存储优势。
HBase数据读写示例程序常见问题解答
问题1:HBase读写示例中如何连接HBase集群?
需要配置ZooKeeper地址,通过HBaseConfiguration创建Configuration对象,然后调用ConnectionFactory.createConnection获取连接,示例代码中已包含具体配置方式,注意Connection是线程安全的,应在整个应用生命周期内复用。
问题2:批量写入时出现RegionTooBusyException怎么办?
可以尝试增大写缓冲区大小(通过BufferedMutator的setWriteBufferSize),或增加客户端重试次数,如果问题持续,说明RegionServer写入压力过大,建议通过预分区或增加RegionServer实例来分摊负载。
问题3:使用Scan扫描时如何设置缓存?
通过Scan.setCaching(int)设置一次远程调用返回的行数,默认值1,建议根据行的大小和可用内存调整,通常设置100到2000之间,注意,扫描完成后需要调用ResultScanner.close()释放资源,否则可能导致RegionServer端连接泄漏。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/532630.html