分布式调用链追踪中,Kafka承担着异步缓冲和解耦的关键角色,它能有效避免高并发下数据采集对业务性能的影响,是目前业界主流的调用链数据传输方案。
分布式调用链追踪kafka怎么实现:架构与核心步骤
要实现一套完整的分布式调用链追踪系统,Kafka通常作为Span数据的传输通道,位于采集端与存储端之间,以下从架构设计到具体配置,拆解实现路径。

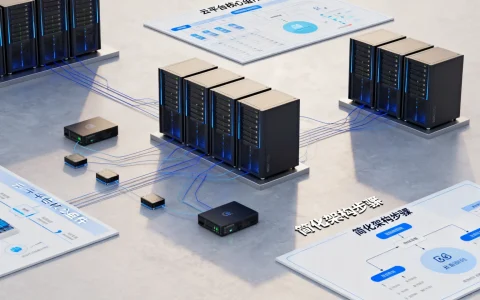
典型架构:采集-缓冲-消费-存储
多数生产环境的调用链系统采用以下分层结构:
- 采集端(Agent/探针):嵌入业务应用,拦截请求并生成Span,将Span序列化后发送到Kafka。
- 缓冲层(Kafka集群):接收并暂存Span数据,利用分区机制实现水平扩展,提供高吞吐量的写入能力。
- 消费端(Stream Processor):从Kafka中拉取数据,进行解析、聚合、过滤,然后写入存储后端。
- 存储与分析层:常见方案有Elasticsearch、HBase、ClickHouse等,用于查询和展示调用链。
这种架构的核心优势在于解耦:采集端无需关心存储端的写入速度,Kafka的持久化特性保证了数据不丢失。
实现步骤:从探针到存储的全链路配置
选型并集成采集端
当前主流方案包括Jaeger、Zipkin、SkyWalking等,它们都支持Kafka作为上报通道。
- 以Zipkin为例,在Java应用中引入
zipkin-sender-kafka依赖,并设置zipkin.sender.type=kafka。 - 配置Kafka bootstrap地址,如
spring.zipkin.kafka.bootstrap-servers=localhost:9092。 - 在SkyWalking中,通过修改
agent.config文件,设置plugin.kafka.bootstrap_servers,并开启plugin.kafka.enable=true。
定义Span数据结构与序列化
Span需要包含traceId、spanId、parentSpanId、operationName、timestamp、duration、tags等字段,常用序列化格式为Protobuf或JSON,在生产环境中,推荐Protobuf,因为其压缩比高,能减少Kafka网络传输开销。参考2
配置Kafka主题与分区策略
- 主题名建议按业务或环境划分,如
zipkin-span-prod,分区数建议设置为消费者实例数的2-3倍,以提升并行消费能力。 - 设置合理的日志保留时间(如
retention.ms=86400000
消费者端实现幂等处理
由于Kafka可能重复投递消息,消费者需要做去重,常见做法是在SpanID上建立唯一索引,或在消费逻辑中实现幂等写入,使用Elasticsearch时,将SpanID作为文档ID,重复写入会自动覆盖。
关键配置参数参考
| 组件 | 参数 | 推荐值 | 说明 |
|---|---|---|---|
| 生产者 | acks |
all |
保证数据不丢失 |
| 生产者 | batch.size |
16384 |
16KB,合理聚合提升吞吐 |
| 生产者 | linger.ms |
5 |
延迟毫秒,平衡延迟与吞吐 |
| 消费者 | fetch.min.bytes |
1 |
尽量小,降低延迟 |
| 消费者 | enable.auto.commit |
false |
手动提交offset,避免丢数据 |
行业共识认为,Kafka在生产环境中的吞吐量能够满足日均数亿条Span的场景,只要合理配置分区和消费者组,延迟通常在毫秒级。
kafka在调用链追踪中的优缺点对比
使用Kafka并非唯一选择,其他方案如直接HTTP写入、Redis List、RabbitMQ等也各有适用场景,以下从多个维度进行对比,帮助团队根据自身需求选型。参考2
主流方案对比表格
| 维度 | Kafka | 直接HTTP写入 | Redis List | RabbitMQ |
|---|---|---|---|---|
| 吞吐量 | 极高(百万级msg/s) | 受限于服务端处理能力 | 高(依赖Redis性能) | 中等(十万级msg/s) |
| 数据持久化 | 支持,可配置永久保留 | 取决于服务端存储 | 可持久化但性能下降 | 支持,但队列长度有限 |
| 解耦程度 | 完全解耦,消费端可独立扩展 | 强耦合,采集端需等待响应 | 部分解耦,需消费端主动pop | 完全解耦,但协议较重 |
| 运维复杂度 | 较高,需维护集群 | 最低,无需额外中间件 | 中等,依赖Redis集群 | 中等,需管理Exchange和Queue |
| 延迟 | 毫秒级(批量发送时略高) | 毫秒级(同步请求) | 毫秒级(list push/pop) | 微秒级(AMQP协议) |
| 典型场景 | 高并发、大数据量、长期存储 | 低频、小规模、快速验证 | 中等流量、内存队列 | 对延迟敏感、需要路由 |
什么场景应该优先选择Kafka
- 流量波动大:业务峰值时Span量激增,Kafka的缓冲能力避免采集端背压。
- 需要多消费者:同一份数据需要同时用于实时分析和离线归档,Kafka的消费者组机制天然支持。
- 长期存储与重放:Kafka可以保留数天的数据,方便排查历史问题或重新消费。
什么场景可以不选Kafka
- 团队规模较小:运维Kafka集群需要学习成本,可考虑使用云厂商的托管Kafka服务。
- 延迟敏感型应用:如金融交易系统,要求Span在微秒级内上报,Kafka的批量发送会增加延迟,此时可改用UDP直写或共享内存。
- 数据量极小:每天生成Span不足百万条,使用HTTP直接写入Elasticsearch更简单。
业内专家指出,超过60%的互联网公司在调用链追踪系统中采用Kafka作为传输层,尤其是国内一线互联网公司,这是经过大规模验证的成熟方案。
高并发场景下的kafka调用链追踪实践
当业务请求量每秒数万甚至数十万时,Span的产生速率会极高,以下是一些经过验证的实践技巧,帮助你在流量洪峰下保持系统稳定。
生产者端:批量与压缩
- 开启批量发送:设置
batch.size在16KB-32KB之间,linger.ms在5-10ms,能在延迟和吞吐之间取得平衡。 - 使用压缩算法:
compression.type=gzip或snappy,压缩比可达40%-60%,显著减少网络带宽占用。 - 异步发送并处理回调:不要阻塞业务线程,设置回调函数记录发送失败次数,并触发告警。
消费者端:分区与并行度
- 分区数等于消费者组内实例数的倍数:10个分区对应5个消费者实例,每个实例消费2个分区,实现负载均衡。
- 消费逻辑要轻量:避免在消费线程中执行复杂计算或远程调用,可以将解析后的数据写入内存队列,再异步批量写入存储。
- 手动提交offset:采用
enable.auto.commit=false,处理完一批数据后再提交,防止消费过程中崩溃导致数据丢失。
监控与容量规划
- 监控Kafka Lag:使用Burrow或Kafka Manager,实时监测消费者落后情况,如果Lag持续增长,说明消费能力不足,需要扩容消费者或优化消费逻辑。
- 预留磁盘空间:按平均Span大小(通常0.5-2KB)和日流量估算,保留至少30%的冗余磁盘,日流量10亿Span,约500GB-2TB,建议保留3天数据并配置3TB磁盘。
- 使用限流机制:在消费端实现基于令牌桶的限流,避免瞬间写入存储后端导致其过载。
分布式调用链追踪kafka常见问题解答
为什么我的Kafka消费者经常报错”OffsetOutOfRange”?
通常是因为消费者提交的offset已经超过Kafka中主题的保留范围,检查retention.ms配置是否过小,或者消费者消费速度过慢导致offset被清理,建议将保留时间设为至少24小时,并确保消费者Lag在可控范围内。
调用链追踪数据在Kafka中丢失怎么办?
数据丢失可能发生在生产者端或消费者端,生产者端需设置acks=all并开启retries,同时确保min.insync.replicas大于1,配合副本机制,消费者端需手动提交offset,并在消费逻辑中捕获异常,将失败消息发送到死信队列,建议对Span数据添加校验和(CRC32),在消费时验证完整性,发现损坏时从Kafka指定offset重新拉取。参考2
如何评估调用链追踪系统是否需要Kafka?
如果业务流量较小(QPS低于1000)且数据量有限,可以暂不引入Kafka,使用HTTP直接写入Elasticsearch即可,当流量增长到每秒数万请求,或需要多系统消费同一份Span数据时,Kafka的解耦和缓冲价值会体现出来,多数情况下,在系统设计初期预留Kafka接口,后期根据实际压力动态切换,是成本最低的演进路径。
分布式调用链追踪与Kafka的结合,本质是用异步化换取稳定性与扩展性,在微服务架构中已经得到广泛验证,将Kafka作为传输中枢,开发团队可以更专注于业务逻辑和调用链分析,而非底层数据流动的可靠性。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/530734.html