Python 中的 .apply 方法主要用于对 pandas 的 DataFrame 或 Series 按行或列应用自定义函数,但在数据量较大时,其性能可能不如向量化操作,实际使用时需根据场景权衡。 它之所以被广泛使用,是因为它提供了极大的灵活性,允许你执行任何复杂的逻辑,但代价是循环效率,本文将从基础用法、性能对比、常见坑点以及实战案例几个层面,帮你彻底掌握 .apply。
python apply 函数用法详解
基础语法与参数
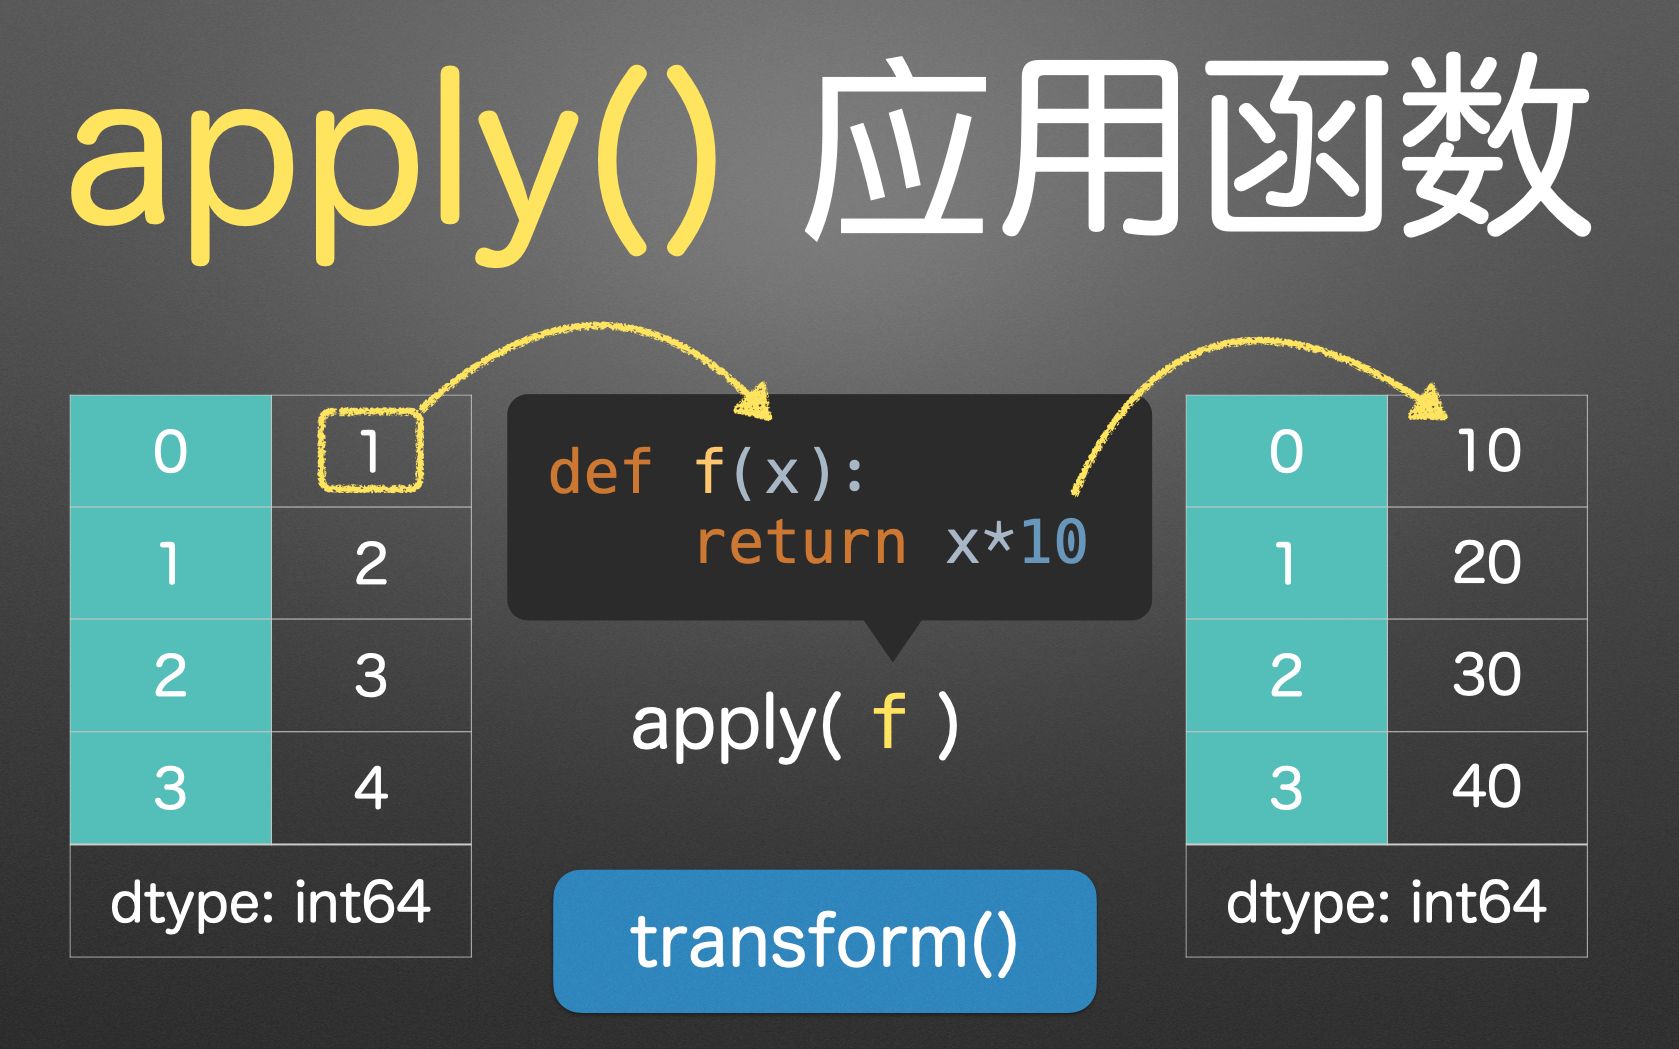
.apply 的核心是传入一个函数,并指定 axis 参数,对于 DataFrame,axis=0 表示按列应用(逐列传入 Series),axis=1 表示按行应用(逐行传入 Series),对于 Series,axis 参数无效,直接对每个元素应用函数。

import pandas as pd
df = pd.DataFrame({'A': [1,2], 'B': [3,4]})
# 按列求和,返回 Series
df.apply(sum, axis=0)
# 按行求和,返回 Series
df.apply(sum, axis=1)
axis 参数的理解误区
初学者常将 axis=0 理解为“按行”,行业共识是 axis=0 代表“跨行”即按列操作,你可以通过一个简单的测试来验证:传入一个打印形状的函数,观察传入的是 Series 还是 DataFrame 片段。
返回值类型
.apply 的返回值类型取决于你传入函数的返回类型,如果函数返回标量,则结果是一个 Series(按行或列汇总);如果函数返回 Series,则结果是一个 DataFrame,这种灵活性让其成为“瑞士军刀”,但也容易导致类型混乱。
apply 与 map 和 applymap 的区别
适用对象不同
- map:仅用于 Series,对每个元素进行映射,支持字典或函数。
- applymap:仅用于 DataFrame,对每个元素进行映射,常用于格式化。
- apply:可用于 Series 和 DataFrame,支持按行/列或元素级操作(通过自定义函数返回标量或 Series)。
性能差异
多数情况下,map 的速度比 apply 略快,因为它更底层,applymap 在元素级操作时也常被向量化操作替代,如果你需要处理单个元素,优先考虑 map 或向量化,而不是 apply。
使用场景选择
- 需要跨行或跨列计算(如计算每行标准差)-> 用 apply。
- 仅对单个 Series 做映射 -> 用 map。
- 对 DataFrame 每个元素做格式化 -> 用 applymap 或直接向量化。
- 需要同时访问多列做复杂逻辑 -> 常用 apply 传入 axis=1。
pandas apply 性能对比与优化
为什么 apply 慢
.apply 本质上是一个 Python 级别的循环,每次迭代调用自定义函数,导致大量类型检查和函数调用开销,当数据量达到几十万行时,速度会明显劣于 numpy 向量化操作,据行业共识,在处理 100 万行数据时,apply 所需时间通常是向量化操作的数十倍。
向量化替代方案
- 使用 numpy 的 ufunc 或 pandas 内置的矢量化函数(如 df[‘col1’] + df[‘col2’])。
- 对于条件逻辑,用 np.where 或 np.select 替代 apply。
- 对于分位数等分组统计,用 groupby transform 配合内置函数。
使用 swifter 或 numba 加速
如果必须使用 apply,可以尝试 swifter 库,它自动判断是否并行化,对于数值计算,用 numba 装饰器结合 apply 能显著提升速度,但注意,numba 对函数类型有限制,需提前测试。
实操建议
- 先用小数据集测试逻辑,确保 apply 函数正确。
- 数据量超过 10 万行时,优先考虑向量化改写。
- 若无法避免,将 apply 用于分组后的 groupby apply,利用隐式分组加速。
python apply 常见报错与解决
TypeError: ‘xxx’ object is not callable
原因:传入的 apply 参数不是一个可调用对象,比如传入了一个字符串或数字,检查你的函数名是否被覆盖,或 lambda 是否写错。
ValueError: Shape of passed values is mismatched
多见于 apply 返回的 Series 长度不一致,例如按行应用时,函数返回了不同长度的列表,确保函数返回的结果长度与行数或列数匹配。
解决思路
- 打印函数内部的输入,确认形状和类型。
- 使用
result_type='expand'参数,让 pandas 自动展开列表。 - 对于复杂逻辑,先定义独立函数,逐行调试。
实战案例:apply 处理多列数据
案例1:自定义函数计算新列
假设需要根据每行的年龄和收入计算评分等级,可以用 apply 快速实现。
def score(row):
    if row['age'] > 30 and row['income'] > 50000:
        return 'A'
    elif row['age'] > 30:
        return 'B'
    else:
        return 'C'
df['score'] = df.apply(score, axis=1)
案例2:应用复杂逻辑
当需要模型预测或字符串拼接时,apply 依然是最直观的选择,比如将多列文本合并为一列,并加入标点符号。
案例3:结合 groupby 使用
在分组后对每组数据应用函数,groupby.apply 是常见的操作,例如计算每个城市销量最高的商品类别,注意 groupby.apply 会返回一个 DataFrame,且索引可能重复,需要用 reset_index 清理。
python apply 常见问题 QA
问题1:apply 和 map 在 pandas 中究竟有何不同?
apply 可作用于 DataFrame 和 Series,支持按行/列处理,允许返回标量或 Series;map 仅作用于 Series,且只能返回标量,当需要操作多列时,必须用 apply;单列映射时,map 通常更快。
问题2:为什么我的 apply 运行很慢?
apply 的本质是 Python 循环,对于大数据集效率较低,建议先检查数据量,如果超过 10 万行,尝试用向量化或 swifter 库加速,也可以使用 pandas 内置的 eval 或 query 方法进行快速计算。
问题3:如何在 apply 中访问多列?
在 axis=1 模式下,传入函数的是一个 Series,你可以通过列名索引,row['col1'],确保函数内部不需要修改原始数据,否则建议先复制 DataFrame,Q&A 最后一个答案直接以事实结尾。
掌握 .apply 的核心在于理解其灵活性与性能代价,在合适场景用它解决问题,同时也要知道何时放弃它改用更高效的方案,这是每个 Python 数据分析者必须跨过的门槛。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/510448.html