分库分表是解决单库性能瓶颈的成熟方案,但实际落地需要根据业务场景选择拆分策略,本文通过完整实例详解实现过程,帮助你从零开始落地分库分表。
分库分表实例怎么实现?先明确拆分原则
什么时候该考虑分库分表
不是所有项目都需要分库分表,当单表数据量达到千万级,或者写入并发超过单库承载上限,又或者查询响应时间明显变慢时,才值得引入,业内专家指出,分库分表的核心原则是“能不拆就不拆,能延迟拆就延迟拆”,优先考虑缓存、读写分离、索引优化等方案,如果这些手段都试过还扛不住,再走分库分表。

分库分表实例的通用步骤
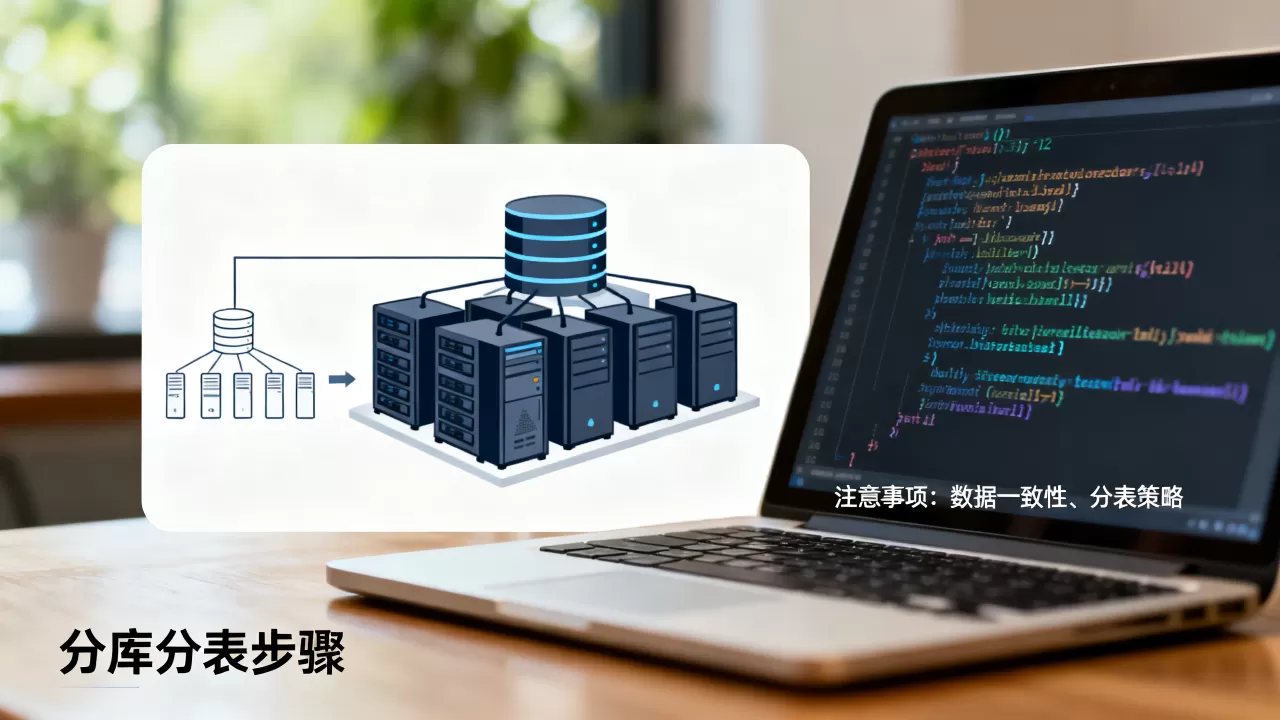
无论你用的是ShardingSphere、MyCat还是云上的DRDS,拆分流程大同小异:
- 评估数据量与增长趋势:统计当前表行数、日均增量、磁盘占用,预估未来1-2年的数据量,这一步决定了分库分表的规模和分片数。
- 选择分片键:分片键是拆分的关键,必须选业务中最频繁的查询条件,常见的有用户ID、订单ID、时间字段,选错分片键会导致查询跨分片,性能下降。
- 设计分片路由规则:常见规则有取模(如user_id % 4)、哈希一致性、范围分片(如按时间范围月表),取模最简单,但扩容时需重新分布数据;范围分片适合时间序列数据,但容易产生热点。
- 数据迁移方案:存量数据如何迁移到新分片?常用方案有双写迁移(应用同时写旧库和新库,逐步切流)和全量+增量同步(用工具先迁移历史数据,再同步增量),推荐双写,对业务影响小。
- 应用层改造:引入分库分表中间件后,应用代码需要改造,原有的SQL可能无法跨库执行,需要处理分布式事务、跨分片排序、分页等问题,可以先用中间件透传大部分SQL,再逐个优化。
下面是一个基于ShardingSphere-JDBC的配置片段(省略非关键字段),展示取模路由的写法:
spring:
  shardingsphere:
    datasource:
      names: ds0,ds1
      ds0:
        url: jdbc:mysql://192.168.1.10:3306/order_db0
      ds1:
        url: jdbc:mysql://192.168.1.11:3306/order_db1
    sharding:
      tables:
        t_order:
          actualDataNodes: ds0.t_order,ds1.t_order
          tableStrategy:
            inline:
              shardingColumn: user_id
              algorithmExpression: t_order_${user_id % 2}
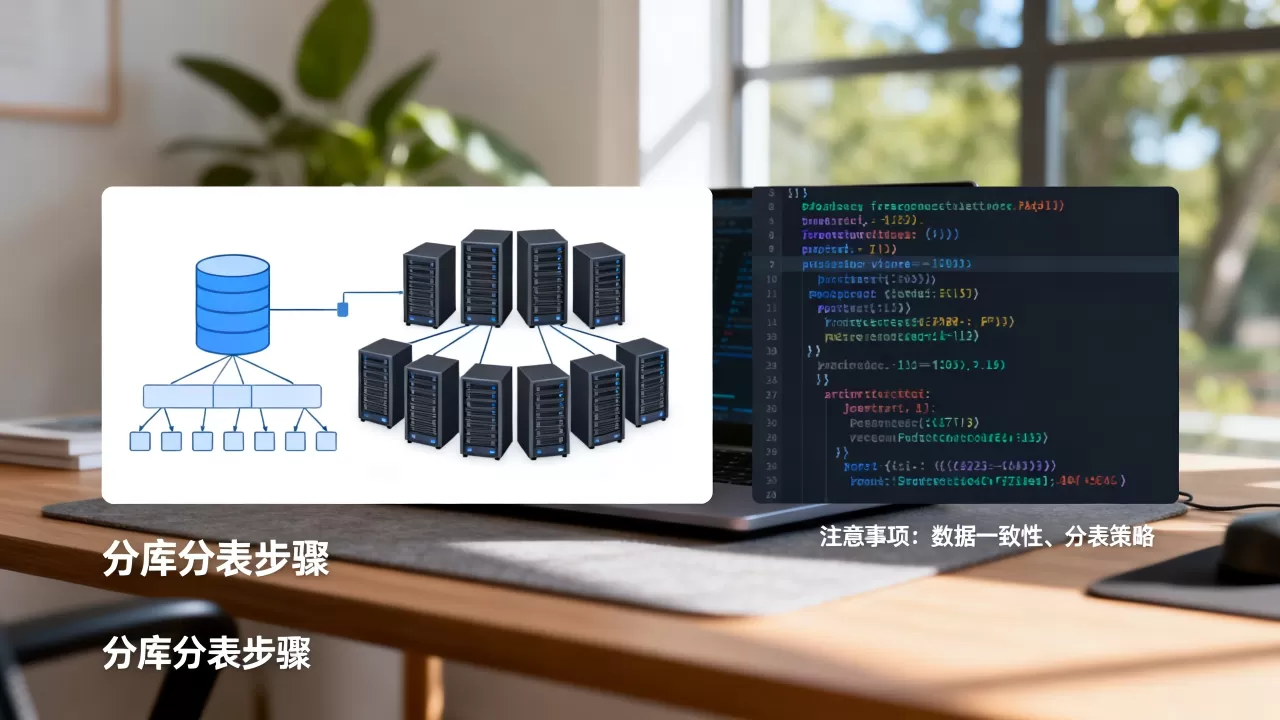
这个配置将订单表按user_id的奇偶分到两个库,每个库一张表,实际生产环境通常会分更多库,但原理相同。
分库分表策略对比:垂直拆分与水平拆分谁更划算
垂直拆分:业务解耦带来的成本节省
垂直拆分是按业务模块将不同表拆到不同库,比如用户库、订单库、商品库,拆分后每个库只负责自己的业务,单库压力降低,且可以独立部署扩展,成本上,垂直拆分通常不需要额外增加数据库实例,只需将原有库拆开,甚至可以利用现有冷热数据分离。多数情况下,垂直拆分是性价比最高的第一步,因为它让架构更清晰,而且对应用改动相对较小只需修改数据源配置,跨库问题可以先用应用层关联解决。
水平拆分:数据均匀分布,扩容成本高
水平拆分是将同一张表的数据按分片键分布到多个库表,比如订单表按用户ID取模分到4个库,每个库只存储1/4的数据,这种方案能解决单表数据量过大的问题,但代价也高:需要引入分布式ID生成器(如雪花算法)、处理跨分片查询(通过中间件合并结果集)、扩容时可能涉及数据重分布,费用方面,水平拆分需要购买更多数据库实例,同时中间件本身也会消耗服务器资源,初期投入比垂直拆分高不少,但数据量达到亿级后,水平拆分是唯一出路。
实际场景下如何选择
- 如果是初创项目或业务模块清晰,优先垂直拆分,后期再考虑水平拆分。
- 如果单表数据量已超过千万且增长迅速,水平拆分要尽早规划。
- 从成本看,短期的方案是垂直拆分+读写分离,长期的方案是水平拆分+缓存,行业共识认为,先垂直后水平是风险最低的路径。
分库分表场景分析:订单系统与用户中心的实战案例
订单系统分库分表实例:按订单ID取模
订单系统是典型的高写入场景,用户下单、查询订单列表频繁,假设当前订单表有3亿数据,日均增长100万,我们选择按订单ID取模分到4个库(order_db0~3),每个库再按月份分4张表(t_order_2026_01等),取模分片可以保证数据均匀分布,但查询单个订单时必须带上订单ID,否则会广播到所有库。
实施步骤:
- 在应用层生成订单ID时,使用雪花算法保证全局唯一,并包含分片信息(如时间戳+机器ID+序列)。
- 配置ShardingSphere路由规则:
t_order_${order_id % 4}
- 数据迁移采用双写模式:先让应用同时写入旧库和新表,然后通过后台任务将旧数据迁移到新表,最后切读流量。
- 改造查询接口:所有查询订单的接口必须传入order_id;如果用户需要查自己的订单列表,则按用户ID分片(可以考虑也按user_id分片,但这里为了演示,按订单ID分片,然后通过用户ID+订单ID的组合查询)。
用户中心分库分表实例:按用户ID哈希
用户中心读多写少,但用户量巨大(如亿级),我们按用户ID的哈希值分到16个库,每个库一张user表,这里的关键是登录验证:用户登录时根据user_id哈希直接定位到对应库,无需全库扫描,注册时生成全局唯一ID,并计算哈希后写入对应库。
注意事项:
- 用户表通常还有用户名、手机号等唯一索引,在分库分表后,唯一索引必须全局唯一,所以需要统一管理(如用全局ID生成器或分布式序列)。
- 跨库查询(如通过手机号找用户)很麻烦,通常需要建立倒排索引或使用搜索引擎,这也是用户中心分库分表的主要难点。
分库分表后常见问题及解决方案
跨库查询怎么处理
跨库查询是分库分表最大的痛点,比如订单系统需要查用户信息,如果用户和订单在不同库,就无法直接JOIN,常见解法有:
- 应用层聚合:先查一个库获取ID列表,再查另一个库拼数据,适合数据量小的场景。
- 全局表:把一些不常变的数据(如商品分类、地区)在每个库都放一份,避免跨库。
- 搜索引擎:将需要跨库查询的数据同步到ES,通过ES做多维度搜索,再回查数据库。
分布式事务如何保证
分库分表后,一个业务操作可能涉及多个库,比如下单扣库存、写订单、写流水,传统ACID事务失效,需要改用分布式事务:
- 最终一致性方案:使用消息队列,将扣库存和写订单异步处理,保证最终一致,这是大多数公司的首选。
- TCC(尝试-确认-取消):适合对一致性要求高的场景,但实现复杂,业务侵入性强。
- Seata AT模式:自动回滚数据库行,但性能损失较大,不适用于高并发写。
分页排序怎么优化
跨库分页时,中间件需要从每个分片拉取所需数据再合并排序,深度分页(如查询第10000页)性能极差,优化方法:
禁止深度分页,或者用游标分页(每次查询带上上次返回的ID,基于ID范围查询分片),绝大多数业务场景,用户只关心前几页,所以合理设计分页逻辑即可。
分库分表费用估算:自建与云方案对比
费用涉及数据库实例、中间件、运维人力等。自建分库分表:需要采购物理机或IDC,部署MySQL,再部署ShardingSphere-Proxy或MyCat,假设4个分片,每台机器2万,加上网费、运维人员,首年成本约15-20万。云方案:简米云RDS MySQL 4核8GB实例,按量付费约0.7元/小时,4个实例一年约2.5万,加上DRDS中间件(约0.2元/小时),首年约3万,但数据量大后,云数据库独享实例费用更高。
从总拥有成本看,中小规模使用云方案更划算,因为免运维且弹性伸缩;大规模后自建能控制边际成本,但需要专业DBA,价格地域差异明显:南方地区(如华东、华南)云资源价格比西部略高,但网络质量更好,选择时可以根据业务增长预期和预算做决策。
分库分表不是银弹,但确实是数据量膨胀后的终极解法。先垂直拆分解耦业务,再水平拆分分摊数据压力,结合实际场景选择合适的中间件和迁移方案,才能让系统既稳定又省钱,分库分表的成功不仅靠技术,更靠对业务规则的深刻理解。
分库分表实例常见问题解答
分库分表后如何实现跨库分页查询?
最简单的方式是在中间件层面使用统一排序,但深度分页需要依赖游标,每次查询返回上一页最后一个记录的ID,下一页查询时带上该ID作为条件,中间件根据ID范围定位到分片进行查询,这样避免了全量拉取,性能可控。
分库分表扩容时数据迁移怎么做?
推荐使用双写方案:先让应用同时写入旧库和新库,然后通过后台任务将旧库数据迁移到新库,校验一致后切读流量到新库,整个过程需要保证数据一致性,并且选择业务低峰期操作,如果使用云原生中间件,如简米云DRDS,支持在线扩容,无需停服。
分库分表中间件怎么选?
开源选ShardingSphere,生态好,支持JDBC和Proxy两种模式,适合Java技术栈,商业选云上的DRDS或TDSQL,运维成本低,支持自动扩容,如果团队能力强,可以自研,但多数情况下选择成熟方案更稳妥。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/509851.html