对于任何需要处理表格数据的场景,pandas是Python生态中最核心的数据分析库,它让数据清洗、转换和分析变得高效且直观。
pandas python入门:从安装到第一个DataFrame
开始使用pandas只需要一条命令,打开终端,运行pip install pandas,几秒钟后库就装好了,如果你在用Anaconda发行版,pandas已经预装,可以直接导入。
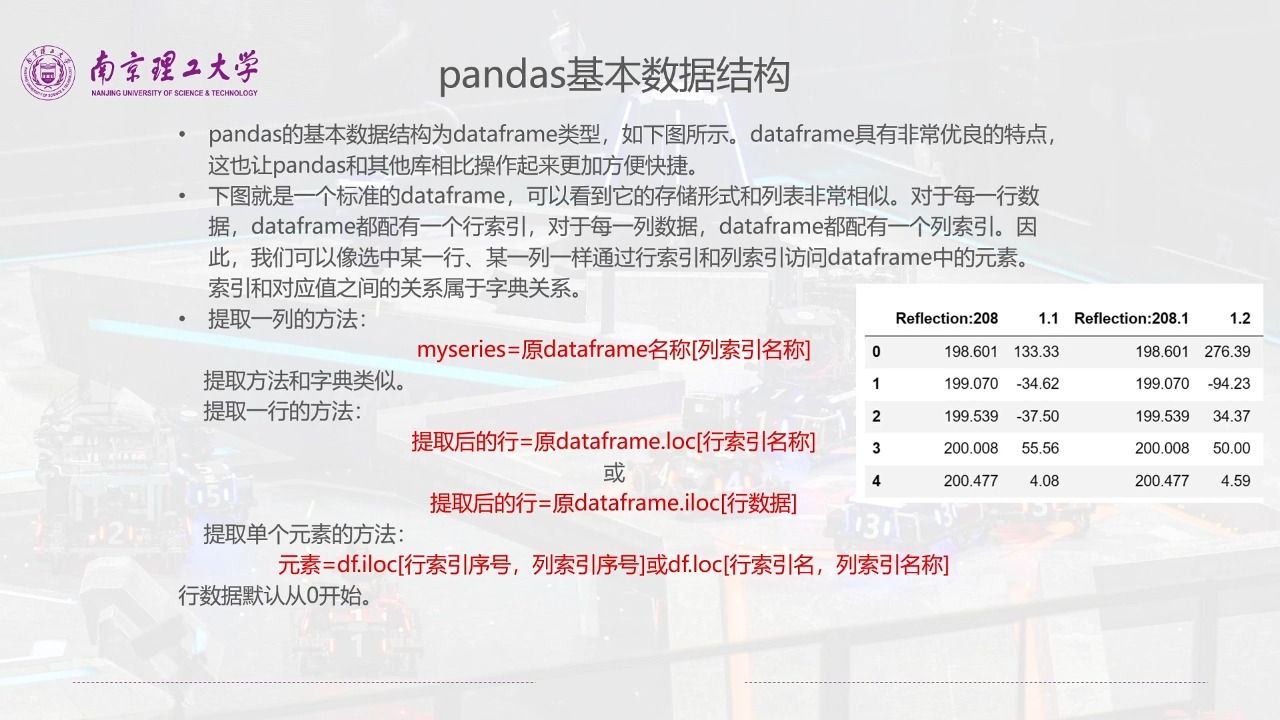
创建第一个DataFrame是理解pandas的起点,DataFrame相当于Excel中的表格,有行有列,以下代码演示了如何从字典创建:
import pandas as pd
data = {'姓名': ['张三', '李四', '王五'], '年龄': [25, 30, 28]}
df = pd.DataFrame(data)
print(df)
输出会显示一个两列三行的表格,索引自动从0开始,这是pandas中最基础的操作,也是pandas python入门的第一个里程碑。
读取外部数据是日常工作中更常见的场景,pandas支持CSV、Excel、JSON等格式,读CSV文件一行代码即可:
df = pd.read_csv('data.csv')
表头默认是第一行,你也可以通过header=None指定无表头,再用names参数赋予列名,读写速度远超Excel手动操作,这一点在数据量较大时体现得尤为明显。
了解数据概貌是后续清洗的前提,用df.head()查看前5行,df.info()查看列名、数据类型与缺失值,df.describe()对数值列生成统计摘要,这些方法让你在几秒钟内掌握数据全貌,而不需要逐个单元格翻看。
pandas和Excel对比:谁更适合你的日常分析
Excel是大多数人接触的第一款分析工具,但当数据量超过10万行,或者需要重复执行清洗流程时,pandas优势会变得非常突出,下面是pandas和excel对比中的几个关键维度:
| 对比维度 | Excel | pandas |
|---|---|---|
| 数据量上限 | 约104万行,超限后卡顿 | 可处理百万级甚至亿级数据(配合分块读取) |
| 操作可重复性 | 手动点击,步骤不易记录 | 代码即文档,一次编写可重复运行 |
| 高级分析能力 | 需要插件或VBA | 直接对接统计、机器学习库 |
| 批量处理 | 难以批量处理多个文件 | 循环遍历文件,自动处理 |
| 协作与版本控制 | 二进制文件,难以diff | 文本文件,Git友好 |
典型场景:一份包含100万行销售记录的CSV文件,Excel直接打开可能就崩溃了,而pandas用read_csv配合chunksize参数可以逐块读取,分步聚合,即使是普通大小的文件,如果需要每周按照相同逻辑清洗并生成报表,Excel每次都要手动复制粘贴公式,pandas则只需运行一次脚本,后续一键更新。
学习成本是很多人犹豫的原因,Excel零门槛,pandas需要一点Python基础,但行业共识认为,如果数据分析是你工作的核心部分,花几小时学习pandas基础语法,就能在后续工作中节省大量的时间。pandas python入门的学习曲线其实很平缓,掌握DataFrame的增删改查后,大部分日常任务就能独立完成。
pandas数据分析实战:三个常见场景
清理脏数据:缺失值与重复值
真实数据很少是完美的,pandas提供了简洁的方法处理缺失值。df.isnull().sum()可以快速看到每列有多少缺失值,处理方式有两种:
- 删除缺失行:
df.dropna(),适合缺失比例极低的情况。 - 填充缺失值:
df.fillna(value),常用数值列的均值、中位数,或者分类列的众数。
重复数据同样常见。df.duplicated()返回布尔序列标记重复行,df.drop_duplicates()一键删除,对于根据特定列判断重复,可以传入subset参数,例如根据邮箱列去重:
df.drop_duplicates(subset=['email'], keep='first')
数据合并:像SQL一样关联表
pandas的merge函数可以实现类似SQL的JOIN操作,假设你有订单表orders和客户表customers,通过customer_id连接:
merged = pd.merge(orders, customers, on='customer_id', how='left')
how参数支持left、right、inner、outer四种连接方式,与SQL语义一致。
concat则用于纵向或横向拼接,适用于追加记录或合并特征列。
实战场景:从CRM系统导出客户信息,从交易系统导出订单记录,在pandas中合并后做客户画像分析,整个过程不需要数据库,只需要两个CSV文件,几行代码就能完成传统ETL工作。
分组聚合:快速洞察数据模式
groupby是pandas中最强大的功能之一,按类别分组后计算统计量,一行代码就能完成Excel中复杂的透视表操作。
df.groupby('城市')['销售额'].agg(['mean', 'sum', 'count'])
结果会返回每个城市的平均销售额、总销售额和订单数量,如果需要对多个列做不同聚合,可以用字典传入agg:
df.groupby('城市').agg({'销售额': 'sum', '年龄': 'mean', '用户ID': 'count'})
这些操作在pandas数据分析实战中几乎每天都会用到,配合pivot_table函数,还能生成类似Excel透视表的格式,而且计算速度受数据量影响更小。
pandas python学习路线:从基础到进阶
第一阶段:熟悉数据结构
pandas的核心是Series(一维序列)和DataFrame(二维表格),先花时间理解它们的索引、切片、布尔选择,这部分内容在任何一本pandas教程或官方文档中都有详细说明,建议跟着官方10分钟指南做一遍,大概需要两小时。
第二阶段:数据清洗与变换
掌握缺失值处理、重复值删除、数据类型转换、字符串操作、日期时间解析,这是pandas python学习路线中最贴近实际工作的部分,可以找一份公开的杂乱数据集(比如Kaggle上的Titanic),练习从原始CSV到干净表格的完整流程。
第三阶段:分组与合并
groupby、merge、concat、pivot_table是进阶核心,这些操作在数据分析面试中频繁出现,建议自己构造两个小表,尝试所有连接方式,理解每种连接的结果差异。
第四阶段:性能优化
当数据量超过内存时,需要学会分块读取、使用dtype指定列类型节省内存、利用apply代替循环、以及query和eval
加速筛选,了解numpy向量化操作对pandas的速度提升也有帮助。
推荐资源与工具
- 官方文档:pandas.pydata.org,最权威的参考。
- 书籍:《Python for Data Analysis》(作者就是pandas创建者Wes McKinney),覆盖了从入门到精通的全部内容。
- 在线练习:Kaggle上的“Pandas”微课程,免费且包含交互式练习。
- 社区:Stack Overflow上pandas标签有超过百万个问题,绝大多数常见问题都能找到答案。
近年来,国内也涌现出不少高质量的pandas教程和视频课程,搜索pandas数据分析实战可以找到很多带案例的系列内容,学习时注意不要只记代码,要理解每个参数的意义,因为实际数据永远比教程更不规整。
pandas常见问题解答
pandas和numpy有什么区别?
numpy提供多维数组对象和基础数学运算,是pandas的底层依赖,pandas在numpy基础上增加了行/列索引、标签、缺失值处理、数据框操作等高级功能,如果你只需要数值计算,numpy就够了;如果涉及混合数据类型、类Excel操作、时间序列,pandas是更合适的选择,两者在pandas数据分析实战中经常配合使用,比如用numpy函数对pandas列做向量化运算。
如何高效处理大数据集?
当数据量超过内存,单机pandas会遇到瓶颈,可以采用以下几种策略:
- 分块读取:
read_csv(chunksize=10000)返回迭代器,逐块处理。 - 指定列类型:通过
dtype参数将整数列用int32,浮点列用float32,减少内存占用。 - 只读取需要的列:
usecols参数指定列名,避免加载无用数据。 - 如果数据达到几十GB,考虑使用Dask或Polars等分布式或并行框架,它们提供与pandas类似的API,但能处理更大规模的数据。
pandas适合做机器学习建模前的数据准备吗?
是的,pandas是机器学习流程中最常用的数据预处理工具,特征工程中的缺失值填充、类别编码、数值标准化、数据划分等步骤,都可以在pandas中完成,配合scikit-learn的ColumnTransformer,能将pandas的变换流程无缝嵌入到模型管道中,业内专家指出,在工业级机器学习项目中,数据清洗和特征工程往往占据80%的时间,pandas正是处理这部分工作的主力工具。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/509430.html