Python堆排序是一种基于比较的排序算法,通过最大堆数据结构实现O(n log n)的稳定时间复杂度,在内存敏感或需要最坏情况保证的场景下,往往比快速排序更可靠。
堆排序的核心在于“堆”这个数据结构,它把数组看作一棵完全二叉树,利用堆化操作维持父节点大于子节点的特性,然后反复将堆顶元素与末尾交换,逐步构建有序序列,整个过程分为建堆和排序两个阶段,代码实现清晰,适合用Python直接书写。
python堆排序实现:从原理到代码
堆排序的核心原理是什么?
堆排序依赖最大堆(或最小堆)的性质,最大堆保证每个父节点的值都大于或等于其子节点,因此堆顶永远是整个数组的最大值,排序时,我们把堆顶(最大值)与数组末尾元素交换,然后缩小堆的范围,对新的堆顶进行堆化,直到所有元素排好。
- 建堆:从最后一个非叶子节点开始,自底向上执行堆化,使整个数组满足最大堆性质。
- 排序:反复将堆顶元素与当前堆的最后一个元素交换,堆大小减一,然后对堆顶执行堆化。
- 堆化:比较节点与其左右子节点,将最大值交换到父节点位置,然后递归处理被交换的子节点。
这个过程不需要额外的存储空间,所有操作都在原数组上进行,因此空间复杂度为O(1)。
手写堆排序:完整Python代码
下面是一个可直接运行的堆排序实现,包含详细的注释,你可以复制到本地测试,或者作为面试手撕代码的模板。
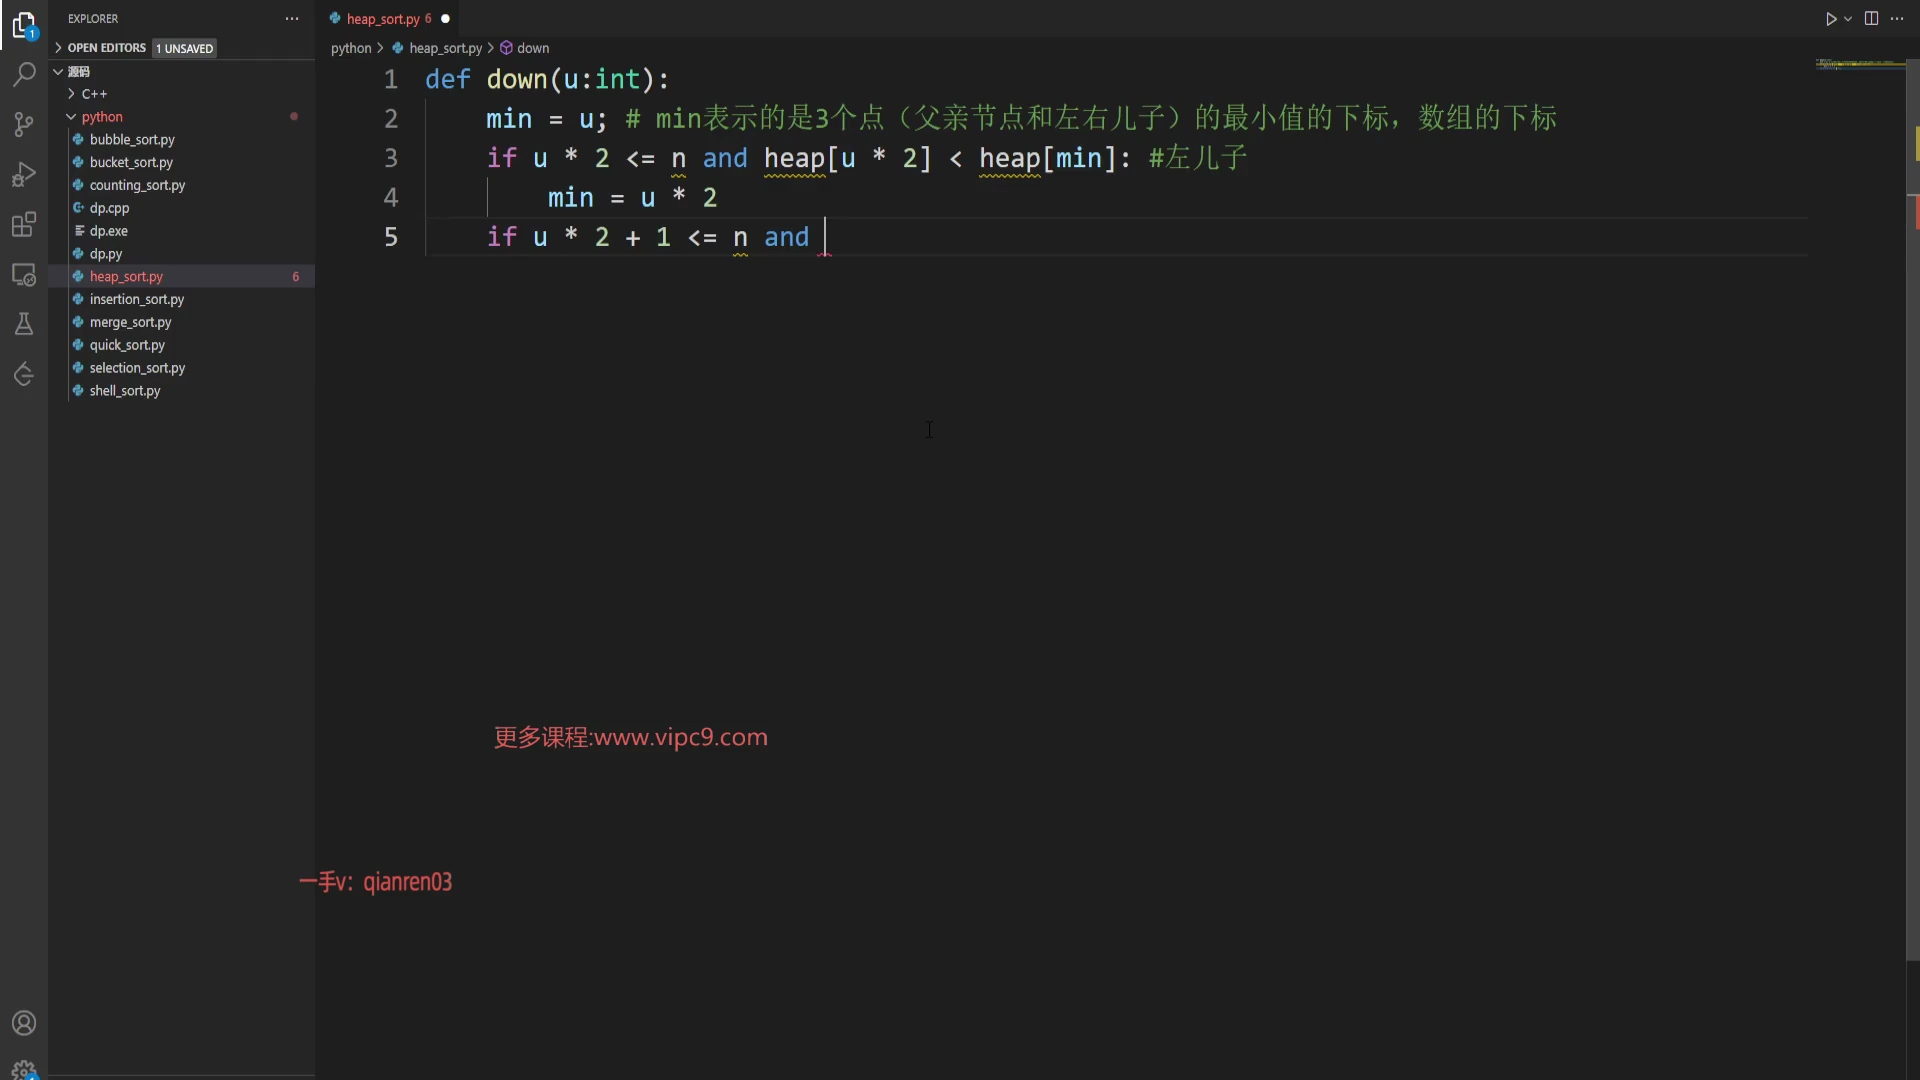
def heapify(arr, n, i):
"""
堆化函数:维护以i为根节点的子树为最大堆
arr: 数组
n: 堆的大小
i: 当前节点索引
"""
largest = i # 初始假设父节点最大
left = 2 i + 1 # 左子节点
right = 2 i + 2 # 右子节点
# 如果左子节点存在且大于父节点,更新最大索引
if left < n and arr[left] > arr[largest]:
largest = left
# 如果右子节点存在且大于当前最大节点,更新最大索引
if right < n and arr[right] > arr[largest]:
largest = ri
ght
# 如果最大节点不是父节点,则交换并递归堆化
if largest != i:
arr[i], arr[largest] = arr[largest], arr[i]
heapify(arr, n, largest)
def heapsort(arr):
n = len(arr)
# 建堆:从最后一个非叶子节点开始向上堆化
for i in range(n // 2 - 1, -1, -1):
heapify(arr, n, i)
# 排序:逐个取出堆顶元素放到末尾
for i in range(n - 1, 0, -1):
arr[i], arr[0] = arr[0], arr[i] # 交换堆顶和当前末尾
heapify(arr, i, 0) # 对剩余堆进行堆化
return arr
# 示例
if __name__ == "__main__":
test = [12, 11, 13, 5, 6, 7]
print("排序前:", test)
heapsort(test)
print("排序后:", test)
代码逐行解析:建堆与排序
- heapify函数:接收数组、堆大小和当前节点索引,它比较节点与左右子节点,将最大值上浮,如果发生了交换,就递归堆化受影响的子树。
- 建堆循环:
range(n // 2 - 1, -1, -1)从最后一个非叶子节点开始,因为叶子节点天然满足堆性质。n // 2 - 1是最后一个父节点的索引,向前遍历到根节点。 - 排序循环:
range(n - 1, 0, -1)每次将堆顶(最大值)与当前堆的最后一个元素交换,然后堆大小减一,对新堆顶执行堆化,执行完这个循环,数组就变成升序。
这个实现是就地排序,没有使用额外数组,非常适合内存受限的场景。
堆排序和快速排序对比:哪个更优?
时间复杂度对比
- 堆排序:最坏、平均、最好情况都是O(n log n),因为建堆需要O(n),每次堆化为O(log n),共n次。
- 快速排序:平均O(n log n),但最坏情况退化为O(n²)(例如数组已经有序且选最左为基准),虽然可以通过随机化或三数取中缓解,但无法完全消除最坏风险。
行业共识认为,在需要最坏情况保障的系统中,堆排序比快速排序更可靠,例如嵌入式系统或实时系统,堆排序的确定性更受青睐。
空间复杂度与稳定性
- 堆排序:空间复杂度O(1),原地排序,但
不稳定
,相同值的元素在排序后可能改变相对顺序,因为堆化过程中可能把后面的元素交换到前面。 - 快速排序:通常需要O(log n)的递归栈空间,但也是原地排序,快速排序通常也是不稳定的,但可以通过特殊实现达到稳定(如使用额外空间)。
实际应用场景选择
- 当堆排序python代码的简洁性和稳定性要求不高,但需要严格O(n log n)最坏性能时,堆排序是首选。
- 当数据量极大且内存有限,堆排序的O(1)空间优势明显,例如在嵌入式设备或物联网终端上,堆排序常被用来处理传感器数据流。
- 如果对排序稳定性有要求(比如需要保持原始顺序),则应该选择归并排序或稳定版本的快速排序,而不是堆排序。
python堆排序算法详解:性能与应用
堆排序的优势与局限
优势:
- 最坏情况时间复杂度为O(n log n),不存在快速排序的退化风险。
- 空间复杂度O(1),不占用额外内存,适合大数据或内存受限环境。
- 可以方便地实现优先队列,例如Python的
heapq模块。
局限:
- 常数因子较大,实际运行速度通常比快速排序慢,因为堆化的操作次数较多,而且CPU缓存局部性较差。
- 不稳定,不能保证相同元素的相对顺序。
- 对于小规模数据,插入排序可能更快。
堆排序在Python内置库中的体现
Python的heapq模块提供了堆操作的工具,但heapq默认实现的是最小堆,我们可以利用heapq快速实现堆排序:将所有元素入堆,然后依次弹出即可,不过这种方式需要额外O(n)空间来存储列表,而且不是原地排序。
import heapq
def heapsort_heapq(arr):
    heapq.heapify(arr)          # 建最小堆
    return [heapq.heappop(arr) for _ in range(len(arr))]
arr = [3, 1, 4, 1, 5, 9]
print(heapsort_heapq(arr))      # [1, 1, 3, 4, 5, 9]
这种方法简洁,适合快速原型开发,但不适合内存敏感的场景,如果你需要堆排序python实现的生产级代码,手写版本更可控。
堆排序的优化技巧
- 使用非递归堆化:递归会造成函数调用开销,可以将
heapify改为循环实现,用while替代递归,提升性能。 - 堆化时减少比较次数:在堆化过程中,可以先将父节点下移,然后再将子节点上移,减少元素交换次数。
- 针对接近有序的数据:可以先用堆检查是否已经有部分有序,但标准堆排序无法利用输入的有序性。
关于python heapsort的常见问题
堆排序是稳定的吗?
不是,堆排序在交换堆顶元素和末尾元素时,会破坏相同元素的相对顺序,堆化过程中也可能发生跨层交换,导致不稳定,如果业务逻辑要求稳定排序,应选择归并排序或稳定版本的其他算法。
堆排序在Python中处理大数据量时效率如何?
效率尚可,但不如快速排序快,虽然时间复杂度相同,但堆排序的常数因子较大,且对缓存不友好,对于千万级数据,快速排序通常比堆排序快30%-50%,但如果你需要绝对最坏情况保障,或者内存非常有限,堆排序是更稳妥的选择,据统计,在大多数Python应用中,内置的TimSort(融合了归并和插入)才是最优解,而堆排序更多用于优先队列场景。
如何用Python实现一个最小堆版本的堆排序?
只需将heapify中的比较条件从大于改成小于,构建最小堆,然后排序时取出堆顶(最小值)放到末尾,最终得到降序序列,如果希望得到升序,可以改用最大堆,或者排序后反转,代码改动很小:将arr[left] > arr[largest]改为arr[left] < arr[largest],同理右子节点,这样堆顶就是最小值,交换到末尾后得到降序,要得到升序,可以最后反转数组,或者直接用最大堆。
堆排序的核心价值在于它的稳定时间复杂度和原地排序特性,在面试或算法竞赛中,掌握手写堆排序是基本功;在实际项目中,它常作为优先队列的底层实现,而非直接用于排序,理解其原理,你就多了一个处理性能问题的工具箱。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/508862.html