Python中merge()函数是pandas库实现SQL风格数据合并的核心工具,通过指定键值可高效完成DataFrame的行列拼接,是日常数据处理最常用的方法之一。
merge()基础用法与参数解析
merge()本质上是按行匹配数据,默认以两表共有的列名作为连接键,支持多种连接方式,理解参数是正确使用的前提。
- on:指定连接键的列名,前提是左右两个DataFrame都包含该列且列名相同,如果列名不同,使用left_on和right_on分别指定。
- how:控制连接方式,可选inner、left、right、outer,inner只保留匹配上的行,left保留左表全部行,right保留右表全部行,outer保留两表全部行。
- left_on / right_on:当键列名不同时,分别指定左表和右表作为键的列。
- left_index / right_index:当键是索引时,设置为True,可以同时使用索引和列作为键,只需混合指定即可。
- suffixes:当两表有同名列但不作为键时,自动添加后缀,默认是_x和_y。
- indicator:设置为True,结果会新增一列_merge,标记每行来源(left_only, right_only, both),调试时很实用。
举个例子,假设你有用户信息表和订单表,想按用户ID合并:
import pandas as pd
users = pd.DataFrame({'user_id': [1, 2, 3], 'name': ['A', 'B', 'C']})
orders = pd.DataFrame({'user_id': [1, 2, 4], 'amount': [100, 200, 300]})
merged = pd.merge(users, orders, on='user_id', how='left')
这段代码会保留users表所有用户,订单表中没有对应记录的用户金额为NaN,关键在于理解how参数的行为,这在python merge left right场景中经常被问到。
merge vs join vs concat:如何选择?
很多新手分不清这三个方法,其实它们解决的问题不同。
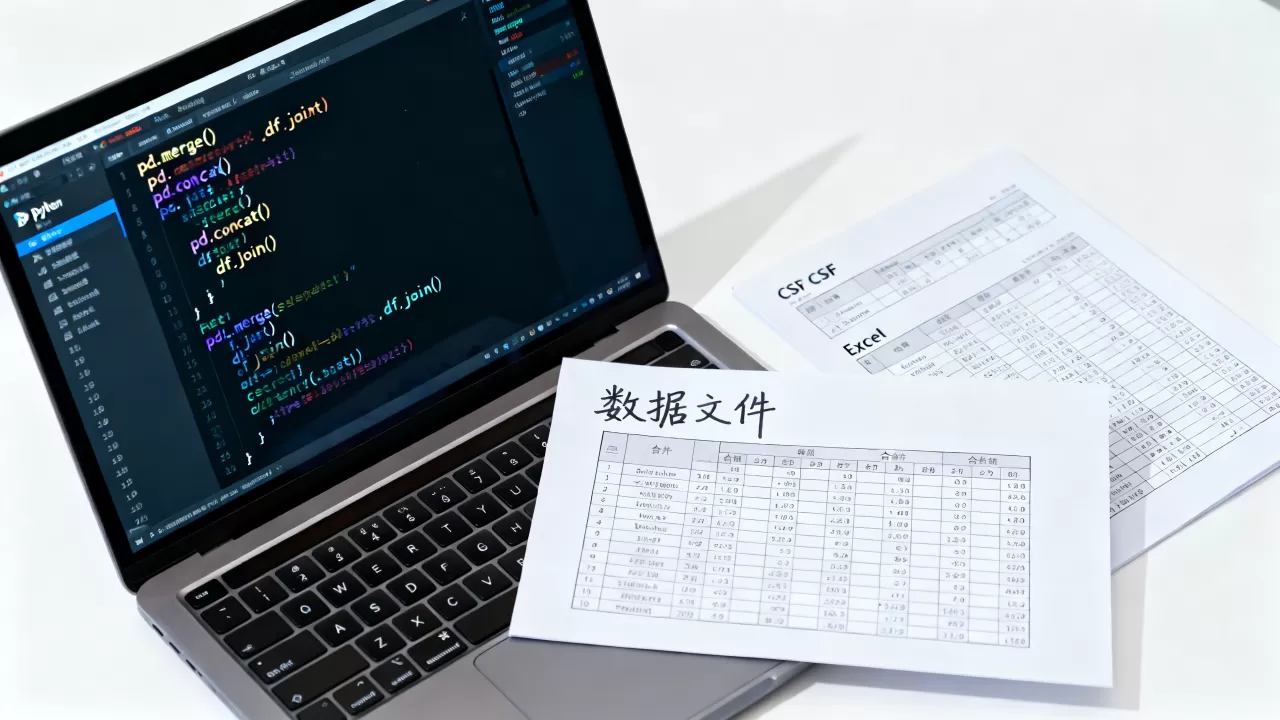
- merge:按列值匹配,类似SQL的JOIN,适合按关联键横向拼接。
- join:本质上是merge的简化版,但默认以索引为连接键,如果两个DataFrame的索引都是连续整数,join跟merge差别不大,但索引含义复杂时容易出错。
- concat:默认按行纵向堆叠,也可以设置axis=1横向拼接,但拼接时不考虑键值匹配,直接对齐索引,如果索引不对齐,会产生大量NaN。
对比表格
| 方法 | 连接方式 | 匹配依据 | 典型场景 |
|---|---|---|---|
| merge | 横向 | 列值 | 关系型数据合并 |
| join | 横向 | 索引 | 索引对齐的简单合并 |
| concat | 纵向/横向 | 索引 | 追加行或列 |
python merge和join区别的关键在于匹配键,merge能灵活指定任意列,join则假设索引已经包含你的连接逻辑,实际项目中,大多数场景用merge就够了,不用纠结。
实战:python merge多个dataframe的合并策略
真实业务中经常需要合并两个以上的表,用户表、订单表、商品表需要三表关联,这时可以链式调用merge,也可以使用reduce函数。
链式方式
result = users.merge(orders, on='user_id', how='left').merge(products, on='product_id', how='left')
使用reduce
from functools import reduce
dfs = [users, orders, products]
result = reduce(lambda left, right: pd.merge(left, right, on='user_id', how='left'), dfs)
当表数量较多时,reduce更简洁,但要注意,如果中间表有重复列名,需要提前处理或使用suffixes。
处理重复键
如果键列有重复值,merge会生成笛卡尔积,例如一个用户有多条订单记录,合并后用户信息会重复,这是符合预期的,但你需要确保数据量不会爆炸,在合并前评估重复行数量,必要时先聚合再合并。
索引合并
有时键不在列中,而在索引里,使用left_index=True或right_index=True即可。python merge后索引处理是个常见问题:合并后默认重置索引,如果你希望保留原索引,可以设置参数index=False(pandas 1.4+版本支持),或者合并后手动set_index。
性能优化:merge大数据集时的注意事项
merge的性能瓶颈通常在于内存占用和匹配复杂度,以下技巧能显著提升效率。
- 预先缩小数据量:只选择需要的列,减少内存占用,例如合并前用
df[['key', 'col1']]。 - 使用索引:如果键是连续的整数,将键设为索引后使用join,比merge快,但需确认索引唯一性。
- 指定键的类型:确保键列的数据类型一致,避免pandas自动转换类型,字符串类型比整数慢,尽量用整数或分类类型。
- 分块合并:如果单表太大,可以分块读取,用循环合并,也可以使用
pd.concat先聚集再合并,但要注意内存。 - 使用how=’inner’:只保留匹配行,减少结果行数,比outer快。
据pandas官方文档说明,在大数据场景下,默认的merge算法会进行哈希匹配,时间复杂度接近O(n+m),如果键存在大量重复值,性能会明显下降,此时可以考虑先去重再合并。
业内专家指出,在数据量超过内存时,可以考虑使用Dask或PySpark的merge功能,它们支持分布式计算,但语法与pandas类似。
常见错误与调试技巧
merge时遇到错误,大多数是类型不匹配或键列名写错。
- 错误:KeyError:检查键列是否真的存在于两个DataFrame中,大小写是否一致,是否有空格。
- 错误:ValueError: You are trying to merge on object and int64 columns:类型不匹配,用
df['col'].astype(str)统一类型即可。 - 结果行数不对:检查how参数,以及是否有重复键,如果左表有100行,右表有200行,匹配后可能超过100行,使用
indicator=True查看每行来源,快速定位问题。
调试小技巧:先分别打印两个DataFrame的前几行,确认键列的值集,用set(left['key']).intersection(set(right['key']))查看交集,可以预测合并后的行数。
关于merge() python的常见问题
Q: python merge函数怎么用,需要指定哪些参数?
A: 最少只需要两个DataFrame和一个on参数,如果键列名相同,pd.merge(left, right, on='key')即可,如果列名不同,使用left_on和right_on,默认how=’inner’,只保留两表都有的键。
Q: python merge left right有什么区别?
A: left保留左表所有行,右表无匹配则填充NaN;right保留右表所有行,左表无匹配则填充NaN,实际使用中,left更常用,因为通常以主表为左表做关联,注意,两者结果的行数可能不同,具体取决于表的大小和匹配情况。
Q: merge后数据变多了,为什么?
A: 最常见的原因是键列有重复值,例如左表键值1出现两次,右表键值1出现三次,合并后会产生2×3=6行,解决方案是确认业务逻辑:如果希望仅保留唯一匹配,先对重复键去重,或者使用drop_duplicates后再合并,另一个原因是误用了how=’outer’,导致左右表所有行都保留,包括未匹配的行。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/508150.html