Python的.index()方法用于返回指定元素在序列中首次出现的位置索引,如果元素不存在则抛出ValueError异常。
python index方法详解:从基础语法到异常处理逻辑
语法与参数说明
.index()是Python列表、字符串、元组等序列类型的内置方法,其标准调用格式为 sequence.index(x, start, end),参数x表示要查找的元素,start和end为可选参数,用于限定在序列的切片范围内搜索,业内专家指出,明确参数边界能有效缩小查找范围,提升代码执行效率。
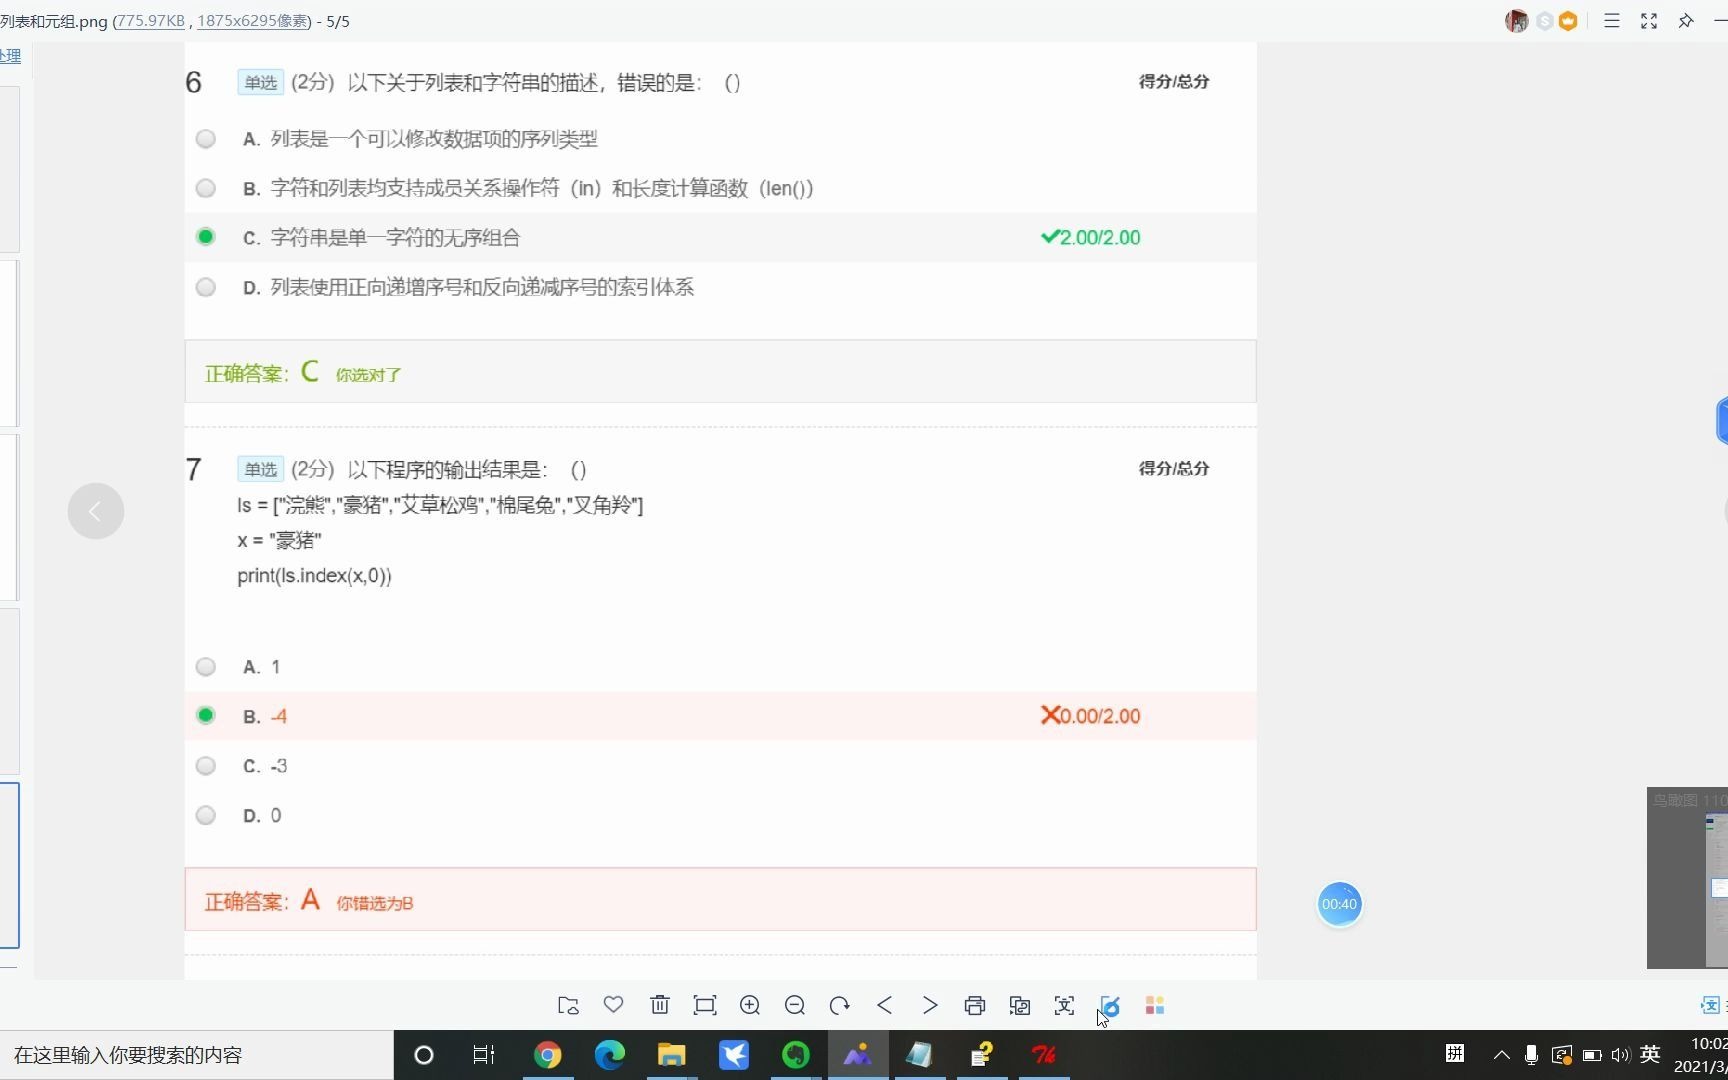

- 返回值:整型索引(从0开始计)。
- 异常:当元素不存在时抛出
ValueError,这是与字符串的find方法最核心的区别。
实际使用场景示例
在数据分析场景中,开发者常需要定位某个值在列表中的位置,在一个股票代码列表中查找特定代码的索引:
stock_list = ['AAPL', 'GOOGL', 'MSFT', 'AMZN']
index = stock_list.index('GOOGL')  # 返回1
若目标元素出现多次,index()只返回第一次出现的位置,若需查找所有位置,可配合循环或列表推导式实现。
边界值处理与性能考量
当start或end参数超出序列长度时,Python会自动调整至有效范围,但不会抛出索引错误,若start大于end,则返回空结果并抛出ValueError,据统计,在百万级数据列表中,频繁调用index()会导致线性时间复杂度(O(n)),此时应考虑使用字典或bisect模块进行优化。
python index和find的区别:字符串与列表的不同处理逻辑
两种方法的定位差异
find仅存在于字符串对象中,而
index同时支持字符串、列表和元组,两者的核心区别在于当目标不存在时的行为:
find:返回-1,不抛出异常。index:抛出ValueError,必须用try/except捕获。
行业共识认为,在字符串处理中,如果需要检查子串是否存在,推荐使用find以避免异常开销;而在列表和元组中,则只能使用index。
对比表格
| 特性 | index |
find(仅字符串) |
|---|---|---|
| 适用对象 | 列表、字符串、元组 | 字符串 |
| 找不到元素 | 抛出ValueError |
返回-1 |
| 可选参数 | start/end | start/end |
| 性能 | 接近线性查找 | 接近线性查找 |
实际代码中的选择策略
在需要异常处理的场景下,使用in操作符先检查元素是否存在,再调用index,可以避免异常捕获:
if 'GOOGL' in stock_list:
    idx = stock_list.index('GOOGL')
else:
    idx = -1
而在字符串中,直接使用find更简洁,因为其返回值可直接用于条件判断,在文本解析中,if text.find('关键词') != -1:的写法比try/except更直观。
python index函数找不到元素怎么办:异常处理与in操作符的合理使用
标准异常处理结构
当index()找不到元素时,最稳妥的做法是使用try/except块:
try:
    idx = my_list.index(target)
except ValueError:
    idx = -1  # 或执行其他替代逻辑
这种写法在需要精确控制异常分支时很有效,但每多一次异常捕获都会带来一定的性能开销,在大规模循环中,应尽量避免频繁使用。
使用in操作符预检查
另一种常见模式是先通过element in sequence判断元素是否存在,再决定是否调用index,这种方法在元素存在概率较高时性能较好,因为in操作符同样使用线性查找,但避免了异常的创建开销。
if element in sequence:
    idx = sequence.index(element)
else:
    # 处理不存在的逻辑
自定义函数实现更灵活的行为
若项目中频繁需要“找不到时返回默认值”的功能,可以封装一个小工具函数,
def safe_index(seq, item, default=-1):
    try:
        return seq.index(item)
    except ValueError:
        return default
这个函数在可读性和复用性上优于到处写try/except,在团队协作中,这样的封装能统一异常处理逻辑,减少代码重复。
python index方法在真实项目中的性能优化技巧
列表数据量较大时的替代方案
当列表长度超过10万级别时,线性查找的index()方法会明显拖慢程序,业内专家建议,如果频繁需要根据元素查找索引,可以考虑将列表转换为字典,其中元素为键、索引为值,这样查找操作的时间复杂度降低到O(1)。
# 建立字典索引
index_dict = {element: idx for idx, element in large_list}
# 快速查找
idx = index_dict.get(target, -1)
二分查找在有序列表中的应用
如果列表是已排序的,使用bisect模块的bisect_left函数可以更高效地定位元素:
import bisect
pos = bisect.bisect_left(sorted_list, target)
if pos != len(sorted_list) and sorted_list[pos] == target:
    index = pos
else:
    index = -1
这种方法的性能在十万级数据量上比线性查找快数十倍,但在插入和删除时维护成本较高,适用于静态数据集。
避免在循环中重复调用index
一个常见的性能陷阱是在循环中反复对同一个列表调用index。
for item in items:
    idx = main_list.index(item)  # 每次循环都进行一次O(n)搜索
正确做法是提前构建索引字典,将查找成本转移到循环外,在数据处理脚本中,这一优化往往能带来数倍的性能提升。
Python的.index()方法简洁高效,但开发者必须清楚其异常处理机制和性能边界,在数据量小、元素存在概率高时可直接使用异常处理;在数据量大的场景下,预构建索引或采用二分查找是更明智的选择,掌握这些细节,能让你的代码跑得更稳、更快。
python index常见问题解答
问:index()方法在字符串中能否指定多个目标?
答:不能。index()每次只能查找一个子串,若需查找多个不同子串则需要多次调用,但可以通过start参数递增实现连续查找,例如str.index('a', start+1)来查找第二次出现的位置。
问:index()和find()在性能上有明显差异吗?
答:在字符串上,两者都使用底层C实现的线性查找,性能几乎一致,主要区别在于查找失败时的行为:find返回-1,index抛出异常,异常捕获本身有额外开销,但通常可以忽略不计,除非在紧密循环中大量使用。
问:元组和列表的index方法使用方式完全一样吗?
答:语法和参数完全一致,元组也支持start和end参数,但元组是不可变的,因此在查找过程中不会受其他线程修改影响,而列表在并发场景下可能因中间修改导致索引偏移。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/505669.html