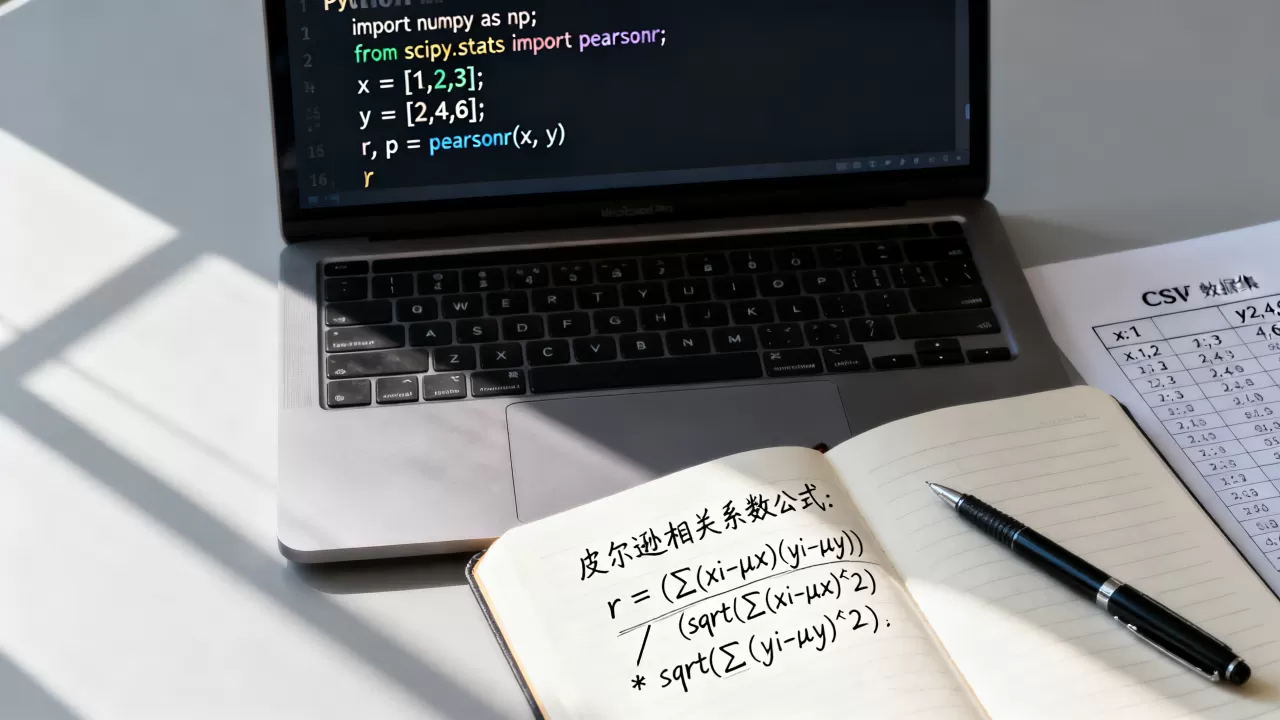
在Python中,通过scipy.stats.pearsonr函数或numpy.corrcoef可以快速计算皮尔逊相关系数,结合数据可视化能更直观地判断线性关系。这两个核心工具覆盖了从基础统计到科研数据分析的绝大多数场景,配合pandas对数据框的操作,能高效处理表格数据中的相关性分析任务。
如何用Python计算皮尔逊相关系数
使用scipy计算皮尔逊相关系数
scipy的pearsonr函数是计算皮尔逊相关系数的首选,它同时返回相关系数和p值,这一点在假设检验中非常关键,调用方式很简单:r, p_value = scipy.stats.pearsonr(x, y),其中x和y是两个长度相同的数组,该函数内部会先清洗数据,自动剔除NaN值,但在实际项目中建议提前做缺失值处理。
实操步骤:
- 导入库:
from scipy import stats - 准备数据:确保x和y为数值型,无缺失值
- 执行计算:
r, p = stats.pearsonr(x, y) - 解读结果:r值在-1到1之间,绝对值越接近1线性关系越强;p值小于0.05通常认为显著相关
使用numpy和pandas快速计算
numpy的numpy.corrcoef返回一个相关系数矩阵,当你有多个变量时非常方便,例如np.corrcoef(data, rowvar=False),每列是一个变量,pandas的DataFrame.corr()则直接对数据框所有列计算两两相关系数,默认使用皮尔逊方法。
代码示例:
import numpy as np
import pandas as pd
# numpy计算多个变量
data = np.random.randn(100, 3)  # 3列变量
corr_matrix = np.corrcoef(data, rowvar=False)
# pandas计算数据框
df = pd.DataFrame(data, columns=['A', 'B', 'C'])
df_corr = df.corr()  # 默认pearson
皮尔逊相关系数在Pandas DataFrame中的高效应用
在实际数据分析中,数据往往以表格形式存在,pandas的
corr()方法允许你直接对整个数据框进行计算,同时支持method参数选择相关系数类型,如果你只想查看某一列与其他列的相关性,可以切片后调用corrwith()。
常见场景:
- 金融分析中,查看股票收益率与市场指数收益率的线性相关
- 生物统计中,分析基因表达量与临床指标的关系
- 电商数据中,评估用户行为指标之间的关联强度
注意事项:
- 确保数据列是数值型,分类变量需先编码
- 缺失值处理:
df.corr()默认会忽略缺失值,但数据量小时建议先填充或删除 - 结果可视化可联合
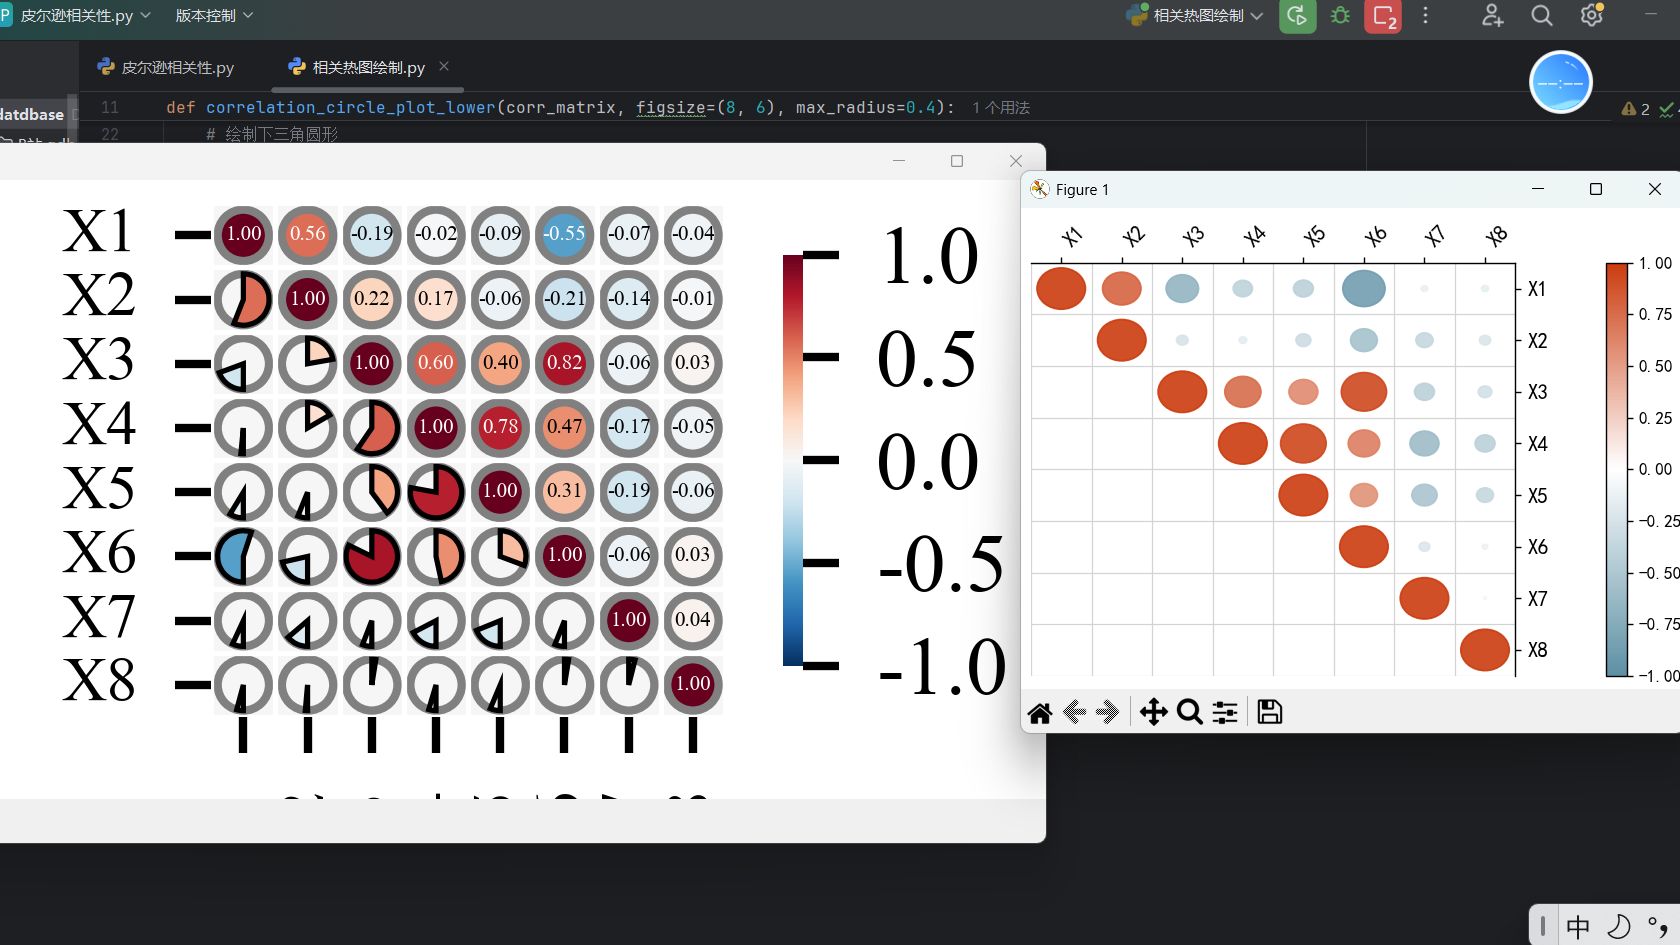
seaborn.heatmap做热力图,直观展示相关性矩阵
皮尔逊相关系数Python实战:显著性检验与结果解读
如何解读p值和相关系数
皮尔逊相关系数仅反映线性相关程度,不能直接判断因果关系,p值代表在原假设(总体相关系数为0)下,观察到当前样本相关系数的概率,p值越小,我们越有理由相信两个变量之间存在真实的线性关系。
行业共识认为,p值小于0.05或0.01是常用的显著性阈值,但应注意多重比较问题,例如在基因表达分析中需做Bonferroni校正,相关系数的大小需结合领域知识判断:在社会科学中0.3可能算中等,在物理实验中0.99才被认为强相关。
显著性检验的Python实现
pearsonr已经直接给出p值,此外还可以通过scipy.stats.pearsonr的p-value属性获取,如果你需要手动计算置信区间,可以使用费希尔Z变换(Fisher transformation)或bootstrap方法。
bootstrap示例(计算置信区间):
import numpy as np fromscipy import stats def bootstrap_pearson(x, y, n_iter=1000, alpha=0.05): r_list = [] for _ in range(n_iter): idx = np.random.choice(len(x), len(x), replace=True) r, _ = stats.pearsonr(x[idx], y[idx]) r_list.append(r) r_list.sort() return r_list[int(alpha/2n_iter)], r_list[int((1-alpha/2)n_iter)]
结果可视化:散点图与线性拟合
光看数字不够直观,散点图能让你一眼看出数据是否存在线性趋势、异常值或非线性关系,使用matplotlib或seaborn,配合回归线(如seaborn.regplot)可以同时展示散点分布和拟合直线。
实用代码:
import seaborn as sns
import matplotlib.pyplot as plt
sns.regplot(x='A', y='B', data=df, ci=95)  # 带95%置信区间
plt.show()
皮尔逊相关系数的适用条件与数据要求
数据正态性检查
虽然皮尔逊相关系数对正态性有一定要求,但在大样本下(n>30)中心极限定理使检验相对稳健,统计推断(如p值)需要假设双变量正态分布,你可以用scipy.stats.normaltest或shapiro检验正态性,若数据严重偏态,建议考虑斯皮尔曼相关系数。
线性关系判断
皮尔逊相关系数只能捕捉线性相关,如果数据呈现U形曲线,皮尔逊r可能接近0,但实际存在强非线性关系,业内专家指出,在计算之前先画散点图是必要步骤,确认是否存在明显线性趋势。
异常值影响
皮尔逊相关系数对异常值非常敏感,单个极端点可能大幅改变r值,你需要提前识别并处理异常值,可使用箱线图或Z-score方法,若异常值无法剔除,可以考虑使用稳健的相关系数,如斯皮尔曼或肯德尔tau。
皮尔逊与斯皮尔曼:Python中如何选择
何时使用皮尔逊,何时使用斯皮尔曼
- 皮尔逊:数据连续、近似正态分布、线性关系、无异常值
- 斯皮尔曼:数据呈单调关系(不一定是线性)、变量为顺序尺度、存在异常值、正态性假设不满足
Python中实现斯皮尔曼相关系数
使用scipy.stats.spearmanr,语法与pearsonr类似,同样返回相关性和p值,pandas的df.corr(method='spearman')也能直接计算,在金融数据分析中,斯皮尔曼常用于处理收益率分布尖峰厚尾的情况。
对比代码:
r_pearson, p_pearson = stats.pearsonr(x, y)
r_spearman, p_spearman = stats.spearmanr(x, y)
皮尔逊Python常见问题解答
皮尔逊相关系数r为0说明两个变量无关吗?
不一定,r=0只表示没有线性相关,两个变量之间可能存在非线性关系(如抛物线、正弦波),建议先画散点图检查是否存在非线性模式,再决定是否使用皮尔逊或其他相关系数。
计算皮尔逊相关系数时数据量最少需要多少?
理论上两个变量至少需要3对数据才能计算,但样本量过小会导致结果不可靠,通常建议n≥30,否则p值检验的效力不足,如果数据量极小,应优先考虑可视化并结合领域知识判断。
pandas的corr()返回的相关系数矩阵如何提取特定对?
使用df['A'].corr(df['B'])直接计算两个变量的相关系数,或使用df.corr().loc['A','B']从矩阵中提取,这种方法适用于需要以编程方式获取多个变量对的相关性,且速度比循环更快。
在Python中高效完成皮尔逊相关系数分析,核心在于选对工具、理解假设、结合可视化,无论是scipy的单次检验,还是pandas的全表分析,都能快速输出结果,但只有深入理解适用条件和结果解读,才能让数据真正为你说话。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/505468.html