服务器端与客户端的响应机制,本质上是围绕HTTP请求-响应模型构建的协同工作体系,其核心目标是在最短时间内完成数据交互,任何环节的延迟都会直接导致用户体验下降。
服务器端客户端响应机制详解
要优化响应机制,必须从底层理解客户端与服务器如何对话,整个过程从用户输入URL开始,到浏览器渲染出最终页面,涉及DNS解析、TCP连接、TLS握手、HTTP请求传输、服务器处理、响应返回等多个步骤,行业共识认为,每一个毫秒的延迟都可能影响转化率,因此掌握全链路流程是优化的前提。

请求-响应模型的本质
客户端发送请求,服务器返回响应,这是Web交互的基础,但现实中的请求往往不是一次性完成浏览器会并行发起多个请求(CSS、JS、图片等),服务器需要处理并发并合理分配资源。HTTP/1.1的队头阻塞问题曾让开发者头疼,而HTTP/2通过多路复用解决了部分问题,但TCP层面的丢包重传依然存在,近年来,HTTP/3基于QUIC协议,进一步减少握手延迟,成为响应机制的重要升级方向。
从DNS解析到数据包传递
- DNS解析:域名到IP的转换,平均耗时20-100ms,使用CDN或预解析可以缩短这个时间。
- TCP三次握手:每次连接增加1.5个RTT,HTTP/2的复用技术可减少重复握手。
- TLS/SSL握手:加密协商增加1-2个RTT,使用TLS 1.3或会话复用能降低开销。
- 数据传输:服务器处理请求的耗时取决于应用逻辑、数据库查询和网络带宽。
不同协议的比较
| 协议 | 连接方式 | 队头阻塞 | 典型延迟改进 |
|---|---|---|---|
| HTTP/1.1 | 串行或有限并行 | 明显 | 基准 |
| HTTP/2 | 多路复用 | 仅TCP层 | 减少30%-50% |
| HTTP/3 | QUIC(UDP) | 几乎消除 | 再减少20%-40% |
业内专家指出,选择HTTP/3并结合CDN,是目前降低服务器响应延迟最直接的方案之一
,尤其在移动网络环境下效果显著。
服务器响应慢原因与优化策略
用户遇到“转圈圈”时,往往归咎于网络,但服务器响应慢原因通常更复杂,从服务器端看,CPU、内存、I/O瓶颈、数据库慢查询、不合理的代码逻辑都会拖慢响应,以下从几个层面展开分析。
网络层面的延迟因素
- 带宽不足:高峰期大量请求导致队列堆积,响应时间指数级上升。
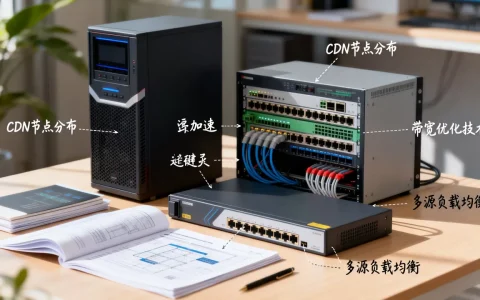
- 路由跳数:物理距离远或运营商互联互通差,增加RTT,使用CDN可将节点部署到用户附近,减少跨地域延迟。
- DNS解析慢:权威服务器响应慢或递归查询耗时,影响首屏时间。
服务器端资源瓶颈
- CPU负载过高:密集计算或死循环导致请求排队,通过监控工具(如top、htop)可定位。
- 内存不足:频繁GC或Swap读写,响应变得不稳定,增加内存或优化内存使用是关键。
- 磁盘I/O:慢速磁盘读写日志或数据库文件,使用SSD或分布式文件系统可缓解。
应用程序代码效率
- 未启用缓存:每次请求重复计算相同结果,使用Redis或Memcached可减少数据库压力。
- 同步阻塞调用:串行等待外部API响应,改用异步或并发模型(如协程)能提升吞吐量。
- 未压缩传输:大体积JSON或HTML未启用Gzip/Brotli,传输时间增加。据统计,启用压缩后响应体积可减少60%-80%。
数据库查询优化
- 慢查询SQL:缺少索引或全表扫描,导致数据库响应变慢,通过慢查询日志定位,添加索引或改写SQL。
- 连接池不足:频繁建立和关闭连接,使用连接池(如HikariCP)可复用连接。
- 缓存策略:热点数据使用Redis,避免重复查询数据库。
缓存与CDN加速
- 页面静态化:将动态页面缓存为静态HTML,减少服务器计算。
- CDN分发:静态资源(图片、CSS、JS)缓存到边缘节点,用户就近获取,
平均节省50%的响应时间
。 - 浏览器缓存:通过Cache-Control和ETag让客户端缓存资源,减少重复请求。
客户端请求超时处理机制
客户端请求超时是响应机制中不可忽视的一环,超时设置不合理,要么导致用户等待过久,要么频繁断开正常请求,行业共识认为,超时时间应根据业务场景动态调整,并配合重试和幂等性设计。
超时设置的合理范围
- 连接超时:通常1-5秒,超过则视为网络不可达,避免长时间等待。
- 读取超时:从发出请求到收到第一个字节的时间,推荐5-10秒,根据服务器响应能力调整。
- 总超时:包含所有阶段,一般不超过30秒,长连接场景可适当放宽。
重试策略与幂等性
- 重试次数:2-3次,避免雪崩,每次重试间隔递增(指数退避)。
- 幂等性:GET、PUT、DELETE方法天然幂等,POST需设计唯一请求ID,防止重复写入。
- 超时后处理:前端显示友好提示,后台记录日志供分析。
前后端协同的延迟优化
- 资源预加载:通过提前加载关键资源,减少等待时间。
- 数据流式传输:Server-Sent Events或WebSocket实现实时推送,避免轮询。
- 前端监控:使用Performance API记录真实用户响应时间,定位瓶颈。
实战:响应机制优化操作步骤
以下步骤可在实际服务器上验证,建议使用测试环境操作。
使用curl测量响应时间
curl -o /dev/null -s -w 'HTTP状态码: %{http_code}nDNS解析: %{time_namelookup}sn连接时间: %{time_connect}snTLS握手: %{time_appconnect}sn首字节: %{time_starttransfer}sn总耗时: %{time_total}sn' https://example.com
- 关注首字节时间(TTFB),若超过200ms,则服务器端需优化。
- 总耗时包括所有阶段,可对比开启CDN前后的差异。
启用HTTP/2并测试效果
- Nginx配置:在server块添加
listen 443 ssl http2;,确保OpenSSL支持HTTP/2。 - 验证:使用浏览器的开发者工具检查协议列,确认显示h2。
- 效果:多路复用减少连接数,实测TTFB可降低30%以上。
配置负载均衡与Session保持
- 使用Nginx或HAProxy分发请求,避免单点过载。
- Session保持:基于IP Hash或Cookie,确保同一用户请求落到同一后端,减少缓存无效。
- 健康检查:定期探测后端服务器,自动剔除故障节点。
服务器端客户端响应机制常见问题解答
Q1: 服务器响应慢时如何快速定位问题?
- 从客户端开始,使用curl测量TTFB和总耗时,若TTFB长则问题在服务器端;若TTFB短但总耗时极长,则网络或资源下载慢。
- 服务器端使用
top、iostat、netstat检查CPU、内存和连接数,配合strace跟踪系统调用。 - 查看应用日志,关注慢查询日志和异常堆栈,常见的根因是数据库查询慢或锁竞争。
Q2: 客户端请求超时一般设置多少秒?
- 连接超时建议3-5秒,读取超时5-10秒,总超时15-30秒,对于实时性要求高的场景(如支付),可缩短至5秒以内,并配合快速重试,对于文件上传或下载,超时应适当放宽。
- 关键原则:超时时间需小于用户忍耐阈值,大于服务端正常处理时间,避免频繁误判。
Q3: HTTP/2与HTTP/3在响应机制上有什么区别?
- HTTP/2基于TCP,存在TCP层面的队头阻塞;HTTP/3基于QUIC (UDP),彻底消除该问题,且连接迁移更平滑。
- HTTP/3握手延迟更低,通常比HTTP/2减少1-2个RTT,在弱网环境下优势明显,目前主流浏览器和CDN服务商已支持,建议逐步迁移。
服务器端与客户端的响应机制优化,本质是平衡速度、稳定性和成本,从协议选择到代码优化,每一环都值得深究,最终目标是让用户感觉不到等待。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/504239.html