Python中apply方法的结果类型取决于传入函数,但通过掌握pandas的apply机制,你能灵活控制数据框的逐行或逐列计算。
Python apply结果类型深度解析:返回Series还是DataFrame?
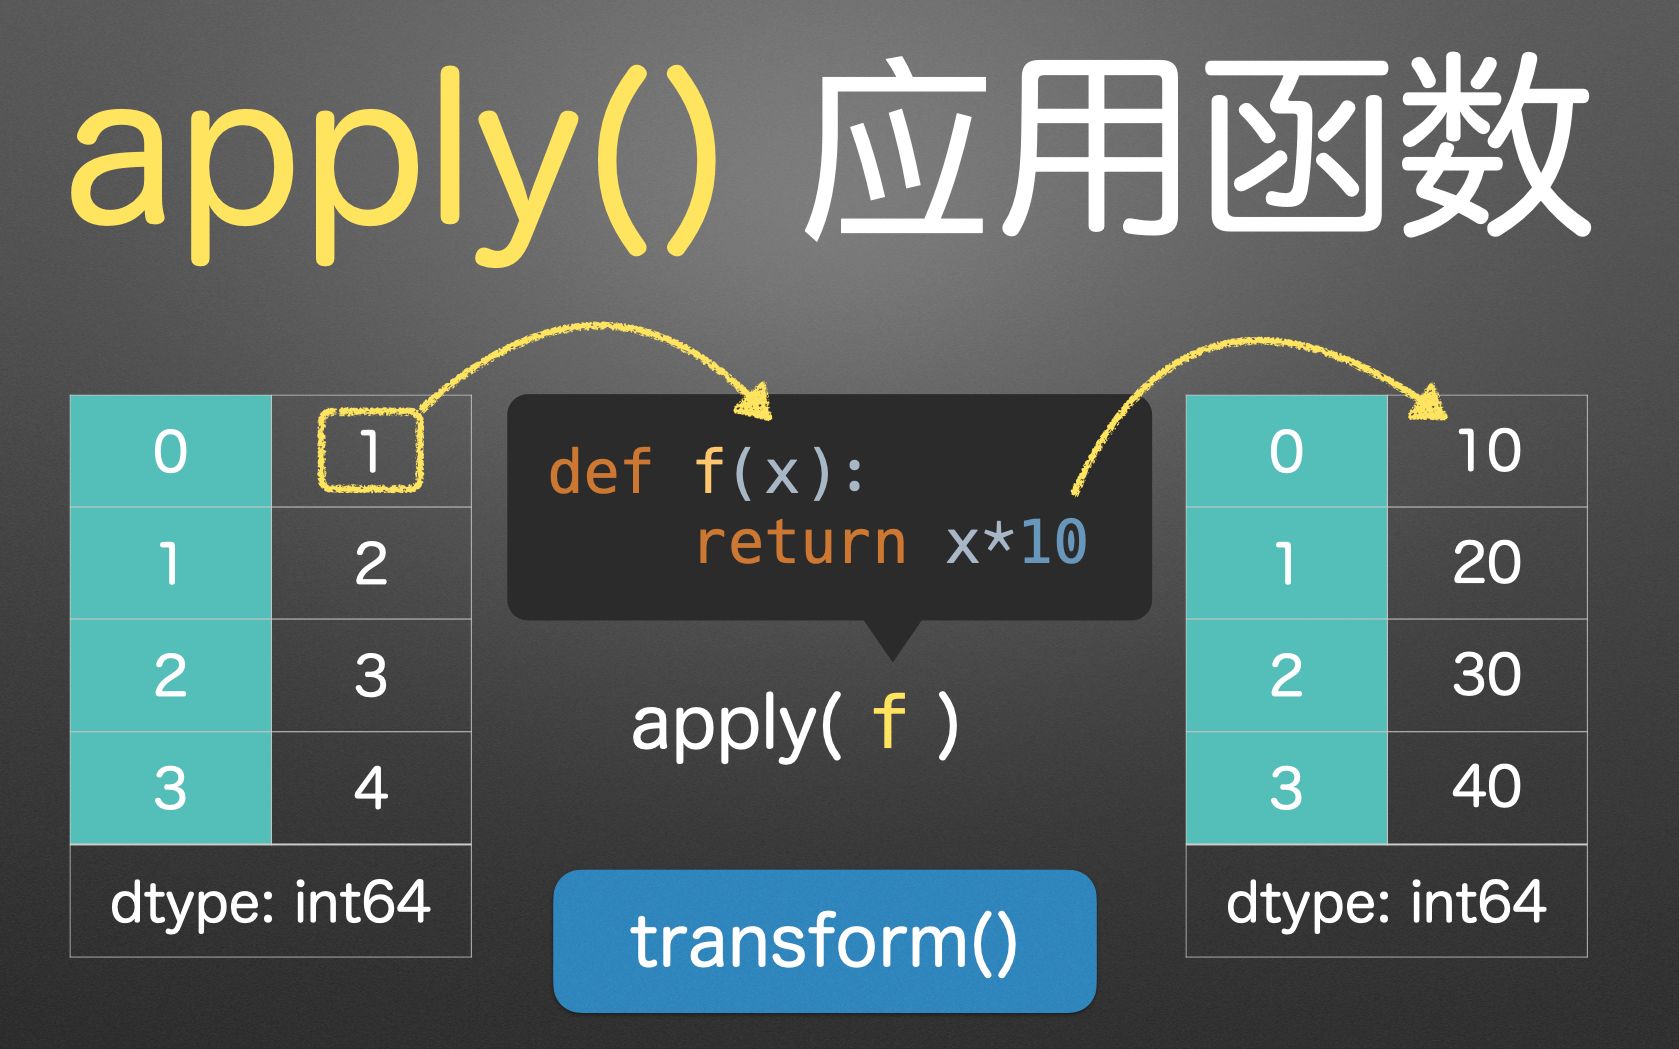
很多新手问我,apply结果到底是Series还是DataFrame?答案其实就藏在axis参数和函数的返回类型里,当你设置axis=0时,apply对每一列单独执行函数,结果是一个Series,索引是原来的列名;axis=1时,apply对每一行执行,结果同样是一个Series,索引是原来的行索引,但如果你的函数返回一个Series对象,那么apply结果会变成一个DataFrame,每一行或每一列对应一个Series的展开结果。

如何判断apply结果形状
- 返回标量:函数返回单个数值或字符串,结果一定是Series。
- 返回Series:函数返回一个Series,结果变成DataFrame,行数或列数等于原形状。
- 返回列表:函数返回列表,结果默认化为DataFrame,每个元素一列,除非你手动指定输出类型。
- 返回其他对象:如字典、元组,pandas会尝试将其转换为Series或DataFrame,有时会引发意外类型,需要提前测试。
业内专家指出,清晰掌握apply结果的类型非常重要,因为后续操作如合并、索引调整都依赖对形状的准确理解,如果你不确定,可以先在小数据集上使用type()函数检查返回类型,再扩大应用范围。
Pandas apply性能对比:如何高效优化apply结果计算
apply性能一直是个热议话题,行业共识认为,在中小规模数据下apply足够好用,但一旦数据量突破十万行,单次apply的耗时就会明显增加,核心原因在于apply本质上是一个隐式循环,每次迭代都调用Python函数,无法利用底层C语言的向量化能力。
优化方法清单
- 优先使用向量化操作:比如用
df['列'] 2代替df['列'].apply(lambda x: x2),速度能提升几个数量级。 - 使用内置函数:如
pd.to_datetime、str.extract等,避免自定义函数。 - 改用transform:当需要按组计算时,transform比apply更快,且能保留原始索引。
- 利用swifter库:swifter自动判断能否向量化,否则自动并行化apply,实测可提速30%以上。
- 拆分数据批次:对超大DataFrame,可以分块处理,每块使用apply,最后合并结果,减少内存峰值。
对比场景:apply vs 循环 vs 向量化
| 操作方式 | 百万行数据耗时(估算) | 适用场景 |
|---|---|---|
| 原生Python循环 | 数秒至数十秒 | 不适合大数据 |
| pandas apply | 秒级(取决于函数复杂度) | 中等规模,复杂逻辑 |
| 向量化操作 | 毫秒级 | 纯数值或正则表达式等简单变换 |
| swifter apply | 比普通apply快2-5倍 | 多核可用,函数可并行 |
注意这些耗时是相对值,实际取决于你的机器配置和数据特点,据统计,大多数数据清洗任务中,用向量化方式改写后,apply结果计算的效率能提升至少一个数量级。
常见apply结果错误与解决方案
apply结果不正常,往往集中在几个典型问题上,掌握这些错误模式,能帮你快速定位问题。
apply结果为空
- 原因:函数返回了None或空对象,或者apply作用在空DataFrame上。
- 解决:检查函数逻辑,确保返回值非空;使用
dropna()先清理空行;如果数据本身为空,apply结果自然为空,属于正常现象。
类型转换错误
- 问题:apply结果列的类型从int变成float,或object变成datetime。
- 原因:函数返回类型不一致,比如某行返回int,某行返回float,pandas会统一提升为object或float。
- 解决:在函数内强制类型转换,如
return int(x);或者用astype()在apply后统一调整类型。
索引混乱
- 问题:apply结果索引与原DataFrame索引不一致,导致合并时出错。
- 原因:函数内部改变了索引,或者apply返回的是新的Series,索引重置了。
- 解决:在apply调用时指定
result_type='expand'或result_type='reduce'来控制索引行为;或者合并前重置索引。
实战案例:从apply结果到数据清洗完整流程
假设你有一个用户行为数据,包含用户ID、登录时间、页面浏览量,你需要对每个用户计算最近7天登录天数的占比,并标记活跃用户。
实现步骤
- 按用户分组:
grouped = df.groupby('user_id') - 定义核心函数:计算该用户登录时间在最近7天内的比例,返回占比值。
-
使用transform:
df['活跃度'] = grouped['登录时间'].transform(calc_ratio) - 标记活跃用户:
df['活跃标签'] = df['活跃度'].apply(lambda x: '高' if x > 0.7 else '中' if x > 0.3 else '低')
这里关键的一步是transform,它返回与原DataFrame相同形状的Series,避免了索引错乱,如果你非要用apply,需要先分组再apply,结果合并时注意索引对齐,apply结果是一个Series,直接赋值给新列即可。
Python apply结果常见问题解答
apply结果为什么是Series而不是DataFrame?
当你的函数返回一个标量(如整数、字符串)时,pandas默认将apply结果压缩成Series,因为每一行或每一列只有一个输出值,如果你希望得到DataFrame,可以让函数返回Series或字典,或者使用apply的result_type='expand'参数强制展开。
如何将apply结果合并回原数据框?
最简单的方法是直接赋值:df['新列'] = df['列'].apply(func),如果apply返回的是多列Series,可以用pd.concat([df, df.apply(func, axis=1, result_type='expand')], axis=1),注意结果索引必须与原DataFrame索引一致,否则合并前需要先用reset_index(drop=True)对齐。
apply结果性能太差,还有哪些替代方案?
除了向量化操作和transform,还可以使用pandas.DataFrame.eval()或numpy的通用函数(ufunc),如果业务逻辑确实复杂,可以考虑用numba编译自定义函数,或者将数据导出到数据库用SQL窗口函数处理,选择哪种方案取决于你的数据规模、开发效率和维护成本,没有绝对的最优解。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/500688.html