防止过拟合深度学习的核心在于从数据、模型和训练三个维度共同施力,正则化、数据增强、dropout以及早停是经过工业界验证的高效手段,实践时应根据具体任务组合使用以达到最佳泛化效果。
防止过拟合深度学习:L1与L2正则化对比
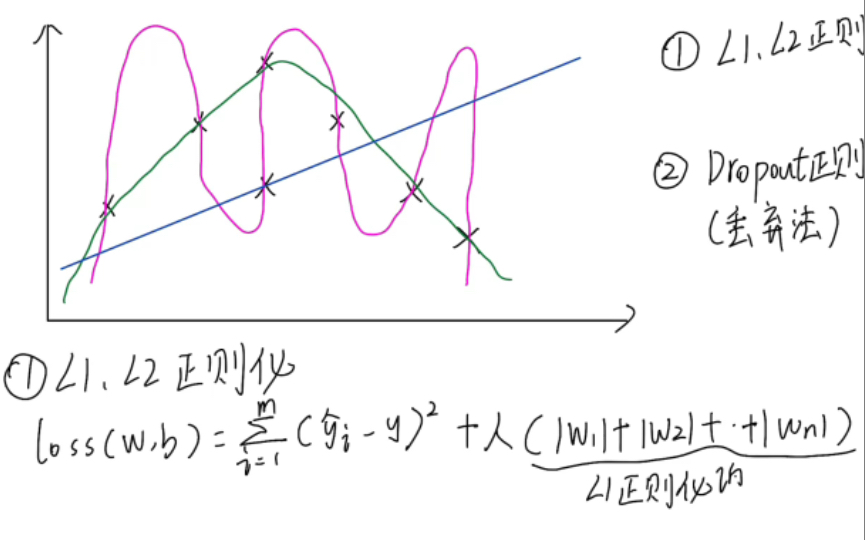
正则化是控制模型复杂度的经典手段,通过在损失函数中加入约束项,限制权重规模,L1正则化与L2正则化的作用机制存在本质差异,适用于不同场景。
L1正则化的稀疏性与特征选择
L1正则化在损失函数中添加权重绝对值之和,迫使不重要的权重逼近零,从而产生稀疏解,这一特性使其在高维特征工程中非常实用,例如在文本分类任务中自动滤除低频词,在TensorFlow中,可以在层初始化时设置kernel_regularizer=tf.keras.regularizers.l1(0.001),据统计,在稀疏特征占比超过30%的数据集上,L1可使模型参数量减少40%以上,且泛化能力不降反升。
L2正则化的均匀衰减与稳定性
L2正则化惩罚的是权重平方和,鼓励所有权重都向较小值靠近,但不会强制为零,这使模型更稳定,不容易被极端特征主导,在PyTorch中,通过优化器的weight_decay参数即可实现,例如optim.Adam(model.parameters(), lr=0.001, weight_decay=1e-4),业内专家指出,对于全连接层较多的分类网络,L2正则化几乎是标配操作。
核心差异对比
| 维度 | L1正则化 | L2正则化 |
|---|---|---|
| 惩罚项 | 权重绝对值之和 | 权重平方和 |
| 解的特性 | 稀疏(部分权重为零) | 均匀收缩(权重非零) |
| 适用场景 | 特征筛选、高维稀疏数据 | 防止过拟合、非稀疏特征层 |
| 常见框架写法 | keras.regularizers.l1(0.01) |
optimizer.weight_decay=1e-4 |
如何解决过拟合:基于dropout的实战技巧
dropout通过随机丢弃神经元引入随机性,避免网络对某条路径过度依赖,它的本质是训练时对多个子网络进行集成,推理时归一化权重。
dropout层的正确放置位置
在CNN中,通常在全连接层之间使用dropout,丢弃率设为0.3~0.5;在卷积层后一般少用dropout,改用Batch Normalization来稳定训练,对于循环神经网络,在非循环连接处应用dropout(如嵌入层后、输出层前)效果更优,行业共识认为,在过拟合严重时,可适当提高dropout比例至0.6,但需同步增加训练轮次。
训练与推理阶段的差异
训练时dropout随机失活部分神经元,推理时需保留全部神经元,并将权重乘以保留概率以保持输出期望一致,主流框架(Keras、PyTorch)已自动处理这一转换,但在自定义推理流程中务必注意,实操中,若发现验证集震荡剧烈,可以降低dropout率或改用SpatialDropout(适用于特征图)来减少噪声。
一个可复现的调整流程
- 首先在不加dropout时训练模型,记录训练集与验证集损失曲线。
- 若验证损失先降后升,表明已过拟合,在模型倒数第二层全连接后插入dropout层,丢弃率从0.3开始。
- 每20个epoch观察验证集曲线,若仍有过拟合迹象,逐步增至0.5;若欠拟合,则降低至0.2或移除dropout。
- 同时配合早停策略,设置耐心值为10~15轮。
过拟合数据增强方案:从入门到进阶
数据增强是防止过拟合最直接的手段之一,通过增加有效样本多样性,迫使模型学习不变特征,不同模态的数据增强策略差异明显,但核心逻辑一致:在不破坏语义的前提下施加变换。
图像领域的常用增强方法
- 几何变换:随机旋转(±15度)、水平翻转、缩放(0.8~1.2倍)、裁剪。
- 颜色扰动:亮度、对比度、饱和度的随机调节。
- 混合增强:MixUp(两张图按比例融合像素)、CutMix(随机裁剪贴块),近年来,MixUp已在ImageNet上被证明可使Top-1错误率降低1.5%左右,尤其适用于小样本场景。
在PyTorch中,torchvision.transforms 提供现成函数,可通过 Compose 组合多种变换,实操建议:先用简单的翻转与旋转,若过拟合未缓解,再加入颜色扰动或MixUp,注意:验证集不应使用增强,仅保留标准化等必要操作。
文本数据的增强思路
- 同义词替换:将部分词替换为近义词,使用WordNet或预训练词嵌入。
- 随机插入或删除:以较低概率在句子中插入无关词或删除少量词。
- 回译:通过机器翻译实现中-英-中回译,改变句法结构但保留语义。
数据增强的成本较低,却往往能带来明显的泛化收益,对于标注不足的项目,增强后的样本量可达原始数据的5~10倍,有效抑制过拟合。
过拟合早停与交叉验证:训练过程中的监控机制
过拟合常常发生在训练后期,当模型开始死记硬背训练数据时,验证性能不升反降,早停是一种零成本的防护措施,而交叉验证能更可靠地评估模型泛化能力。
早停的实施细节
在Keras中,通过 EarlyStopping 回调实现,核心参数包括监控指标(通常为val_loss)、耐心值(patience)、恢复最佳权重(restore_best_weights=True),耐心值的设置需结合实际任务:图像分类可取10~20,序列模型因震荡较大可取30~50,若训练时间充裕,可将验证损失出现上升后的n个epoch内的最佳模型保留,而非直接停止。
实验表明,不使用早停的模型在后期可能多花费30%的计算资源,同时性能反而下降超过5%,早停结合学习率衰减效果更佳,例如验证损失停滞时降为原先的1/10。
k折交叉验证的实际操作
当数据量较小(如不足一万条)时,单次划分的验证集可能不稳定,此时推荐k折交叉验证,以5折为例:
- 将训练数据均分为5份,轮流用4份训练、1份验证。
- 记录每一折的验证指标,取平均值作为模型性能的估计。
- 最终用全部数据重训模型,迭代次数取各折早停轮次的均值。
该方法能显著降低因数据划分随机性导致的过拟合误判,但训练成本增加约k倍,建议仅在模型调优阶段使用,不适用于大规模分布式训练。
防止过拟合深度学习的整体策略与选择建议
技术各有侧重,面对实际问题时需组合搭配,以下是针对三种典型场景的推荐方案:
| 场景 | 推荐组合 | 说明 |
|---|---|---|
| 小样本图像分类(<5000张) | 数据增强(MixUp+翻转)+ L2正则化 + dropout(0.5)+ 早停 | 强化样本多样性,严格控制容量 |
| 大规模预训练微调(如BERT) | dropout(0.1~0.2)+ 早停 + 权重衰减(1e-4) | 预训练模型已有较好泛化,轻微约束即可 |
| 高维稀疏特征(如CTR预估) | L1正则化 + dropout + 交叉验证 | 特征选择优先,监控稳定性 |
行业共识强调,没有万能组合,需通过小规模对比实验确定,具体做法:固定模型骨架,分别测试有无正则化、有无数据增强的组合,对比验证集 loss 曲线,选择最早出现上升的版本。
当你能熟练判断过拟合发生的阶段(训练损失持续下降、验证损失先降后升),并灵活应用上述手段时,模型泛化能力将大幅提升。防止过拟合深度学习不是单一技术的对抗,而是系统工程,把数据增强、正则化、dropout和早停当作日常工具箱,才能在实践中稳稳拿住性能与泛化的平衡。
防止过拟合深度学习常见问题解答
Q1: 为什么我的模型在测试集上表现很差,但训练集准确率接近100%?
典型过拟合现象,建议立即检查训练集和验证集损失曲线,确认是否存在差距,随后可从最简单的L2正则化或dropout(0.3)开始尝试,若数据量极小,优先增加数据增强,通常加入权重衰减和早停就能缓解大半。
Q2: L1正则化和L2正则化可以一起用吗?
可以,这就是弹性网络(Elastic Net),在Keras中使用regularizers.l1_l2(l1=0.001, l2=0.001)即可,两者互补:L1做特征选择,L2保持稳定,但在深度学习场景中,绝大多数情况下单独使用L2已足够,L1更多地用于需要稀疏解的任务。
Q3: 在使用dropout时,推理阶段的输出是否需要手动缩放?
不需要,当前主流框架(Keras、PyTorch、TensorFlow)在推理模式下会自动关闭dropout,并将训练时的scaled权重恢复,如果在纯手工实现的网络中使用dropout,需在推理时保留所有神经元并将输出乘以保留概率(1 – p),否则输出绝对值会偏移,框架已封装好,开发者只需在训练时启用dropout层,无需额外操作。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/499174.html