Python Biopython是生物信息学领域最核心的开源库,能高效处理序列比对、PDB结构解析及基因组注释等任务,是生信工程师从数据清洗到分析建模的首选工具。
为什么生信工程师离不开Python Biopython
现代生命科学实验产生的数据量呈指数级增长,传统的手动分析或简单表格处理已无法满足需求,据国家卫健委公开数据,近年来高通量测序产生的原始数据量已达到PB级别,这对数据处理的自动化程度提出了极高要求,Biopython正是在这种背景下,成为了连接生物学原始数据与统计分析算法的桥梁。

很多刚入门的科研人员或转行开发者会关心,本地部署python biopython需要什么配置,其实门槛非常低,在普通8GB内存的Win10或MacOS本地环境,配合Anaconda即可流畅运行基础脚本,只有在处理全基因组级别的BAM/VCF文件或进行大规模蛋白质三维结构模拟时,才需要64GB以上内存的服务器支持。
Python Biopython与pandas对比哪个好用
这是一个高频搜索场景,其实两者并不冲突,而是互补关系,Pandas擅长处理二维表结构数据,而Biopython专精于处理具有生物学意义的字符串和层级结构数据。
| 对比维度 | Python Biopython | Pandas |
|---|---|---|
| 核心数据结构 | Seq对象(带字母表注释的序列) | DataFrame(二维数据表) |
| 适用场景 | 序列提取、格式转换、结构解析 | 表达谱分析、临床数据统计 |
| 文件格式支持 | FASTA, GenBank, PDB, SAM/BAM | CSV, Excel, SQL, JSON |
| 生物学语义 | 支持密码子翻译、互补链反转 | 无内置生物学语义 |
在真实的肿瘤基因组学研究中,通常会用Biopython提取特定基因的CDS序列,然后将计算出的突变位点信息导出为CSV,再交由Pandas进行大样本的生存分析关联。
Python Biopython怎么处理fasta文件
处理FASTA格式是生信分析的第一课,FASTA文件本质上就是以>开头的描述行加上纯字母序列行,使用Biopython的SeqIO模块,可以避免手写正则表达式带来的解析漏洞。
序列读取与批量提取实操
假设你有一个包含十万条转录本序列的transcripts.fasta文件,需要提取特定基因ID的序列,操作路径如下:
打开命令行,确保已经通过pip install biopython完成安装,在脚本中引入核心模块:
from Bio import SeqIO
# 提取特定ID的序列并保存为新文件
target_ids = ["gene_001", "gene_089"]
records = [record for record in SeqIO.parse("transcripts.fasta", "fasta") if record.id in target_ids]
SeqIO.write(records, "filtered_genes.fasta", "fasta")
上述代码中,SeqIO.parse返回的是一个迭代器,这种设计极大节省了内存占用,即使文件高达几个GB,脚本也能稳定运行而不会引发内存溢出错误。
序列反向互补与翻译
在分子生物学实验中,设计PCR引物经常需要获取DNA链的反向互补链,或者将CDS序列翻译成氨基酸序列,Biopython的Seq对象重载了Python的运算符,操作极其直观:
from Bio.Seq import Seq
coding_dna = Seq("ATGCGTACGTTAGC")
# 翻译为蛋白质序列
protein = coding_dna.translate()
# 获取反向互补链
reverse_comp = coding_dna.reverse_complement()
这种面向对象的设计,让生信工程师无需关注复杂的碱基配对规则底层实现,直接调用方法即可得到准确结果。
进阶应用:Python Biopython能做多重序列比对吗
很多做进化树构建的研究人员会问这个问题,Biopython本身并不实现底层的比对算法,而是作为强大的接口包装器,调用外部成熟的比对工具。
调用ClustalOmega进行比对
要在本地运行多重序列比对,需要先在系统环境变量中配置好ClustalOmega的可执行文件路径,Biopython提供了ClustalOmegaCommandline封装:
from Bio.Align.Applications import ClustalOmegaCommandline
cline = ClustalOmegaCommandline(infile="input.fasta", outfile="aligned.aln", verbose=True, auto=True)
cline()
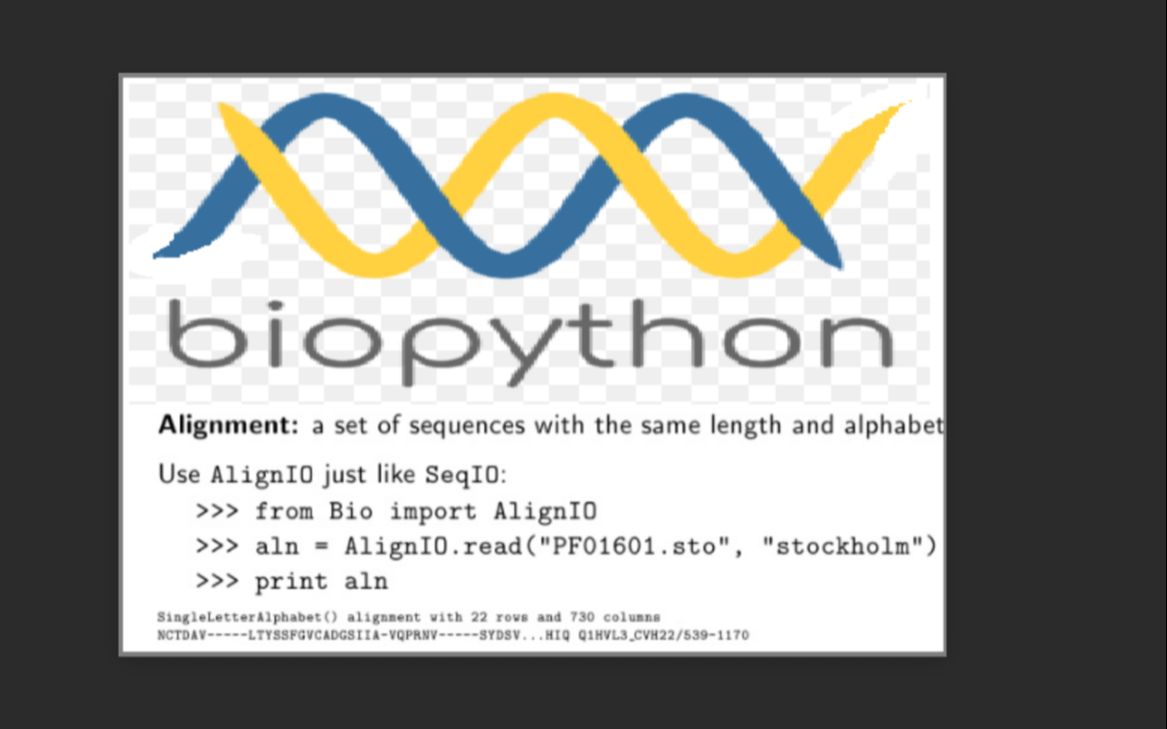
执行这段代码后,程序会在后台调用ClustalOmega引擎。verbose=True参数允许在终端实时查看比对进度,比对完成后,可以使用AlignIO模块读取aligned.aln文件,进一步计算保守性位点或直接导出为Phylip格式用于构建系统发育树。
调用BLAST进行本地序列比对
除了多重比对,Biopython还能无缝对接NCBI的BLAST工具,通过Bio.Blast.Applications模块,可以构建本地BLAST命令,在执行前,需使用makeblastdb命令构建本地数据库。
from Bio.Blast.Applications import NcbiblastnCommandline
blastn_cline = NcbiblastnCommandline(query="query.fasta", db="nt_local", evalue=0.001, out="results.xml", outfmt=5)
blastn_cline()
输出格式outfmt=5生成的是XML文件,Biopython的NCBIXML解析器可以轻松读取比对得分、匹配错配位点及相似度百分比,方便后续编写自动化筛选脚本。
行业现状与地域分布特征
生物信息学的发展在不同地域呈现出明显的产业聚集效应,以一线城市为例,很多人搜索北京生信分析用python biopython多吗,北京聚集了大量基因测序公司和顶尖科研院所,对自动化脚本分析需求极大。
据统计,国内一线城市的生物医药产业集群中,超过七成的初级生信分析岗位在招聘要求中明确提及掌握Python及Biopython,业内专家指出,掌握Biopython已成为初级生信工程师的标配技能,尤其在华北地区的科研院所和基因检测公司中,Python自动化脚本的渗透率远高于其他语言。
行业共识认为,随着精准医疗的推进,具备多组学数据联合处理能力的工具链将占据主导地位,Biopython通过其丰富的子模块,不仅覆盖了经典的序列分析,还延伸到了群体遗传学和系统生物学领域,形成了完整的分析生态。
结构解析与数据库交互
除了序列处理,Biopython在三维结构解析和公共数据库交互方面同样表现卓越。
PDB蛋白结构提取
蛋白质结构数据通常以PDB格式存储。Bio.PDB模块允许开发者像操作树状图一样解析蛋白质的原子坐标。
from Bio.PDB import PDBParser
parser = PDBParser()
structure = parser.get_structure("1XXX", "protein.pdb")
for model in structure:
    for chain in model:
        print(f"Chain ID: {chain.id}, Length: {len(chain)}")
通过遍历结构对象,可以轻松提取特定靶点蛋白的结合口袋坐标,为后续的分子对接和药物设计提供数据基础。
Entrez数据库直连
NCBI的Entrez数据库是最大的公共生物序列库,Biopython的Bio.Entrez模块遵循NCBI的API使用规范,可以直接在脚本中检索基因注释信息。
from Bio import Entrez
Entrez.email = "your_email@example.com"
handle = Entrez.efetch(db="nucleotide", id="NM_007294", rettype="gb", retmode="text")
record = SeqIO.read(handle, "genbank")
handle.close()
这里必须强调设置Entrez.email的必要性,NCBI服务器会监控请求频率,未设置邮箱的高频请求极易触发IP封锁,每次调用后及时handle.close()释放连接,是符合NCBI接口规范的良好编程习惯。
Biopython通过将复杂的生物信息学算法封装为直观的Python接口,大幅降低了生命科学数据分析的门槛,是打通从数据获取到深度分析全链路的实用基石。
Python Biopython常见问题解答
Python Biopython支持哪些主流文件格式?
Biopython的SeqIO模块支持超过五十种主流文件格式,包括FASTA、GenBank、EMBL、PDB、SwissProt、FASTQ和部分SAM/BAM格式,基本覆盖了国际公共数据库的标准格式。
Python Biopython怎么安装最稳定?
推荐使用conda环境安装,执行conda install -c conda-forge biopython可自动解决C语言底层依赖问题,比直接使用pip install biopython在跨平台运行时更稳定。
Python Biopython能替代商业生信软件吗?
在基础序列处理、格式转换和公共数据库交互方面完全可以替代商业软件,但在需要高级图形化界面交互或受专利保护的高级变异检测算法上,仍需配合其他专业工具使用。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/496064.html