Python import 是模块导入的核心机制,理解其搜索路径、加载过程和常见报错解决方案,是每个Python开发者的基本功。
Python import 的核心机制与搜索路径
import 语句到底做了什么?
当你写下 import os 这行代码时,Python 解释器并不是简单地“找到文件然后执行”,它背后有一套严谨的模块加载流程,这套流程由 sys.path、sys.modules 和查找器/加载器共同配合完成。
第一步:检查缓存
Python 首先会在 sys.modules 字典中查找 os,这个字典就像一个“已加载模块登记表”,所有成功导入过的模块都会存在这里,如果命中,直接返回对象,避免重复加载,所以你会发现,同一个模块无论被导入多少次,实际只加载一次。
第二步:执行查找器
如果缓存中不存在,解释器会按照 sys.path 列表中的路径顺序,依次使用查找器(Finder)去寻找模块。sys.path 是一个字符串列表,初始化时包含:
- 当前脚本所在目录(或空字符串表示当前目录)
PYTHONPATH环境变量中的目录- 标准库目录
- 第三方库安装目录(site-packages)
第三步:加载与执行
找到 .py 文件(或 .pyc、.so 等)后,Python 会创建模块对象,并将其添加到 sys.modules 中,然后执行模块内的代码,把函数、类、变量等绑定到模块对象上,最后在当前命名空间中绑定模块名。
sys.path 搜索顺序:为什么你的模块找不到?
很多新手遇到 ModuleNotFoundError 时一脸懵,根源就在于 sys.path 没包含你期望的路径。python import 本地模块找不到 这个问题,十有八九是路径配置不对。
你可以通过以下命令查看当前环境的搜索路径:
import sys
print(sys.path)
输出类似:
['', '/usr/lib/python39.zip', '/usr/lib/python3.9', ...]第一个元素 代表当前目录,如果你在 /home/user/project 下运行脚本, 就代表 /home/user/project,但如果你是在 IDE 中运行,当前目录可能是项目根目录,而不是你脚本所在子目录,这时,你放在子目录下的模块就无法被直接导入。
解决方案:
- 临时方案:在脚本开头动态添加路径:
sys.path.insert(0, '/path/to/your/module') - 推荐方案:把项目结构设计好,使用
pip install -e .以可编辑模式安装本地包,或者使用相对导入(在包内使用from . import module)。 - 环境变量:设置
PYTHONPATH环境变量,使路径永久生效。
绝对导入与相对导入的区别场景
在包内,你经常看到 from . import utils 这样带点的写法,这就是相对导入,与之对应的是绝对导入,from mypackage.utils import helper。
绝对导入:从项目根目录开始,写出完整的模块路径,优点是清晰,缺点是项目改名或移动时,所有导入路径都得改。
相对导入:使用 表示当前包, 表示上一级包,只在包内可用,不能在顶层脚本中使用,它让包内部结构更灵活,但可读性稍差,且容易让新手混淆。
行业共识认为,Python 官方建议在包内优先使用相对导入,以增强包的可移植性,但在大型项目中,绝对导入更受青睐,因为查找方便。
python import 和 from import 区别到底在哪?一表看懂
很多初学者在写代码时,会纠结到底用 import 还是 from ... import ...,其实关键区别在于命名空间和代码可读性,我们用一张对比表来直观展示:
| 对比维度 | import 模块 | from 模块 import 某个对象 |
|---|---|---|
| 语法示例 | import os |
from os import path |
| 命名空间 | 保留模块名作为前缀,如 os.path.join() |
直接将对象导入当前命名空间,可直接用 path.join() |
| 内存占用 | 只加载模块对象,但通过模块名访问内部对象 | 直接引用该对象,不加载整个模块对象到当前命名空间 |
| 代码可读性 | 明确知道函数来自哪个模块,适合大型项目 | 简洁,但若大量使用容易造成命名冲突,阅读者难以定位来源 |
| 重载影响 | 使用 importlib.reload(module) 后,通过模块名访问的总是最新对象 |
若直接导入了对象,重载后该引用不会更新,导致 bug |
语法差异与命名空间
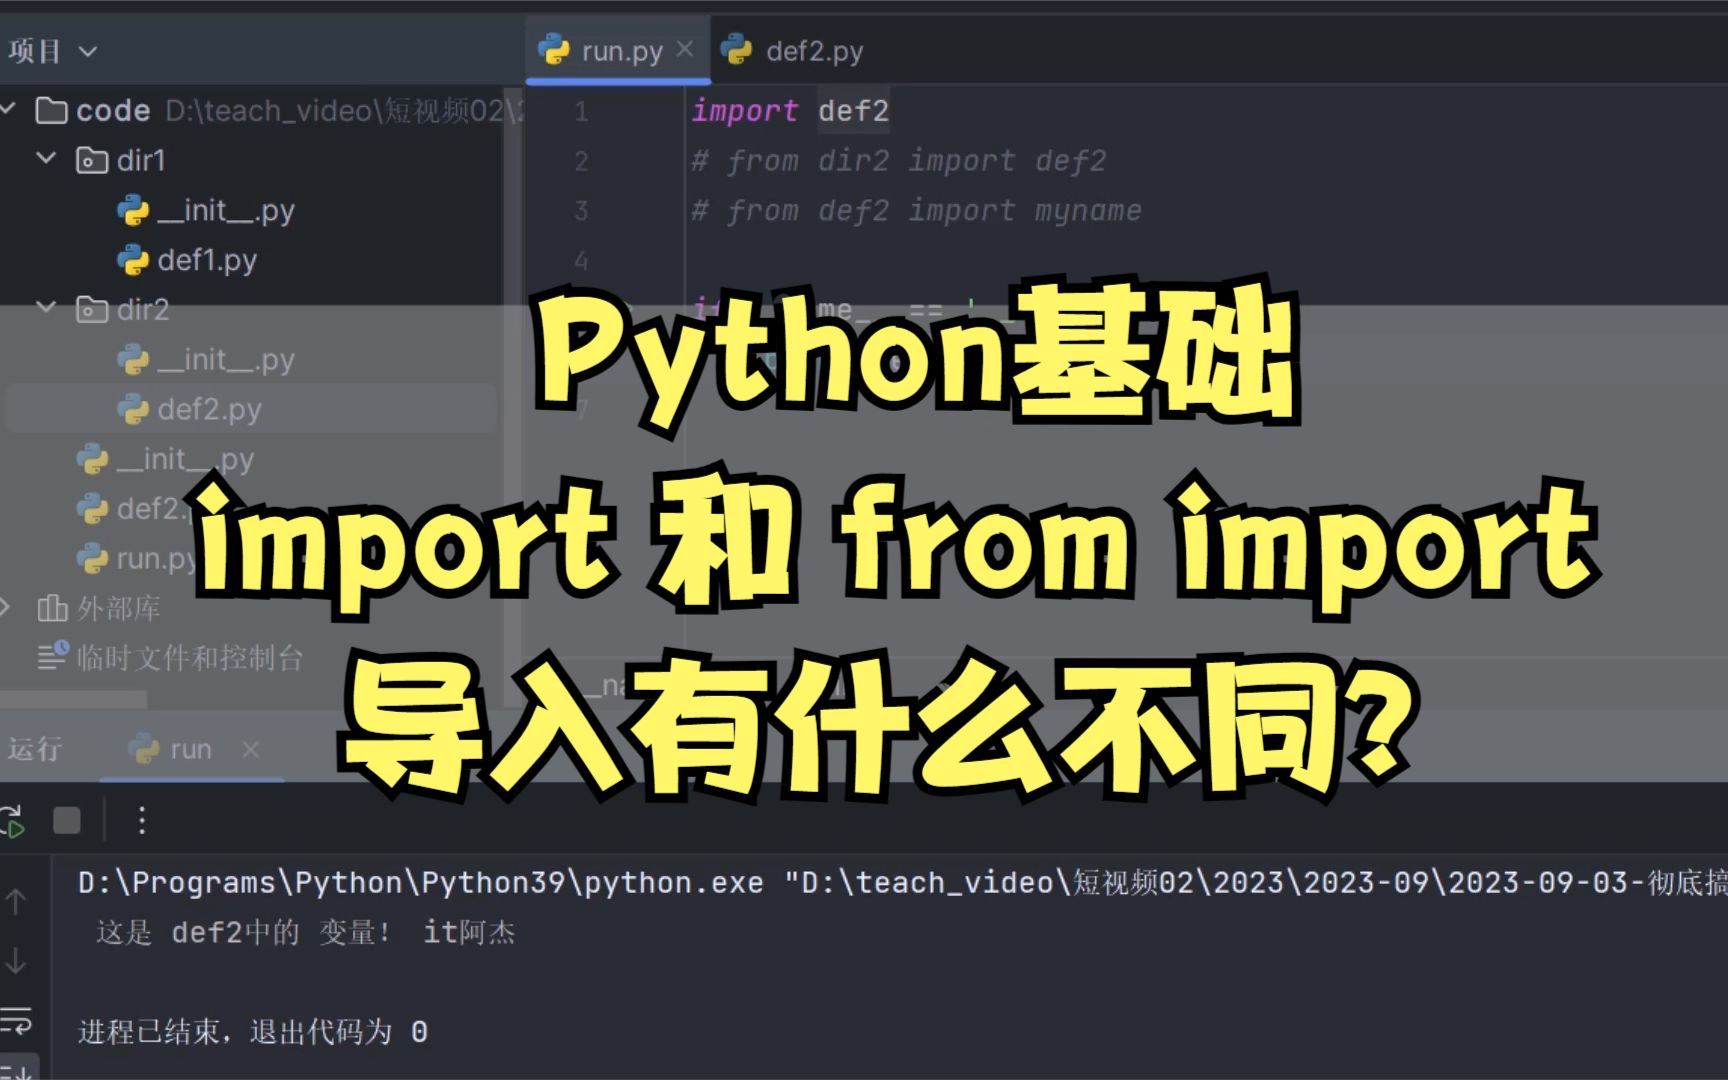
import 语句会将整个模块作为一个对象绑定到当前命名空间,这意味着你访问其内部函数时,必须带上模块名作为前缀,而 from ... import ... 则是将指定的名称直接导入当前命名空间,让其成为“本地变量”。
举个例子,如果你同时使用 from math import sqrt 和 import math,那么你既有 sqrt(9) 的直接调用,也有 math.sqrt(9) 的完整调用,但如果你在代码中定义了自己的 sqrt 函数,就会覆盖 from math import sqrt 导入的那个,不会影响 math.sqrt。
性能与内存占用对比
有人担心 from XXX import 会加载一大堆用不到的东西,占用内存,Python 的模块导入机制无论你使用哪种形式,都会执行整个模块的代码,并把模块对象放入 sys.modules,区别在于到你当前命名空间的东西有多少。
import module 只在你当前命名空间增加一个对模块对象的引用,内存开销极小,而 from module import name 则会增加一个直接指向模块内该对象的引用,同时模块对象本身依然被加载,在内存占用上两者差异微乎其微,真正的性能差异出现在访问时:module.name 每次需要两次字典查找(先从当前命名空间找到模块,再从模块字典找名字),而直接导入的 name 只需一次,但这在绝大多数场景下可以忽略不计。
实际项目中的最佳实践
根据 PEP 8 规范,推荐:
- 优先使用
import module形式,尤其是标准库或第三方库,以保持命名空间清晰。 - 当你需要频繁使用某个模块内的特定函数,且该函数名字不会引起冲突时,可以使用
from module import name。 - 绝对禁止使用
from module import,除非你在交互式环境或明确知道模块的__all__列表,否则会污染命名空间。
python import 模块报错怎么解决?专业排查步骤
导入报错是每个 Python 开发者都会遇到的坎。python import 模块报错怎么解决 的关键在于读懂异常类型,并有条理地排查,下面给出一个经过验证的排查流程。
ModuleNotFoundError 的五大原因
-
模块未安装
- 症状:
ModuleNotFoundError: No module named 'requests' - 解决:
pip install requests或检查你使用的 Python 环境与 pip 对应的是否一致(which python和which pip)。
- 症状:
-
路径问题
- 症状:
ModuleNotFoundError: No module named 'my_module' - 检查:运行
python -c "import sys; print(sys.path)",确认你的模块所在目录是否在列表中,如果不在,按前述方式添加。
- 症状:
-
文件名冲突
- 症状:你创建了一个名为
email.py的文件,import email报错或导入的是你自己的文件而非标准库。 - 解决:不要用与标准库或第三方库重名的文件名,检查当前目录是否有同名
.py文件。
- 症状:你创建了一个名为
-
包缺少
__init__.py- 在 Python 3.3 之前,目录必须包含
__init__.py才能被识别为包,虽然现在支持隐式命名空间包,但如果你的包内包含模块,最佳实践还是放一个空文件,避免混淆。
- 在 Python 3.3 之前,目录必须包含
-
虚拟环境未激活
- 症状:明明在全局环境安装了,但运行脚本却报错找不到。
- 解决:确认你激活了正确的虚拟环境,
which python应指向虚拟环境下的 Python。
ImportError 与循环导入的破解方法
ImportError: cannot import name 'xxx' 通常发生在你尝试从一个模块中导入某个还不存在的名字时,最常见的原因就是循环导入。
python import 循环导入 的发生场景:模块 A 导入模块 B,模块 B 又导入模块 A,形成一个死锁,Python 解释器在加载模块时,如果遇到循环,会先创建空模块对象并放入 sys.modules,然后继续执行,但此时模块内的代码可能还未执行完毕,导致导入的名字不存在。
解决方案:
- 重构代码:将公共依赖提取到第三个模块 C 中,A 和 B 都导入 C。
- 延迟导入:将
import语句放到函数内部,而不是顶部,这样只有在函数调用时才执行导入,避免模块初始化时的循环。 - 使用
import module替代from module import name:因为import module只是导入模块对象,不会立即访问其内部属性,可缓解部分循环。
第三方库导入失败的常见场景
有时候你明明用 pip install 安装了库,但运行脚本还是报错,这通常是因为:
- 你使用的 Python 版本与 pip 安装的版本不一致,系统有 Python 2 和 Python 3,你 pip 安装到了 Python 2 的 site-packages,但运行用 Python 3。
- 权限问题导致安装到用户目录,但某些环境变量未设置。
- 库的依赖未正确安装,导致导入时底层的 C 扩展失败。
解决方案:使用 python -m pip install 显式指定 Python 解释器,检查
pip list 确认安装,对于复杂的依赖,考虑使用虚拟环境。
高级导入技巧与性能优化
动态导入与懒加载
在某些场景,模块的导入可能依赖于运行时的变量,或者你希望延迟导入以加快启动速度,这时,可以使用 importlib 模块。
import importlib
module_name = "requests"  # 可以根据条件动态变化
mod = importlib.import_module(module_name)
# mod 就相当于 import requests
懒加载常用于大型框架,Django 的 django.utils.lazy_import 或你自己的工具函数,通过在 __init__.py 中使用自定义的 __getattr__ 实现按需导入,可以显著减少启动时间。
使用 importlib 模块的高阶技巧
importlib 不仅提供了 import_module,还暴露了导入系统的底层接口,你可以重新加载一个模块而不重启解释器:
import importlib
import my_module
# 修改 my_module 代码后...
importlib.reload(my_module)
这在交互式开发和调试中非常有用,但要注意,reload 不会更新已经通过 from ... import ... 导入的对象,所以最好始终用模块名访问。
冻结导入与打包优化
当使用 PyInstaller、cx_Freeze 等工具将 Python 程序打包成可执行文件时,导入机制会发生变化,这些工具会使用自定义的“冻结导入器”来从打包的数据中加载模块,而不是读取文件系统,了解这一点,有助于你排查打包后“找不到模块”的奇怪问题,需要在打包配置中显式指定隐藏的导入,或者修改 sys.path。
掌握 Python import 的底层逻辑,不仅能让你快速定位导入报错,还能优化项目结构,写出更健壮的代码,从 sys.path 到相对导入,从循环依赖解决到动态导入,每一步都值得你花时间实践。
Q&A
Q: python import 本地模块为什么总是报错找不到?
A: 检查当前工作目录和 sys.path,确保你的模块所在目录在 sys.path 列表中,或者在包内使用相对导入,如果是在 IDE 中,注意运行配置的“工作目录”设置,一个简单的验证方法:在脚本开头 import sys; print(sys.path),然后查看输出是否包含你的模块路径,Python 只会搜索已注册的路径,不加则找不到。
Q: python import 和 from import 在实际项目中如何选择?
A: 如果项目规模较大,团队协作多,优先使用 import module 形式,因为命名空间清晰,能避免命名冲突,且方便代码审查时快速定位来源,如果某个模块中的函数被极高频调用且名字独特,使用 from module import func 也是可以的,但绝对不要用 from module import ,PEP 8 推荐尽量使用 import module 形式。
Q: python import 循环导入怎么彻底解决?
A: 最彻底的方法是重构代码,抽出公共依赖到独立模块,打破循环,如果无法重构,可考虑将导入语句移入函数内部,实现延迟加载,对于简单的属性访问,也可以使用 import module 然后通过 module.attr 访问,而不是试图直接导入属性,这样做可以让模块先完成初始化,然后再访问属性,从而避免循环错误,根据 Python 导入机制,模块在完全执行前,其对象已存在于 sys.modules 中,只是属性可能尚未绑定,因此延迟访问是有效的变通方案。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/496012.html