分布式深度学习平台是通过将计算任务拆分并调度至多台计算节点,利用高速网络和并行算法实现大规模模型高效训练的核心基础设施。
分布式深度学习平台架构设计与核心组件
在构建大规模AI训练环境时,架构设计的优劣直接决定了算力利用率(MFU)的高低,一个成熟的分布式深度学习平台并非简单的多机连接,而是涉及计算、存储、网络以及调度四个维度的深度协同。
计算与存储的解耦逻辑
在传统的单机训练中,数据读取主要依赖本地磁盘或简单的网络挂载,但在分布式场景下,如果存储系统无法支撑高并发的IO请求,计算节点将长时间处于“等待数据”的空转状态。
业内专家指出,随着模型参数量迈向万亿级,单纯依靠增加单机显存已无法解决问题,必须转向更复杂的混合并行策略,架构设计必须实现计算与存储的解耦,高效的平台通常采用并行文件系统(如Lustre或GPFS)作为底层支撑,确保在数百个GPU节点同时请求训练样本时,IO带宽能够线性扩展。
网络通信协议的性能瓶颈
分布式训练的核心挑战在于梯度同步,当每个节点完成前向传播和反向传播后,需要通过通信算法(如All-Reduce)交换梯度信息。
- 通信模式:常见的包括参数服务器(Parameter Server)模式和集合通信(Collective Communication)模式。
- 硬件依赖:在高性能计算集群中,传统的以太网往往会成为瓶颈,行业内普遍采用InfiniBand(IB)网络或RoCE(RDMA over Converged Ethernet)技术,以实现极低的延迟和极高的吞吐量。
- 通信库:底层通常依赖NCCL(NVIDIA Collective Communications Library)来优化GPU间的通信效率。
如何选择高性能分布式训练框架以适配业务需求
面对市场上琳琅满目的工具,开发者往往在“易用性”与“极致性能”之间权衡,选择框架时,不能仅看文档是否齐全,更要看其对显存优化和通信掩盖(Communication Hiding)的支持程度。
数据并行与模型并行的技术路径对比
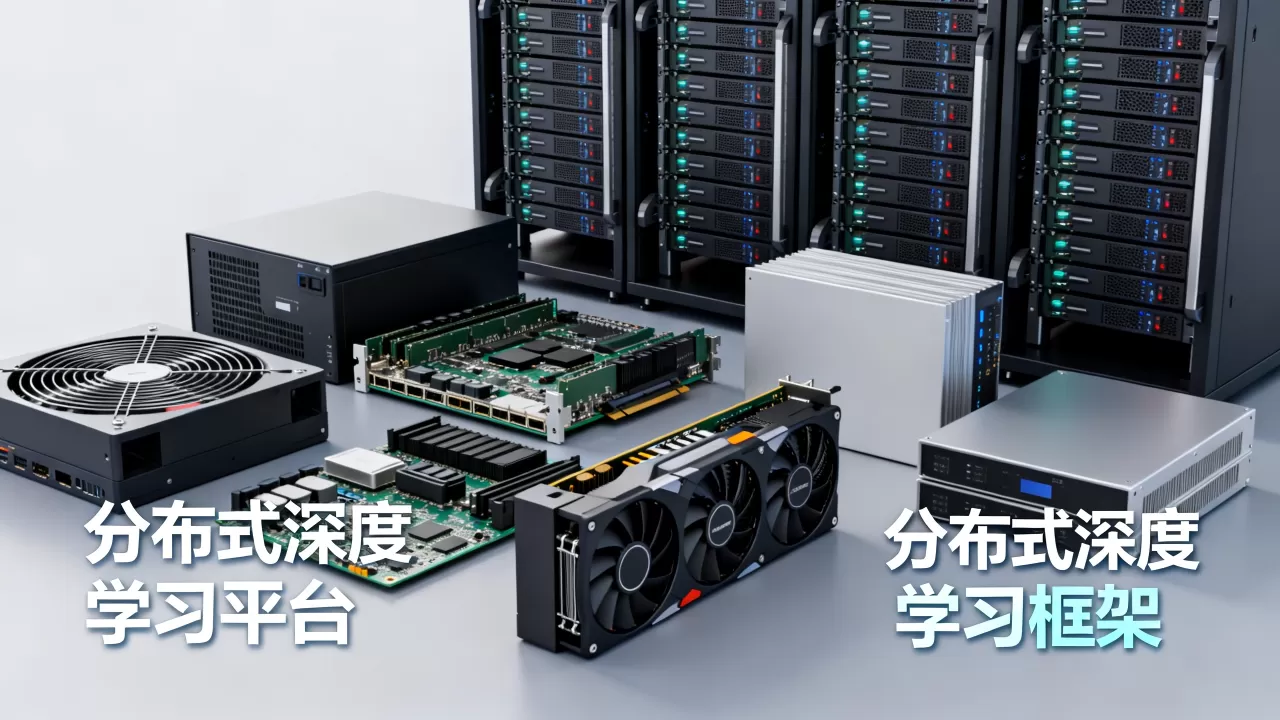
在实际应用中,根据模型大小和数据规模,通常会采用以下几种并行策略:
- 数据并行 (Data Parallelism, DP/DDP):将模型复制到每个GPU上,每个GPU处理不同的数据分片,这是最基础的模式,适用于模型能完全装入单张显卡的情况。
- 张量并行 (Tensor Parallelism, TP):将单层算子(如矩阵乘法)拆分到多个GPU上并行计算,这主要用于解决单层参数过大的问题。
- 流水线并行 (Pipeline Parallelism, PP):将模型的不同层放置在不同的GPU上,通过流水线方式处理数据。
- ZeRO (Zero Redundancy Optimizer):通过消除冗余的优化器状态、梯度和参数,极大地提升了显存利用率,是当前大模型训练的主流技术。
主流框架性能指标对比表
下表展示了当前主流分布式训练框架在不同维度下的表现:
| 框架名称 | 核心优势 | 显存优化能力 | 学习曲线 | 适用场景 |
|---|---|---|---|---|
| PyTorch DDP | 原生支持,生态极丰富 | 中等 | 平缓 | 中小型模型、快速原型开发 |
| DeepSpeed | ZeRO系列技术,显存利用率极高 | 极高 | 较陡 | 万亿级大模型训练、显存受限场景 |
| Horovod | 基于MPI,跨框架兼容性好 | 中等 | 中等 | 多框架混合环境、传统HPC集群 |
| Megatron-LM | 极致的张量并行优化 | 极高 | 非常陡 | 超大规模Transformer模型训练 |
大规模模型分布式训练方案的落地实操
落地一个分布式训练任务,不仅仅是运行一个Python脚本,而是一套涉及环境准备、资源调度和任务监控的工程化流程。
分布式深度学习平台部署流程详解
硬件环境与驱动配置
首先需要确保物理层面的互联,在多机环境下,必须检查节点间的IB网卡状态,确认RDMA功能已开启。
- 检查命令:使用
ibstat查看网卡状态,确保State: Active。 - 驱动版本:确保所有节点的CUDA版本、cuDNN版本以及NVIDIA驱动版本完全一致,否则在进行集合通信时极易出现挂起(Hang)现象。
软件环境与容器化部署
为了避免“在我机器上能跑,在集群上报错”的问题,行业共识认为,使用容器化技术(如Docker + NVIDIA Container Toolkit)是标准做法。
- 构建镜像:基于官方PyTorch镜像,安装特定版本的依赖库。
- 环境隔离:通过容器封装NCCL配置,例如设置
export NCCL_DEBUG=INFO以便在通信故障时快速定位问题。 - 镜像分发:使用私有镜像仓库,确保所有计算节点拉取的镜像版本完全相同。
启动脚本与任务调度
在实际生产中,通常通过Slurm或Kubernetes进行任务调度,以PyTorch原生的 torchrun 为例,启动一个8卡单机多进程任务的典型命令如下:
torchrun --nproc_per_node=8
         --nnodes=2
         --node_rank=0
         --master_addr="192.168.1.100"
         --master_port=6000
         train.py --batch_size 64 --lr 1e-4
在执行过程中,需要实时监控显存占用(nvidia-smi)和网络带宽利用率,如果发现显存波动异常,应立即检查是否触发了显存碎片化,或是否需要开启梯度检查点(Gradient Checkpointing)技术来以时间换空间。
分布式深度学习平台成本对比与投资回报分析
企业在构建平台时,必须考虑算力成本(CAPEX)与运维成本(OPEX)的平衡。
- 自建集群方案:初期投入巨大(高性能GPU、IB交换机、高速存储),但长期来看,对于大规模、高频次的训练任务,单次训练的单位算力成本更低,且数据安全性更高。
- 云端租赁方案:按需付费,无需维护硬件,适合业务波动较大或处于研发初期的团队,但长期运行的成本极高,且受限于云厂商的实例规格。
据统计,在大规模集群环境下,如果通信优化不足,由于等待同步导致的算力浪费可能高达30%至50%,投资于高性能网络和高效的分布式软件框架,其带来的收益往往远超硬件本身的投入。
构建高效的分布式深度学习平台,核心在于通过软硬协同优化,最大化减少计算节点的空转时间,实现模型训练效率与硬件成本的最优解。
分布式深度学习平台相关常见问题
分布式训练时频繁出现 NCCL Timeout 是什么原因?
这通常由网络通信异常或计算节点负载不均衡引起,常见原因包括:网络交换机丢包、节点间防火墙拦截了通信端口、或者某个节点因显存溢出(OOM)导致进程崩溃,进而导致其他节点在等待同步时超时。
如何解决大规模训练中的显存不足问题?
可以通过以下三种路径解决:第一,使用混合精度训练(Mixed Precision Training),将FP32转换为FP16或BF16;第二,启用梯度检查点(Gradient Checkpointing)技术,通过在反向传播时重新计算部分激活值来节省显存;第三,采用ZeRO等优化技术,将优化器状态和参数分布到不同节点上。
分布式训练的加速比(Scaling Efficiency)如何计算?
加速比可以通过总训练时间的变化来衡量,公式为:加速比 = 单机训练时间 / (分布式训练时间 + 通信开销时间),理想情况下,随着节点数增加,加速比应趋近于线性增长,但实际中受限于通信带宽,加速比通常会随规模扩大而逐渐下降。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/494727.html