Flume采集MySQL数据库的核心是通过Canal或Sqoop等中间件将数据库变更或全量数据转化为流式事件,再由Flume进行传输与分发,最终实现结构化数据向大数据平台(如HDFS、Kafka)的实时或批量同步。
Flume采集MySQL数据怎么配置?
Flume本身并不具备直接解析MySQL二进制日志(Binlog)的能力,因此在实际生产环境中,通常采用 Canal + Flume 的组合模式,Canal模拟MySQL从库,通过解析Binlog将数据变更实时推送给Flume。
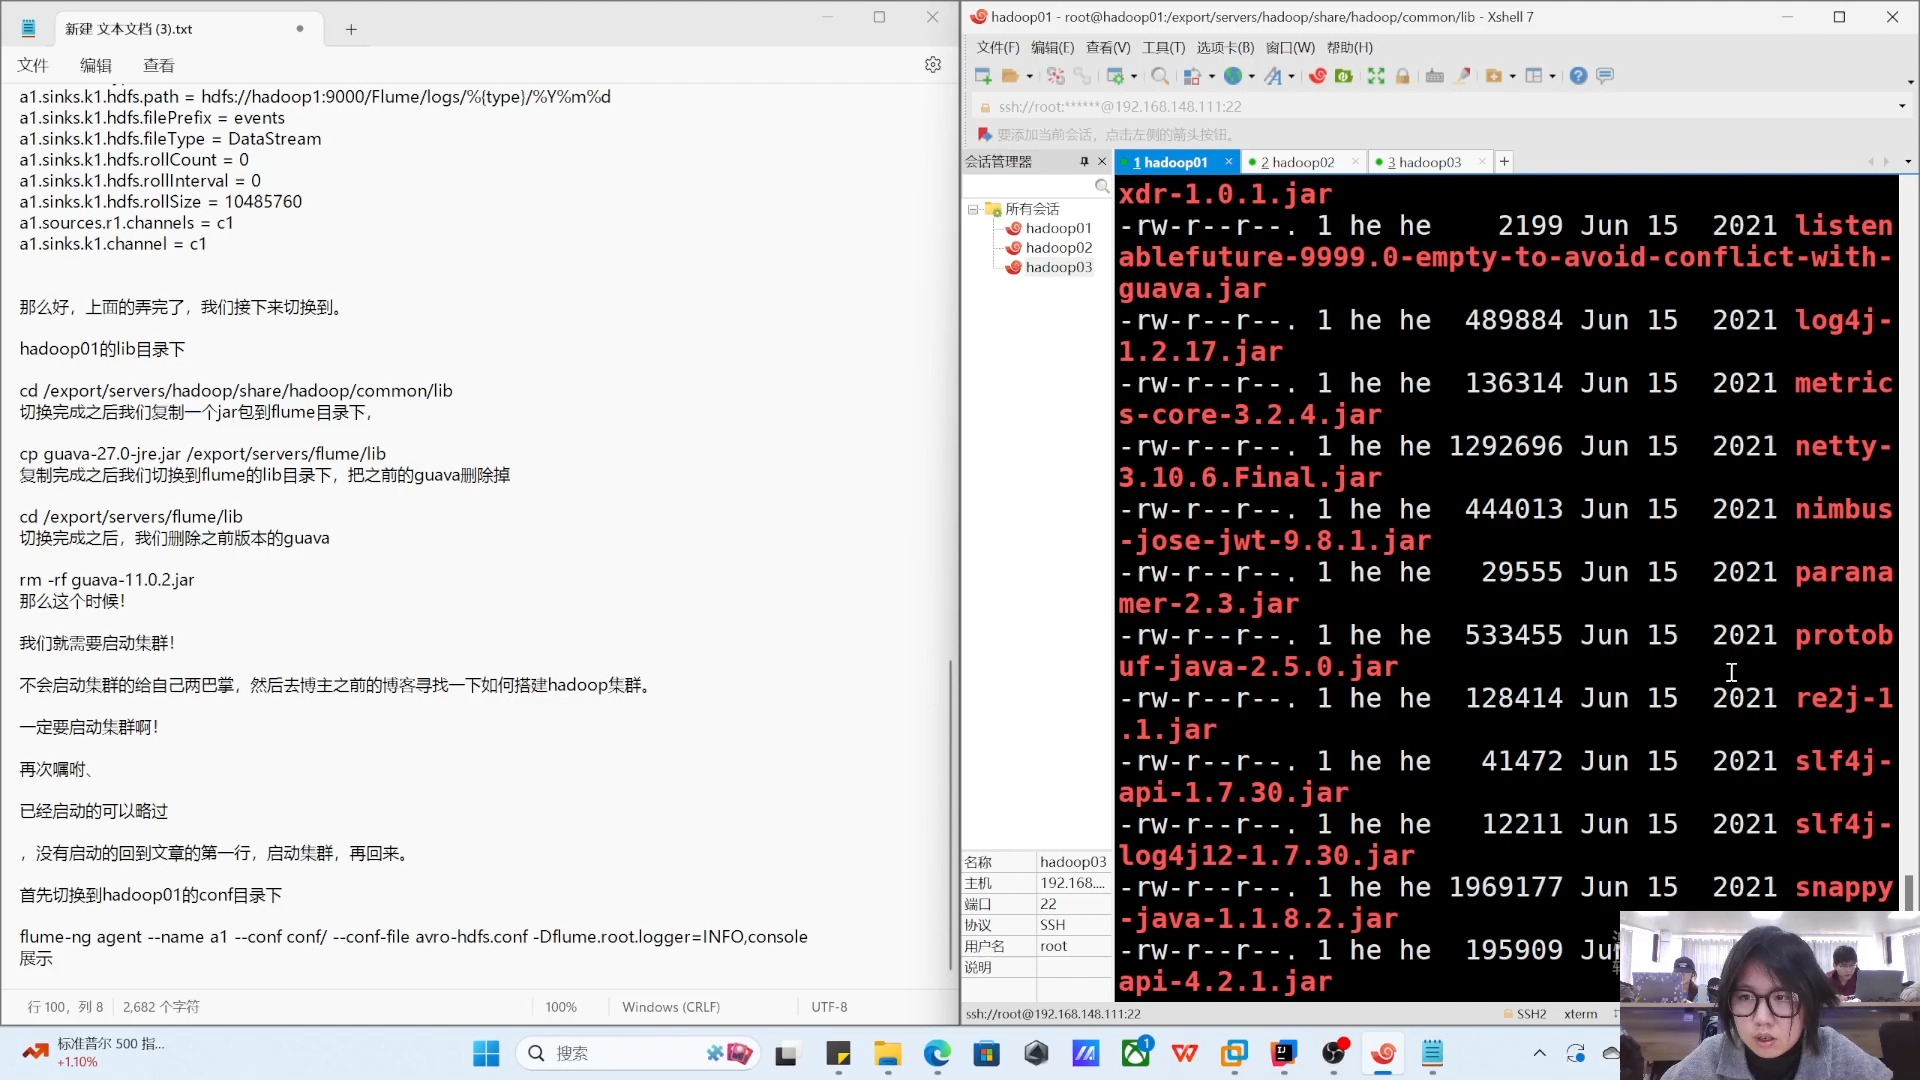
环境准备与MySQL端配置
在启动采集前,必须开启MySQL的Binlog日志,否则Canal无法获取数据变更。
- 修改
my.cnf或my.ini文件,添加以下配置:log-bin=mysql-bin:开启二进制日志。binlog-format=ROW:必须设置为ROW模式,确保记录每一行数据的变更。server-id=1:设置唯一的服务器ID。
- 创建同步账号并授予权限:
- 执行
GRANT SELECT, REPLICATION SLAVE, REPLICATION CLIENT ON . TO 'canal'@'%'; - 执行
FLUSH PRIVILEGES;
- 执行
Canal端核心配置路径
Canal作为数据抓取层,其核心配置文件位于 conf/canal.properties。
- canal.instance.master.address:填写MySQL主库的IP和端口(如
168.1.10:3306)。 - canal.instance.dbUsername:填写上述创建的
canal用户名。 - canal.instance.dbPassword:填写对应密码。
- canal.instance.filter.regex:配置需要采集的数据库和表名,格式为
db.table。
Flume端配置逻辑
Flume在此时扮演的是传输角色,通常使用 CanalSource(第三方插件)或通过 Kafka 作为缓冲。
- Source配置:定义
canal.source,指定Canal服务器的IP和端口,订阅特定的Topic。 - Channel配置:建议使用
Memory Channel保证高性能,或使用File Channel保证数据不丢失。 - Sink配置:根据目标端选择
HDFS Sink或Kafka Sink,配置hdfs.path为/user/hive/warehouse/mysql_data。
Flume与Canal对比哪个更适合MySQL采集?
在构建数据管道时,很多开发者会混淆这两个组件的功能,它们不是竞争关系,而是协作关系。
功能定位差异
- Canal:专注于 CDC(Change Data Capture),它解决了“如何从MySQL拿到变更数据”的问题,将数据库的增删改操作转化为JSON格式的事件流。
- Flume:专注于 数据传输(Data Ingestion),它解决了“拿到数据后如何高效、可靠地发往目的地”的问题,提供强大的路由和聚合能力。
方案对比分析表
| 维度 | 纯Sqoop采集 (批量) | Canal + Flume (实时) | Flink CDC (现代方案) |
|---|---|---|---|
| 实时性 | T+1 或 定时触发 | 秒级延迟 | 毫秒级延迟 |
| 对数据库压力 | 高(全表扫描) | 低(读取Binlog) | 低(读取Binlog) |
| 配置复杂度 | 低 | 中 | 高 |
| 适用场景 | 离线报表、历史数据迁移 | 实时数仓、缓存同步 | 复杂实时计算、流处理 |
| 数据一致性 | 强(快照) | 最终一致性 | 强一致性(Checkpoint) |
业内专家指出,对于追求极低延迟且需要处理复杂转换的场景,Flink CDC 正在逐步取代 Canal+Flume 组合,但对于简单的“采集-传输-存储”链路,Flume 的部署成本和维护难度依然具有优势。
Flume采集MySQL数据库实时同步方案
在企业级架构中,为了保证高可用性和数据不丢失,不能简单地将 Canal 直接对接 Flume,而应引入
Kafka 作为解耦层。
推荐的架构链路
MySQL $rightarrow$ Canal $rightarrow$ Kafka $rightarrow$ Flume $rightarrow$ HDFS/Hive
- 解耦压力:MySQL在高峰期产生的大量Binlog会瞬间冲击Flume,Kafka作为缓冲区可以起到削峰填谷的作用。
- 多订阅支持:同一份MySQL变更数据,可以通过Kafka分发给Flume(存入HDFS)和另一个实时计算引擎(如Spark Streaming进行实时分析)。
- 容错机制:如果Flume端宕机,数据仍保存在Kafka中,重启后可根据Offset继续消费。
关键实操步骤
- Kafka Topic创建:创建名为
mysql_cdc_topic的主题,设置分区数以匹配Flume的并行度。 - Canal推送至Kafka:在
canal.properties中配置canal.server.tcp.port,并使用 Canal 的 Kafka 适配器将解析后的 JSON 数据发送至 Kafka。 - Flume消费Kafka:
- Source使用
KafkaSource,配置kafka.broker和kafka.topic。 - Sink使用
HDFS Sink,配置hdfs.fileType为SéquenceFile或Text。 - 设置
hdfs.rollInterval(滚动时间)和hdfs.rollSize(滚动大小),避免产生过多小文件。
- Source使用
避坑指南:Flume采集MySQL时的常见性能瓶颈
在实际部署过程中,很多团队会遇到数据积压或丢失的问题,这通常与配置参数的不匹配有关。
解决小文件问题
Flume 写入 HDFS 时,rollInterval 设置过短,会产生海量小文件,严重拖慢 HDFS 的 NameNode 性能。
- 优化方案:将滚动时间设置为 3600秒(1小时) 或根据数据量设置
rollSize为 128MB。
内存溢出与背压处理
当 MySQL 发生大批量更新(如 UPDATE 全表)时,Canal 产生的消息量会激增,导致 Flume 内存溢出。
- 优化方案:
- 将
Memory Channel替换为File Channel,将数据持久化到磁盘。 - 增加 Flume JVM 堆内存,修改
flume-env.sh中的-Xmx参数。 - 增加 Kafka 分区数,并部署多个 Flume Agent 组成集群并行消费。
- 将
数据重复与丢失风险
由于网络波动或重启,可能会出现重复消费或数据丢失。
- 行业共识认为,在 CDC 链路中应追求 至少一次(At-least-once) 语义,并在下游(如 Hive 或 ClickHouse)通过主键 ID 进行 幂等性处理(Upsert 操作),从而消除重复数据的影响。
MySQL数据同步到HDFS的成本与性能分析
从资源消耗来看,基于 Flume 的采集方案属于中低成本方案。
- 计算资源:Canal 占用 CPU 较低,主要压力在内存解析;Flume 主要是 IO 密集型,对 CPU 要求不高。
- 存储成本:Binlog 开启后会增加 MySQL 磁盘占用,需配置
expire_logs_days自动清理过期日志。 - 运维成本:需要维护 Canal Server、Zookeeper(用于集群管理)和 Flume Agent,组件链路较长。
据统计,在处理日增量数据在 1TB 以下的场景中,Canal+Flume+Kafka 的组合在稳定性与开发周期之间达到了较好的平衡。
Flume采集MySQL数据库的最佳实践是采用 Canal解析Binlog $rightarrow$ Kafka缓冲 $rightarrow$ Flume传输的链路,通过合理配置滚动策略和幂等机制,可构建一套高可靠的实时数据同步系统。
Flume采集MySQL数据库常见问题Q&A
Flume采集MySQL时如何处理表结构变更(DDL)?
Canal 可以捕获 DDL 语句,但 Flume 仅仅将其作为字符串传输,如果下游是 Hive,需要手动或通过脚本在 Hive 中执行对应的 ALTER TABLE 操作,否则会导致数据写入失败或字段错位。
Flume采集MySQL数据库实时同步方案如何保证顺序性?
为了保证数据顺序,必须确保同一张表的变更数据进入 Kafka 的同一个 Partition 中,可以通过在 Canal 端配置以 表名 或 主键 作为 Kafka 的 Partition Key,从而保证 Flume 消费时的顺序与 MySQL 产生 Binlog 的顺序一致。
采集过程中出现数据延迟怎么排查?
首先检查 MySQL Binlog 产生速度与 Canal 解析速度的差值;其次查看 Kafka 的 Consumer Lag(消费积压量);最后检查 Flume Sink 端的 HDFS 写入速度,如果瓶颈在 Sink 端,应考虑增加 Flume 实例数量或优化 HDFS 写入参数。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/494449.html