Python如何实现对象克隆,浅拷贝和深拷贝有什么区别?

Python 对象克隆详解

在 Python 中,“克隆”通常指的是创建现有对象的副本,由于 Python 的变量实际上是对对象的引用,直接使用赋值符号 并不会创建新对象,而只是创建了一个指向同一内存地址的新引用。

为了实现真正的克隆,我们需要根据对象的复杂程度选择浅拷贝(Shallow Copy)或深拷贝(Deep Copy)。
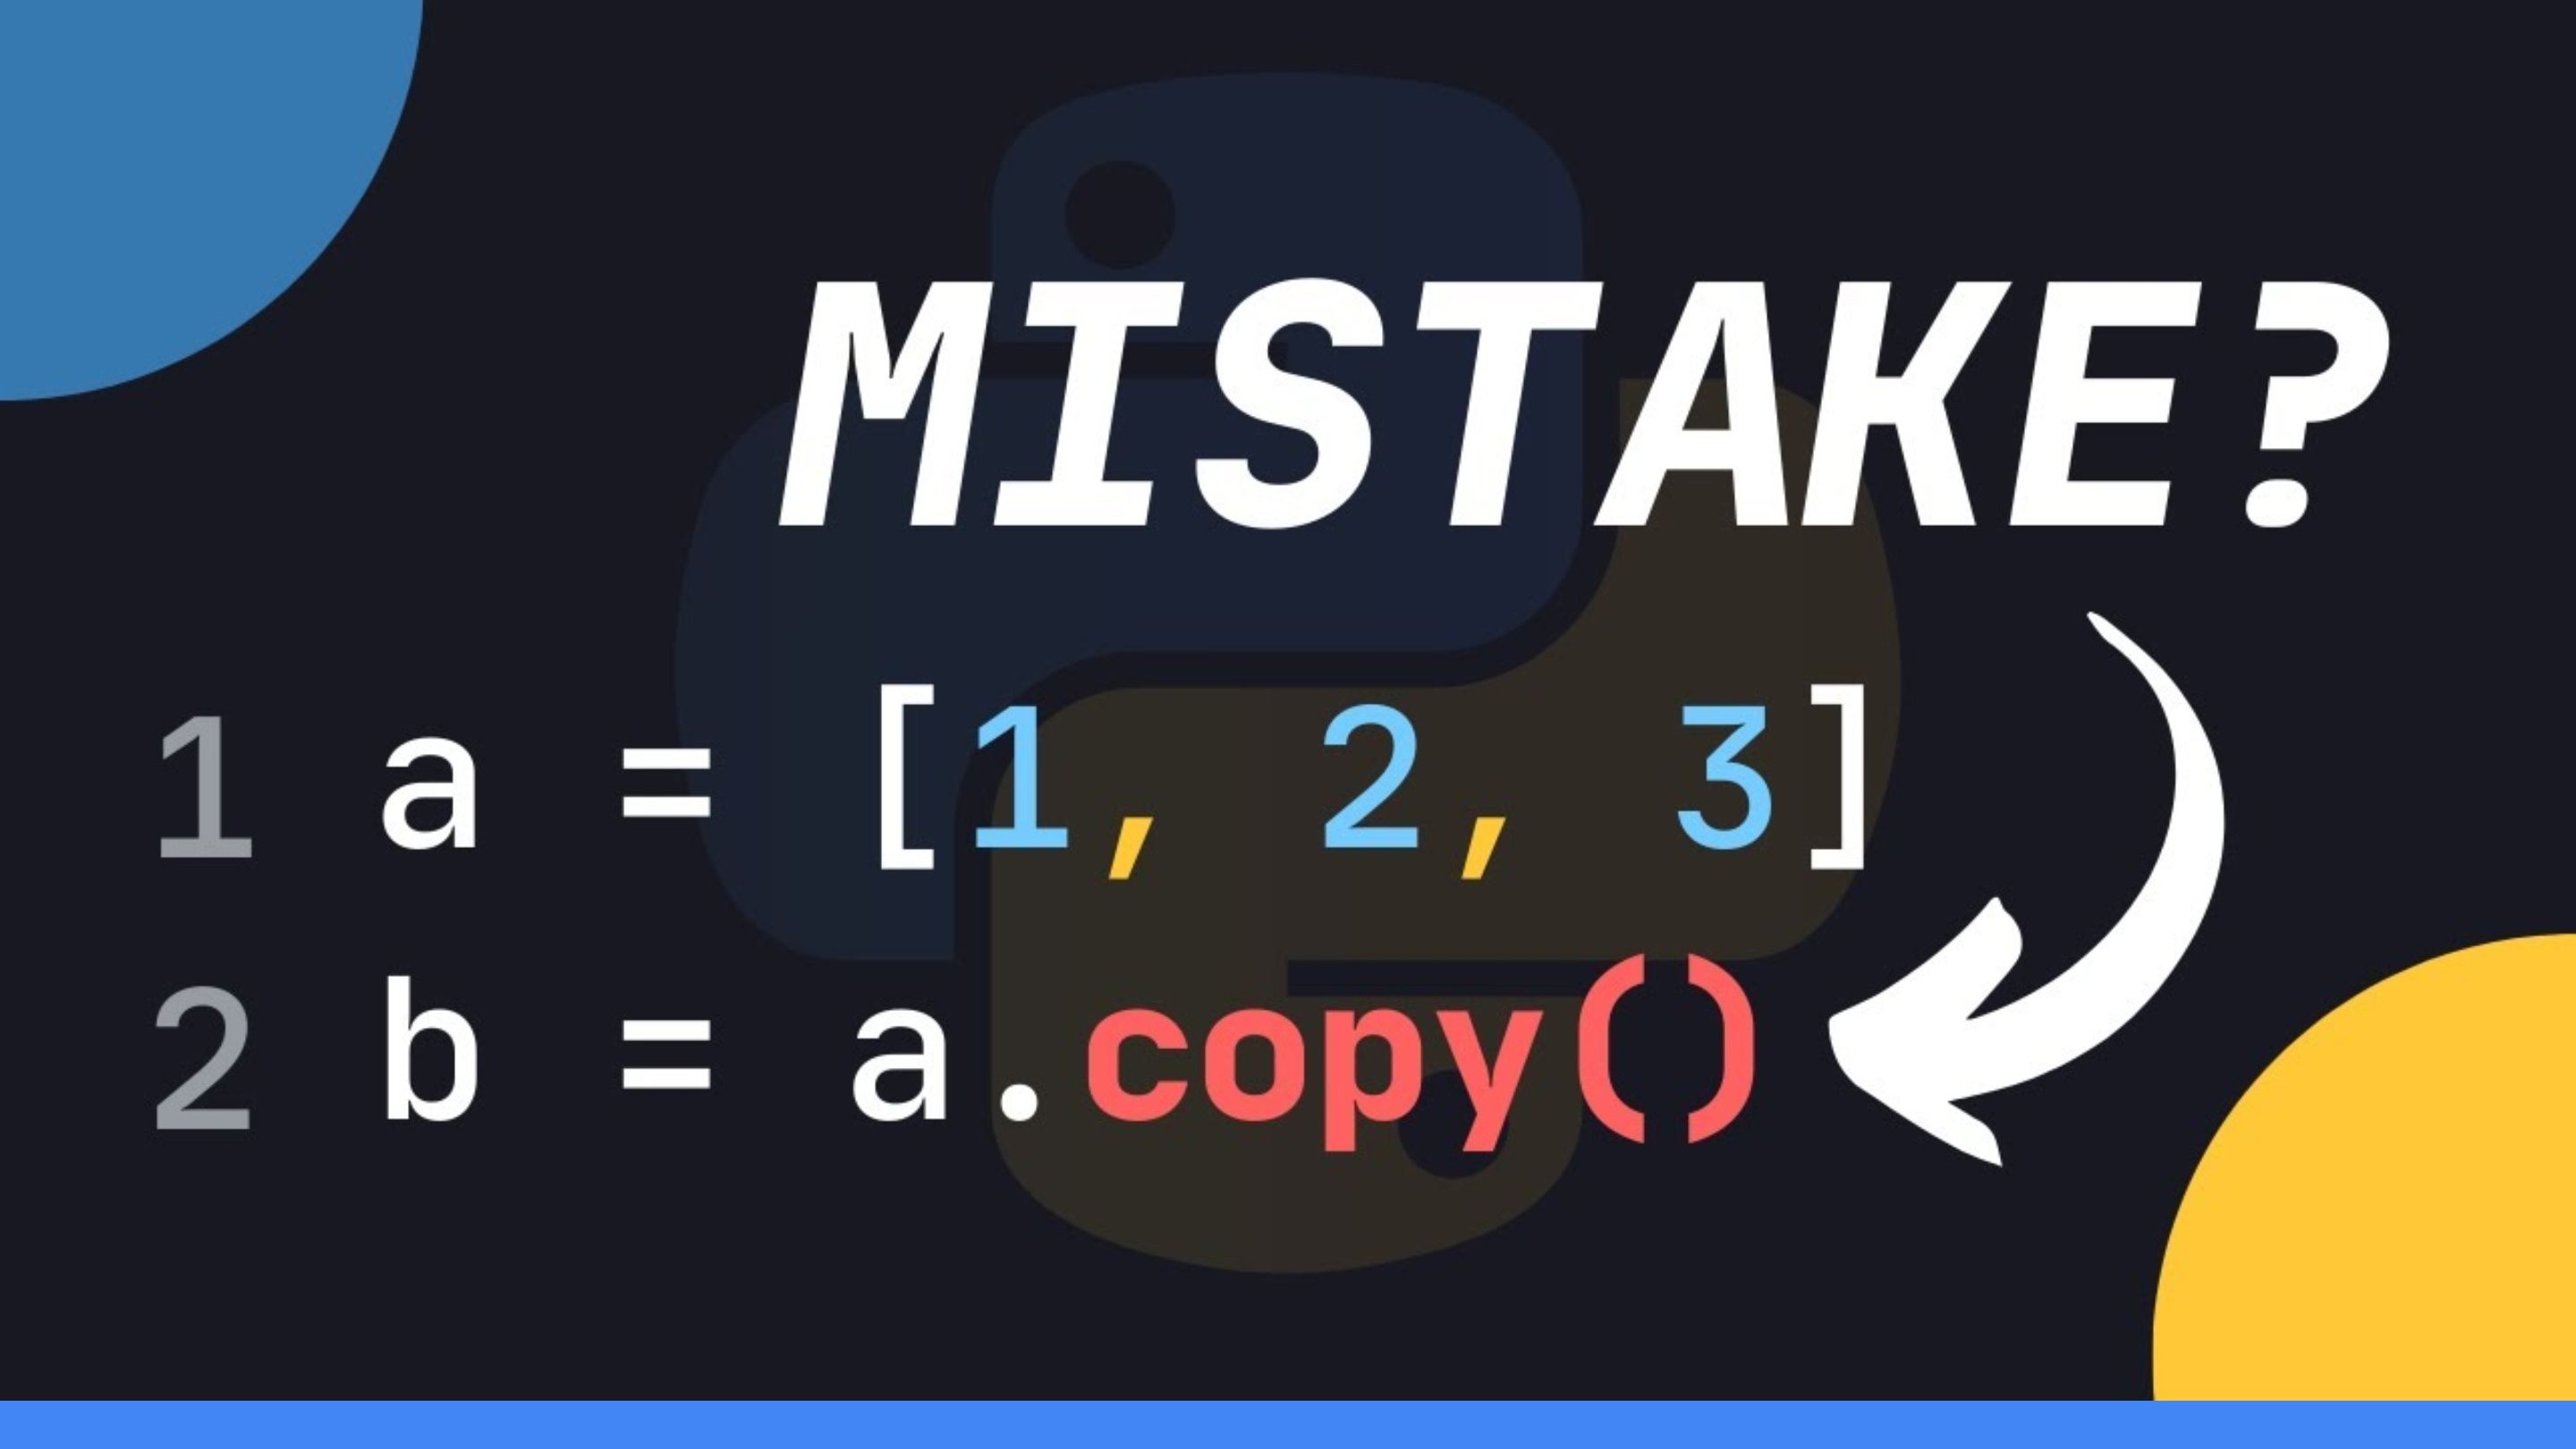
Python 浅拷贝 vs 深拷贝,一行代码分清引用与独立复制
加载中
Python 浅拷贝 vs 深拷贝,一行代码分清引用与独立复制

引用赋值(非克隆)

当你使用 a = b 时,并没有发生克隆,两个变量指向的是同一个对象,修改其中一个,另一个也会随之改变。

  • 特点:不创建新对象,仅增加引用计数。
  • 适用场景:仅需起个别名时。

浅拷贝 (Shallow Copy)

浅拷贝会创建一个新对象,但如果原对象内部包含其他可变对象(如列表中的列表),它只会拷贝这些内部对象的引用。

实现方法

  • 使用 copy 模块:copy.copy()
  • 使用切片(仅限列表):new_list = old_list[:]
  • Python如何实现对象克隆,浅拷贝和深拷贝有什么区别?

    使用工厂函数:new_list = list(old_list) 或 new_dict = dict(old_dict)

  • 使用内置方法:new_list = old_list.copy()

关键特性

  • 第一层独立:修改克隆后的顶层元素不会影响原对象。
  • 嵌套层共享:修改克隆对象内部的嵌套可变对象,原对象会被同步修改。

深拷贝 (Deep Copy)

深拷贝会递归地复制对象及其包含的所有子对象,它会创建一个完全独立的副本,原对象与新对象之间没有任何共享的内存地址。

实现方法

  • 使用 copy 模块:copy.deepcopy()

关键特性

  • 完全独立:无论对象嵌套多少层,修改新对象都不会影响原对象。
  • 性能开销:由于需要递归遍历并复制所有内容,深拷贝比浅拷贝慢且占用更多内存。

核心对比总结

方式 语法

Python如何实现对象克隆,浅拷贝和深拷贝有什么区别?

顶层对象

嵌套对象独立程度
引用赋值b = a共享共享完全不独立
浅拷贝copy.copy(a)创建新对象共享部分独立
深拷贝copy.deepcopy(a)创建新对象创建新对象完全独立

代码示例演示

import copy# 准备一个嵌套列表original = [[1, 2], [3, 4]]# 1. 引用赋值ref_copy = original# 2. 浅拷贝shallow_copy = co

Python如何实现对象克隆,浅拷贝和深拷贝有什么区别?

py.copy(original) # 3. 深拷贝 deep_copy = copy.deepcopy(original) # 修改嵌套元素 original[0][0] = 'X' print(f"原对象: {original}") # [['X', 2], [3, 4]] print(f"引用赋值: {ref_copy}") # [['X', 2], [3, 4]] -> 受影响 print(f"浅拷贝: {shallow_copy}") # [['X', 2], [3, 4]] -> 受影响 (因为嵌套对象是共享的) print(f"深拷贝: {deep_copy}") # [[1, 2], [3, 4]] -> 不受影响 (完全独立) # 修改顶层元素 original.append([5, 6]) print(f"原对象: {original}") # [['X', 2], [3, 4], [5, 6]] print(f"浅拷贝: {shallow_copy}") # [['X', 2], [3, 4]] -> 不受影响 (顶层已独立)
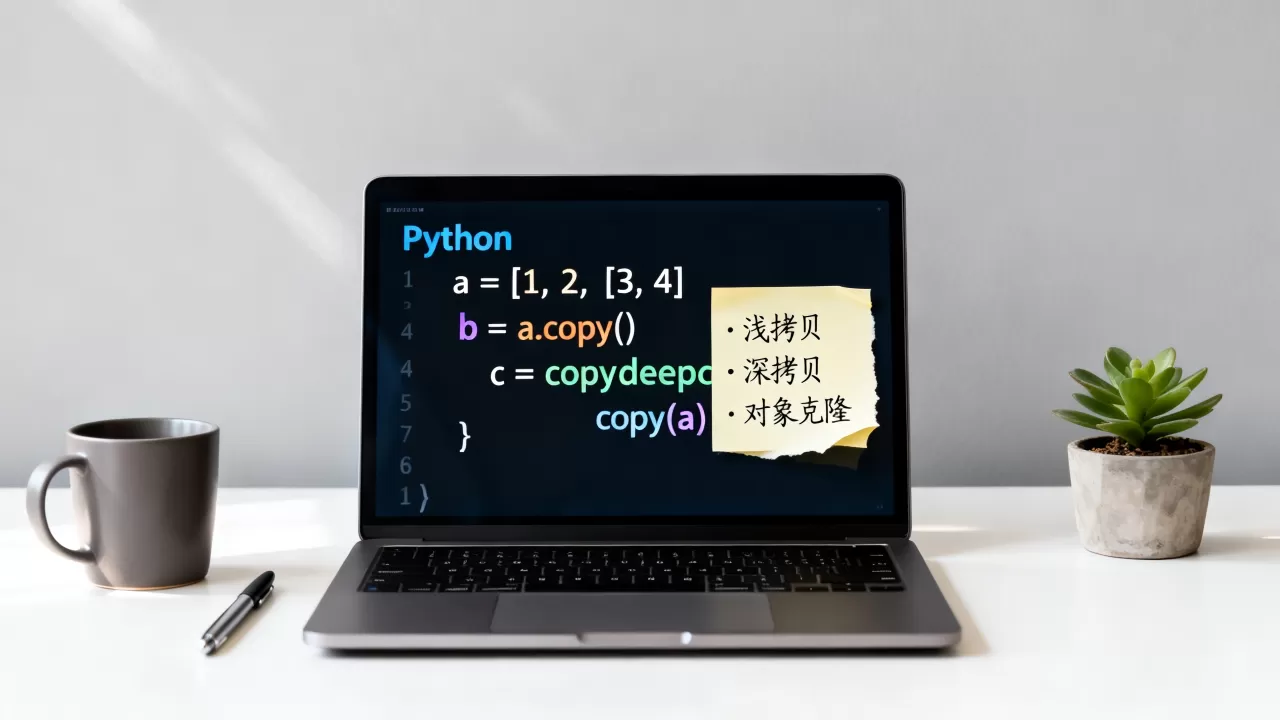
选择指南

  • 如果对象是不可变类型(如数字、字符串、元组),直接赋值即可,因为它们无法被修改。
  • 如果对象是简单的一层可变类型(如简单的列表或字典),使用浅拷贝。
  • 如果对象包含复杂的嵌套结构(如列表嵌套字典,或自定义类的实例),且需要确保修改副本不影响原件,必须使用深拷贝。

首发原创文章,作者:王坚‌,如若转载,请注明出处:https://test.idctop.com/article/493602.html

赞 (0)
点播CDN是什么?如何选择高性价比的视频点播CDN加速服务?
上一篇 2026年7月14日 08:13
什么是百度公共CDN?百度公共CDN有哪些好用的前端资源库?
下一篇 2026年7月14日 08:17

相关推荐

  • 服务器如何开启ping?服务器开启ping命令设置方法

    服务器开启ICMP协议响应(即通常所说的Ping操作)是网络运维中提升连通性排查效率、保障业务可用性的关键举措,核心结论在于:在合理配置防火墙安全策略的前提下,开启Ping功能能够显著降低网络故障排查的时间成本,帮助运维人员快速定位网络丢包、延迟抖动等问题,是实现服务器高可用性监控的基础配置, 虽然部分安全策略……

    2026年3月31日
    8700
  • 东莞服务器租用费用明细如何看懂,多少钱一个月?

    东莞服务器租用费用明细主要看硬件配置、带宽类型、IP数量、机房等级和增值服务,忽略续费政策、超额流量计费和迁移费用容易导致预算超支,东莞服务器租用费用明细怎么拆解看懂费用明细的第一步是理解供应商报价单的构成,多数东莞IDC厂商的报价单会列出以下几个模块,但部分隐性收费不会直接写在显眼位置,硬件配置费用:CPU……

    2026年8月12日
    600
  • 服务器异常怎么处理?服务器异常管理的解决方案

    服务器异常管理的核心在于建立“事前预防、事中快速响应、事后复盘优化”的闭环体系,而非单纯依赖故障后的修复,高效的管理策略能将系统停机时间降至最低,保障业务连续性,这是企业IT运维的生命线,通过标准化的流程、自动化的监控工具以及专业的人才梯队建设,企业能够将被动救火转变为主动防御,从而显著降低运维成本并提升服务质……

    2026年3月24日
    11000
  • 服务器建多个网站吗,一台服务器可以搭建几个网站?

    一台服务器完全可以搭建多个网站,这是目前互联网基础设施中资源利用率最高、成本控制最优的主流方案,通过虚拟主机技术、多端口监听或反向代理等手段,单一IP地址的服务器能够同时承载数十甚至上百个站点,且各站点之间相互独立,互不干扰,对于中小企业及个人开发者而言,这不仅大幅降低了硬件采购与运维成本,更简化了管理流程,是……

    2026年4月7日
    9400
  • 服务器建站框架怎么选?2026建站框架选择指南

    选择正确的建站架构是服务器高效稳定运行的决定性因素,它直接决定了网站的性能上限、安全等级以及后期的运维成本,一个优秀的架构设计能够让服务器资源利用率最大化,确保在高并发场景下依然保持流畅访问,而错误的架构选择则会导致服务器频繁宕机、数据丢失以及高昂的维护代价,对于追求长期发展的网站而言,构建科学合理的服务器建站……

    服务器运维 2026年4月9日
    9100
  • 服务器最大优惠在哪里?服务器怎么买最便宜?

    获取服务器最大优惠的本质并非单纯寻找最低标价,而是通过精准匹配业务需求、把握促销节点以及规避隐形消费,实现性能与成本的最佳平衡,真正的优惠在于总拥有成本(TCO)的降低,而非首月账单的减少,企业或个人在选型时,应将重点放在配置的实用性与服务的长期稳定性上,通过科学的选型策略,在预算范围内获得最高的计算效能与网络……

    2026年2月21日
    15000
  • 个人网站banner怎么设计好看?个人网站banner尺寸规格是多少

    个人网站Banner不仅是视觉门面,更是决定用户停留时长与转化率的“第一触点”,其核心在于通过高对比度色彩、清晰的价值主张文案及响应式布局,在0.5秒内建立信任并引导行动,在数字化竞争日益激烈的2026年,个人品牌或独立站点的流量获取成本居高不下,许多创作者误以为Banner只是装饰性的图片,实则它是网站交互逻……

    2026年5月25日
    4600
  • 服务器控制面板打不开怎么办?原因分析与解决方法

    服务器控制面板无法访问,通常由服务进程崩溃、端口被占用或拦截、防火墙设置不当、磁盘空间爆满这四大核心因素导致,解决问题的关键在于由简入繁,依次排查系统资源、服务状态、网络策略及配置文件,遇到此类故障切勿盲目重启服务器,系统化的诊断流程能最快恢复业务并定位根因, 排查系统基础资源与进程状态当发现控制面板无响应时……

    2026年3月12日
    12900
  • 服务器接收短信失败怎么办?服务器接收短信配置教程

    服务器接收短信的本质是企业级通信架构中的关键数据入口,其核心价值在于实现短信数据的自动化采集、结构化处理与实时响应,从而支撑验证码校验、物流通知、系统告警等高并发业务场景,构建一套高可用、低延迟的短信接收体系,不再仅仅是简单的硬件连接,而是融合了协议解析、并发控制与安全审计的综合技术解决方案,技术架构演进与核心……

    2026年3月4日
    11300
  • Phoenix Python是什么?Phoenix Python教程

    Phoenix Python并非一个独立的编程语言,而是Apache Phoenix项目提供的Java库,它允许开发者使用标准SQL通过JDBC驱动直接查询HBase中的大规模数据,从而将NoSQL的灵活性与SQL的易用性完美结合,在大数据生态系统中,HBase以其高吞吐量和低延迟写入能力著称,但原生API对于……

    2026年7月6日
    2100

发表回复

您的邮箱地址不会被公开。 必填项已用 * 标注