分布式实现分页查询的核心在于通过分片路由将请求分发至各节点,并在聚合层对结果进行全局排序与截断,而针对深分页性能瓶颈,业内普遍采用基于游标(Cursor)的 Seek 模式替代传统的 Offset 偏移量模式。
分布式分页查询与单机分页查询的区别
在单机数据库中,分页查询通过 LIMIT offset, size 即可完成,数据库引擎在索引树上定位到起始位置后顺序读取,但在分布式架构下,数据被分片(Sharding)存储在多个物理节点上,这意味着没有任何一个节点拥有全量数据的全局视图。
数据分布的离散性
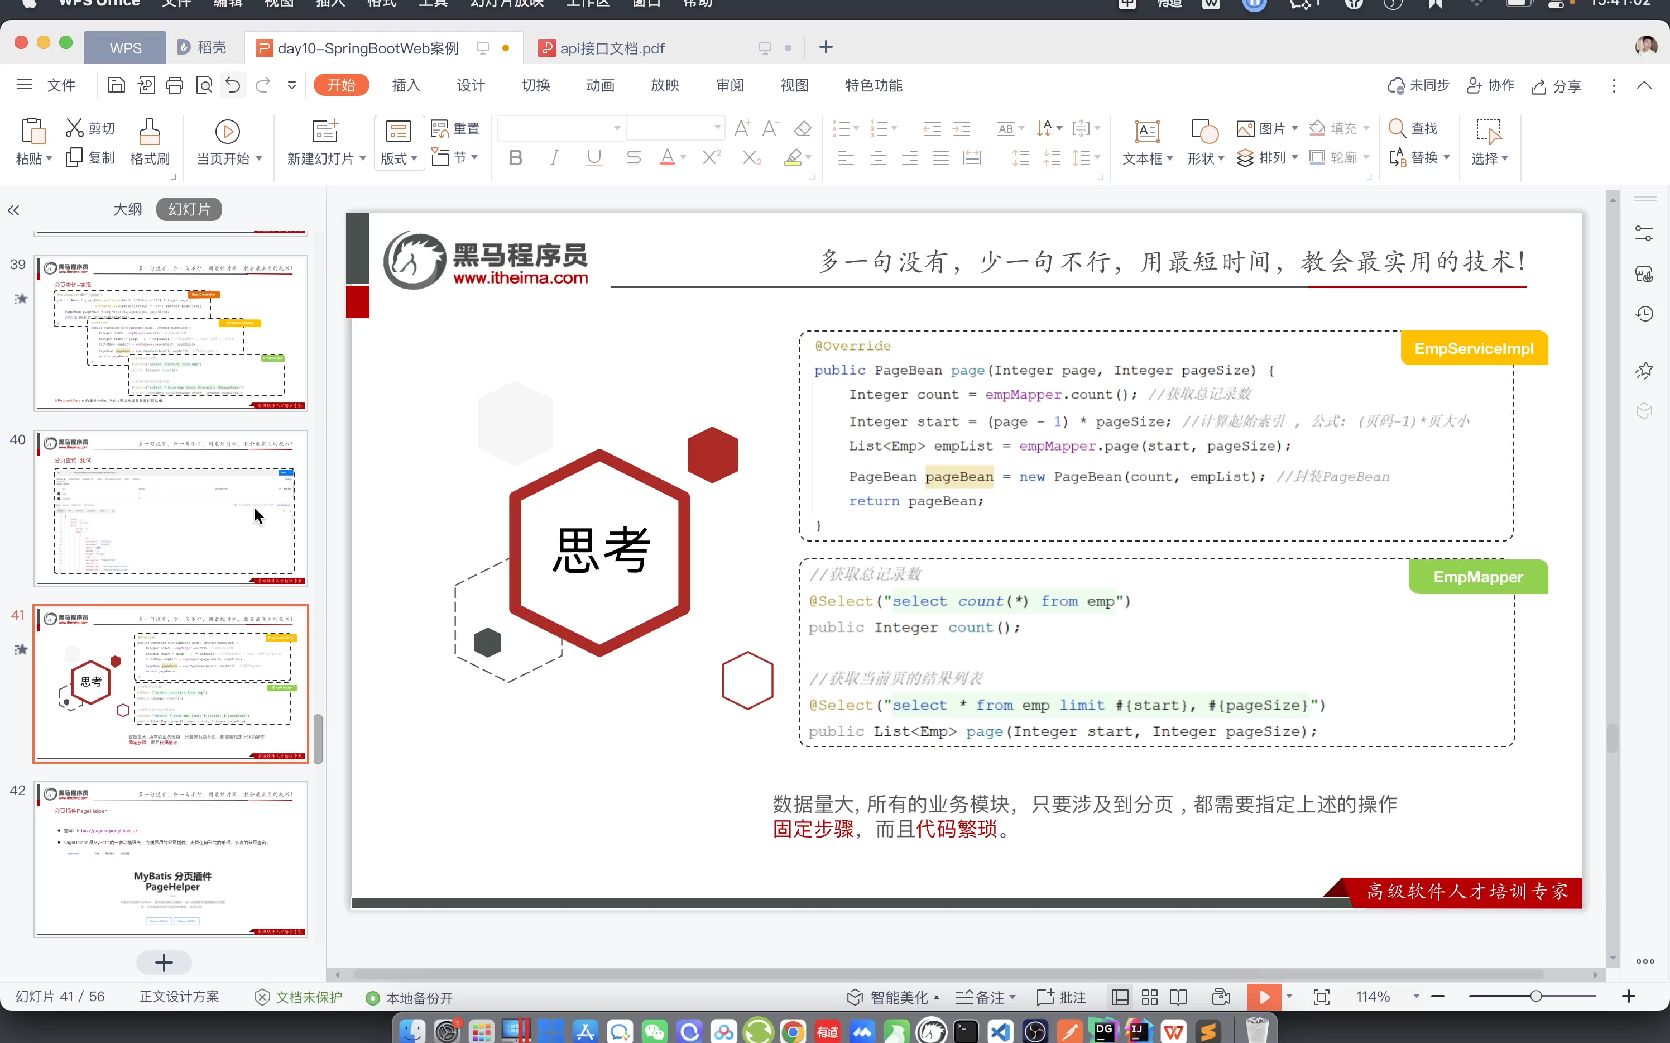
单机分页是局部操作,而分布式分页是全局聚合操作,当用户请求第 100 页数据时,系统不能简单地在某个节点上执行 LIMIT 990, 10,因为每个分片中存储的数据量不同,且排序顺序在全局范围内是不确定的。
聚合节点的压力
分布式分页引入了聚合层(Aggregator/Proxy),聚合层需要将请求发送给所有分片,收集每个分片返回的部分结果,在内存中进行再次排序(Global Sort),最后截取目标页码的数据,这种模式在页码较浅时性能尚可,但随着页码增加,网络传输量和内存开销会呈线性甚至指数级增长。
结果集的一致性挑战
由于分布式系统存在数据迁移、副本同步延迟等问题,在分页翻页过程中,如果底层数据发生增删,容易出现重复数据或漏掉数据的现象,这在单机环境下通过事务隔离级别可以较好解决,但在分布式环境下需要额外的逻辑保证。
大数据量分布式分页查询怎么实现
实现分布式分页的核心逻辑在于如何高效地在多个分片之间同步状态并减少无效数据的传输。
基础的 Scatter-Gather 模式
这是最常见的实现方式,其执行流程如下:
- 请求分发:聚合层将分页请求(如
Page 10, Size 20)发送至所有分片。 - 局部查询:每个分片根据排序规则,查询出前
(10-1)20 + 20 = 200条记录。 - 结果汇总:所有分片将这 200 条记录返回给聚合层。
- 全局排序:聚合层将所有分片返回的数据(最多
200 分片数条)进行全局排序。 - 最终截断:从全局排序后的结果集中截取第 181 到 200 条数据返回给用户。
基于全局索引的路由优化
为了避免全分片扫描,可以引入全局索引表(Global Index),该表记录了排序键(Sort Key)与分片 ID 的映射关系。
- 范围定位:通过全局索引快速确定目标页码的数据落在哪些分片中。
- 精准请求:仅向相关分片发送请求,大幅降低网络 IO。
- 适用场景:适用于排序字段固定且更新频率较低的场景。
游标分页(Cursor-based Pagination)
行业共识认为,对于海量数据的分布式查询,放弃“页码”概念,改用“游标”是最佳实践。
- 实现逻辑:不使用
OFFSET,而是记录上一页最后一条数据的唯一标识(如last_id或last_timestamp)。 - 查询语句:
SELECT FROM table WHERE id > last_id ORDER BY id ASC LIMIT 20。 - 分布式优势:每个分片只需查询大于
last_id的前 20 条数据,聚合层只需简单合并并取前 20 条即可,无需加载大量无效数据。
分布式系统深分页查询慢怎么解决
当用户请求第 10000 页时,传统的 OFFSET 模式会导致聚合层需要处理 10000 size 条数据,产生严重的性能坍塌。
延迟关联(Deferred Join)策略
深分页慢的根源在于数据库需要回表查询大量最终会被丢弃的完整行数据。
- 操作路径:
- 先通过覆盖索引(Covering Index)仅查询主键 ID。
- 在索引树上快速定位到
OFFSET 100000, 10的 10 个 ID。 - 使用
WHERE id IN (...)将这 10 个 ID 回表查询完整行数据。
- 效果:将原本需要回表 100,000 次的操作降低到 10 次,极大减轻 IO 压力。
限制最大翻页深度
很多互联网大厂在产品设计上会限制最大翻页数(例如最多翻到 100 页)。
- 逻辑依据:用户极少会翻阅到 100 页之后的数据,深分页请求往往是爬虫行为或异常查询。
- 替代方案:对于需要全量数据的场景,引导用户使用
导出功能
(通过流式读取导出 CSV),而非通过 UI 界面分页。
预计算与缓存快照
针对高频访问的热点分页数据,可以采用快照机制。
- 实现方式:在数据写入时,异步计算数据的全局顺序并存储在 Redis 的
ZSet中。 - 查询路径:直接从 Redis 中通过
ZRANGE获取对应页码的 ID 列表,再到数据库中点对点查询。 - 权衡:这种方案牺牲了实时性,但在极高性能要求下非常有效。
分布式数据库分页查询性能优化方案
为了在实际生产环境中落地,需要根据业务场景选择不同的优化组合,下表对比了三种主流方案的性能与适用性:
| 方案 | 时间复杂度 | 网络开销 | 实时性 | 适用场景 | 翻页体验 |
|---|---|---|---|---|---|
| Offset 模式 | $O(N cdot text{shards})$ | 极高 | 强 | 小数据量、浅分页 | 支持随机跳转 |
| Seek/Cursor 模式 | $O(text{size} cdot text{shards})$ | 低 | 强 | 海量数据、流式滚动 | 仅支持下一页 |
| 全局索引/缓存 | $O(1)$ 或 $O(log N)$ | 极低 | 中 | 高频热点数据 | 支持随机跳转 |
具体的实操步骤与命令示例
假设一个订单系统,数据分布在 4 个分片中,需要实现一个高性能的分布式分页接口。
步骤 1:定义查询接口
不要接收 pageIndex,改为接收 lastSeenId。GET /api/orders?lastId=12345&size=20
步骤 2:分片并行请求
聚合层使用线程池并行调用 4 个分片,SQL 如下:SELECT FROM orders WHERE id > 12345 ORDER BY id ASC LIMIT 20;
步骤 3:内存合并与截断
使用优先级队列(PriorityQueue)对 4 个分片返回的共 80 条数据进行小顶堆排序,取出前 20 条。
步骤 4:返回结果与新游标
返回 20 条数据,并将第 20 条数据的 ID 作为 nextCursor 返回给前端。
分布式实现分页查询不能简单套用单机逻辑,必须在减少数据传输量和降低回表开销上下功夫,对于绝大多数高并发场景,基于游标的 Seek 模式是解决深分页性能问题的工业级标准。
分布式实现分页查询相关 Q&A
分布式分页查询如何处理排序字段非唯一的情况?
如果排序字段(如 create_time)存在重复值,仅使用 WHERE time > last_time 会导致部分数据被跳过,业内专家指出,此时必须引入一个唯一辅助排序键(通常是主键 ID),查询条件应改为 WHERE (create_time > last_time) OR (create_time = last_time AND id > last_id),确保每一条记录在全局范围内都有唯一的确定位置。
在分布式环境下,如何实现精准的 Total Count 统计?
在分布式系统中,SELECT COUNT() 是极其昂贵的,因为需要扫描所有分片,行业共识认为,应根据业务需求采取不同策略:
- 近似值:利用 HyperLogLog 等算法提供一个大概的估算值。
- 异步计数:使用专门的计数表,在数据增删时异步更新总数。
- 限制统计:仅在第一页请求时统计一次,后续翻页不再请求总数,或直接将总数缓存 5-10 分钟。
分布式分页查询中,如果某个分片响应缓慢(慢节点)怎么办?
这种情况被称为“长尾效应”,可以通过超时截断或冗余请求解决,设置一个严格的查询超时时间(如 200ms),如果某个分片未返回,聚合层可以选择在结果中标记“部分数据未加载”或直接忽略该分片结果并记录告警,对于极高可用场景,可以向该分片的多个副本同时发送请求,谁先返回就用谁的数据。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/492478.html