MapReduce执行过程是怎样的,MapReduce工作原理是什么?

MapReduce 执行过程深度解析

MapReduce 是一种用于大规模数据集并行处理的编程模型,其核心思想是将一个复杂的计算任务拆分为多个小的子任务,并在分布式集群中并行执行,MapReduce 的执行过程可以分为 Input(输入)、Map(映射)、Shuffle(洗牌)、Reduce(规约) 和 Output(输出) 五个主要阶段。

流程概览

MapReduce 的整体工作流如下:

MapReduce工作流程
加载中
MapReduce工作流程
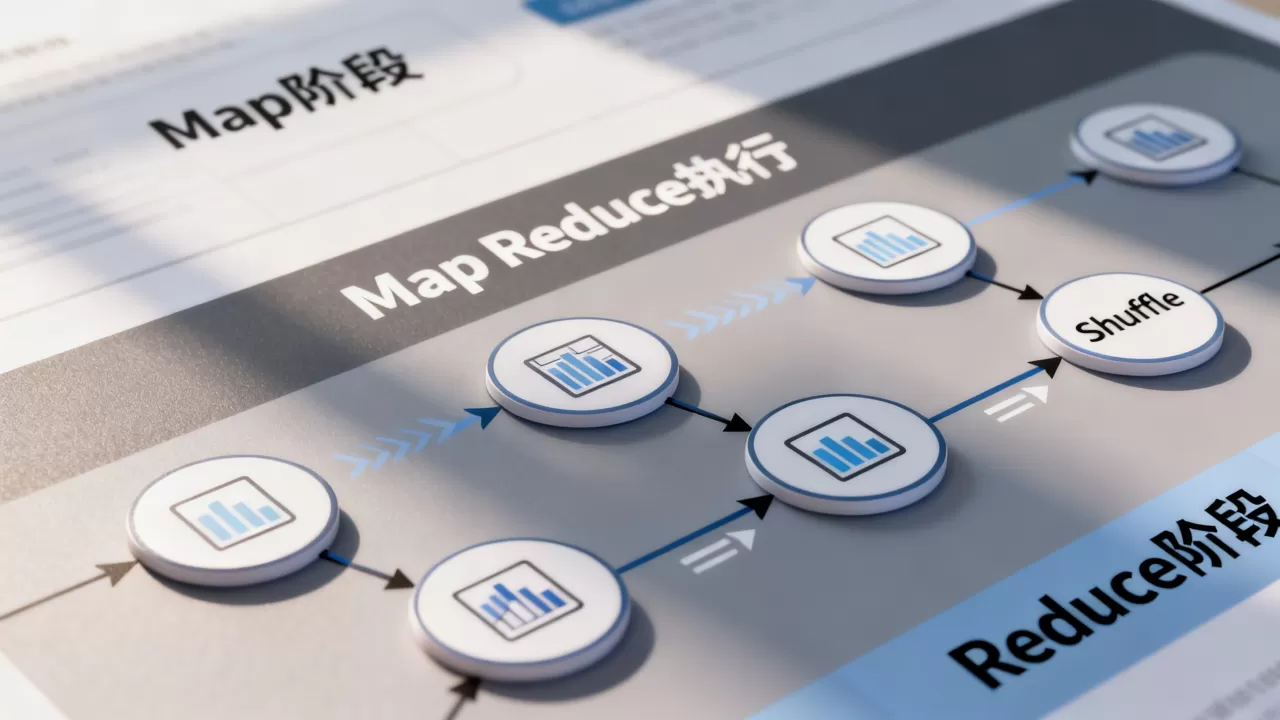
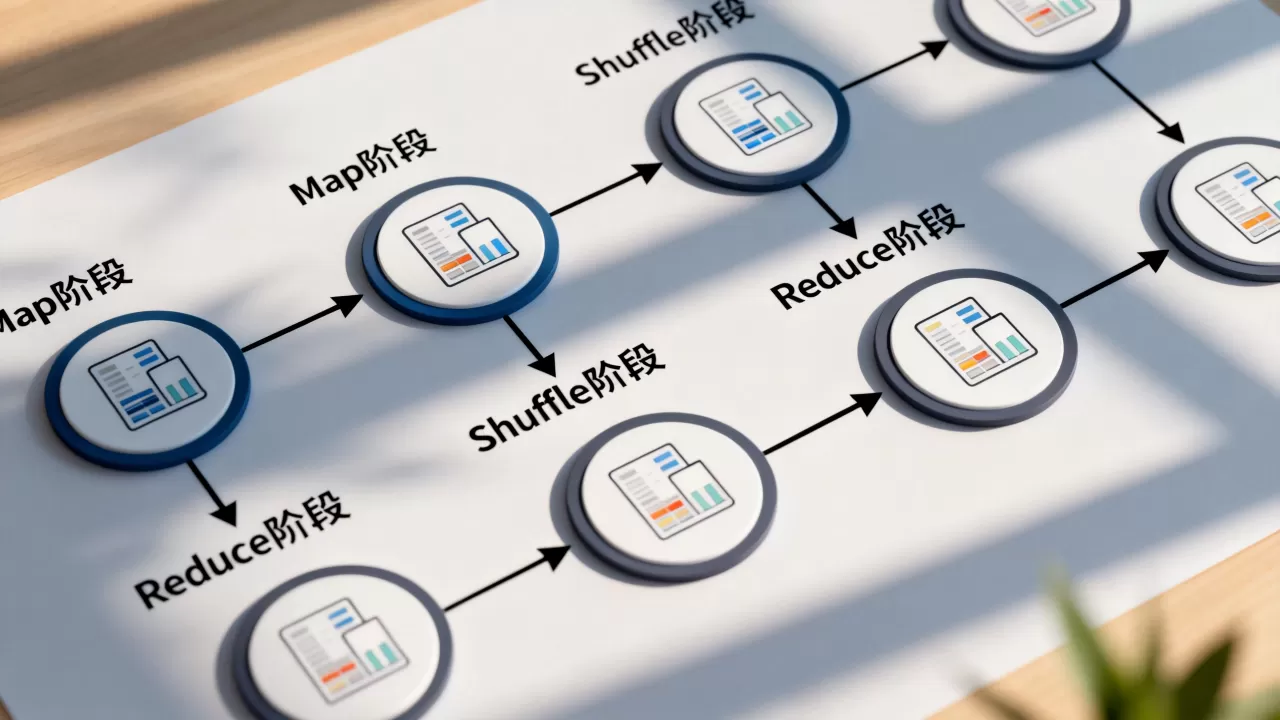
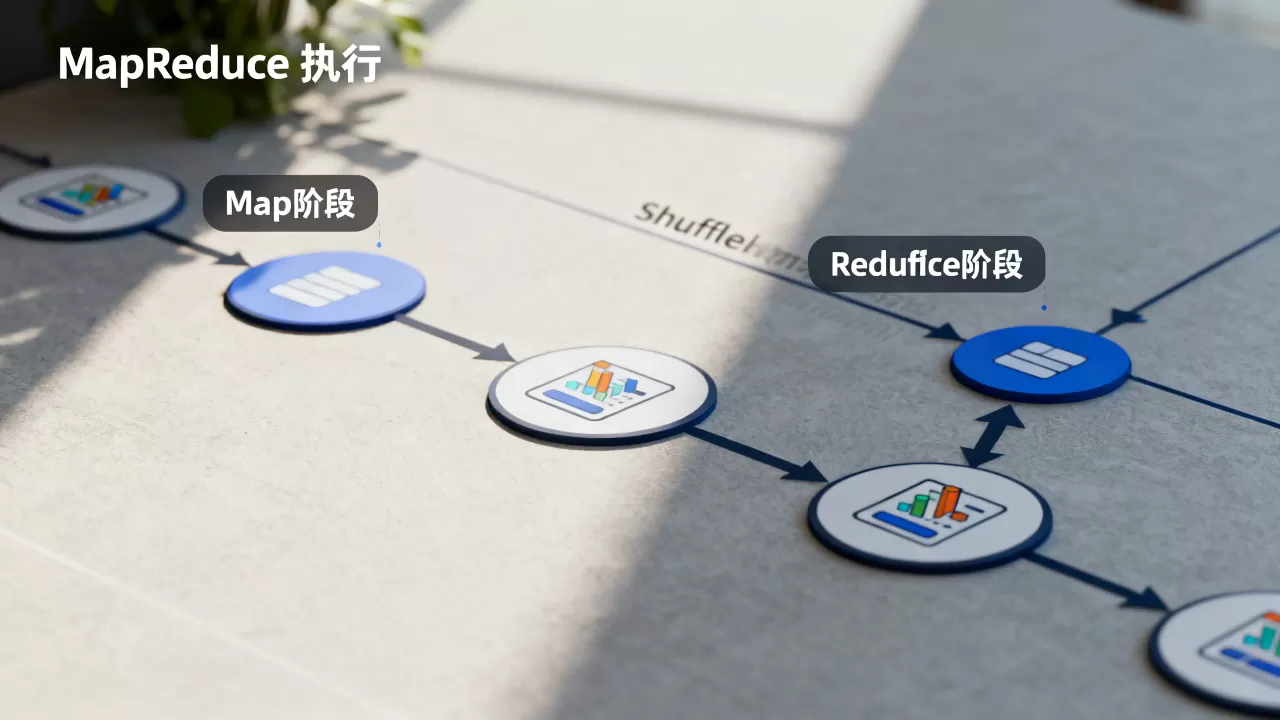
  • 输入数据 $rightarrow$ 切分 (Splitting) $rightarrow$ Map 阶段 $rightarrow$ Shuffle 阶段 $rightarrow$ Reduce 阶段 $rightarrow$ 最终输出。

详细执行步骤

1 数据切分阶段 (Input Splitting)

在任务开始前,框架会根据 InputFormat 将输入数据(通常存储在 HDFS 中)逻辑上划分为多个 InputSplit。

  • InputSplit 是逻辑上的分片,每个分片对应一个 Map Task。
  • 切分的大小通常由 HDFS 的 Block 大小决定,确保每个 Map 任务处理的数据量相对均衡。
  • MapReduce执行过程是怎样的,MapReduce工作原理是什么?

2 Map 阶段 (Mapping)

每个 Map Task 读取一个 InputSplit 中的数据,通过 RecordReader 将数据转换为一个个 <Key, Value> 形式的键值对。

  • Mapper 函数 对这些键值对进行处理。
  • 处理结果会产生一系列 中间键值对 (Intermediate Key-Value pairs)。
  • 这些中间结果暂时存储在 Map 节点的本地磁盘上,而不是 HDFS。

3 Shuffle 阶段 (核心环节)

Shuffle 是 MapReduce 中最复杂、也是最关键的阶段,它的任务是将 Map 阶段产生的中间结果进行分区、排序和分发,确保具有相同 Key 的数据都被发送到同一个 Reduce Task 中。

Shuffle 过程包含以下子步骤:

  • Partitioning (分区):通过分区函数(如 HashPartitioner)决定当前的 Key 应该交给哪一个 Reduce 任务处理。
  • Sorting (排序):在 Map 端,对输出的中间数据按 Key 进行排序。
  • MapReduce执行过程是怎样的,MapReduce工作原理是什么?

  • Spilling (溢写):当 Map 端的内存缓冲区(Buffer)达到一定阈值时,会将数据写入本地磁盘。
  • Merging (合并):将多个小的溢写文件合并成一个大的有序文件。
  • Copying (拷贝/拉取):Reduce 节点通过 HTTP 请求,从各个 Map 节点将属于自己的数据分区“拉取”到本地。
4 Reduce 阶段 (Reducing)

当 Reduce 节点收集齐了所有相关的中间数据后,会进行最后的合并与规约:

  • Grouping (分组):将具有相同 Key 的所有 Value 聚合在一起,形成 <Key, List> 的形式。
  • Reducer 函数 对这些聚合后的数据进行计算(如求和、计数、平均值等)。
  • 计算结果产生最终的 <Key, Value> 结果。

5 输出阶段 (Output)

由 OutputFormat 将 Reduce 阶段计算出的结果写入到指定的存储系统中(通常是 HDFS)。


核心环节:Shuffle 详解

之所以强调 Shuffle 的重要性,是因为它是连接 Map 和 Reduce 的桥梁,也是整个分布式计算中
MapReduce执行过程是怎样的,MapReduce工作原理是什么?

性能瓶颈最常出现的地方。

  • 数据流向:Map 端(内存 $rightarrow$ 磁盘) $rightarrow$ 网络传输 $rightarrow$ Reduce 端(磁盘 $rightarrow$ 内存)。
  • 优化重点:
    • 减少磁盘 I/O 次数(通过增大 Buffer 大小)。
    • 减少网络传输压力(通过使用 Combiner 进行本地预聚合)。
    • 优化分区策略(避免出现 数据倾斜,即某个 Reducer 处理的数据量远大于其他 Reducer)。

  • Map 阶段:负责数据的并行化读取与初步转换,输出中间结果。
  • Shuffle 阶段:负责数据的重组、排序与分发,是实现“按 Key 分组”的核心。
  • Reduce 阶段:负责对分组后的数据进行聚合计算,生成最终结果。

通过这种分而治之的策略,MapReduce 能够实现海量数据的自动化并行处理,极大地提升了数据处理的效率。

首发原创文章,作者:王坚‌,如若转载,请注明出处:https://test.idctop.com/article/491366.html

赞 (0)
CDN UI界面如何配置?CDN控制台怎么设置才能有效加速网站加载速度?
上一篇 2026年7月13日 13:41
为什么FTP服务器连接会被重置,FTP连接被重置怎么解决?
下一篇 2026年7月13日 13:44

相关推荐

  • 为何服务器端和客户端信息一致?服务器与客户端数据同步失败怎么解决

    服务器端和客户端信息一致是保障数据准确性、提升用户体验及确保系统安全的核心基础,任何偏差都可能导致业务逻辑错误或安全漏洞,在数字化时代,数据流转如同血液在人体中循环,服务器端与客户端作为两大核心器官,必须保持高度的协同与一致,这种一致性不仅仅是技术层面的同步,更是业务逻辑与用户感知之间的桥梁,当两者信息吻合时……

    2026年7月5日
    6510
  • 服务器数据整理为何重要?服务器数据整理有哪些具体意义

    服务器数据整理不仅仅是简单的“文件归类”或“清理垃圾”,它是企业IT基础设施管理、数据安全以及业务决策的基石,随着数据量的爆炸式增长,对服务器数据进行系统化、规范化的整理具有深远的战略意义和实际价值,以下是服务器数据整理的核心意义,分为五个关键维度进行阐述:提升系统性能与资源利用率优化存储空间:通过识别和清理无……

    2026年7月10日
    2300
  • it运维管理市场分析_运维管理

    最近几年,运维圈子里聊得最多的不再是“服务器又挂了怎么办”,而是“怎么让系统自己别挂”,IT运维管理正从被动救火,转向以数据驱动的主动治理与自动化运维,2026年的市场分水岭不在工具数量,而在谁能把AI用进日常巡检和故障预测里,IT运维管理市场分析:增长动力来自哪里数字化转型倒逼运维边界扩张以前IT运维管的是机……

    2026年8月17日
    200
  • iis网站登录没反应怎么办,网站域名修改后不生效?

    IIS网站登录没反应,多数情况不是程序出了问题,而是域名绑定、应用池状态或HTTP重定向配置这三处“隐性设置”在作怪,改完域名后登录失效,也基本都指向同一批原因,下面按排查优先级,把思路和操作步骤拆开讲清楚,IIS网站登录没反应怎么解决:先分清是“打不开”还是“登录不了”很多站长把“登录没反应”和“网站打不开……

    2026年8月14日
    800
  • iis75部署网站为何打不开,部署应用无法访问怎么办

    IIS 7.5部署网站后无法访问,绝大多数情况是由于绑定信息、应用程序池状态或文件权限配置不当,按照顺序排查即可快速解决,iis7.5网站无法访问怎么解决?从绑定和端口开始很多人在IIS7.5上部署好网站,浏览器一敲地址却提示“找不到页面”或“连接失败”,别慌,问题通常出在最基础的绑定配置上,绑定配置:最常见的……

    2026年8月7日
    800
  • 如何选择最合适的分布式事务方案,分布式事务怎么实现?

    分布式事务的核心目标是在分布式环境下保证数据的一致性,通过2PC、TCC、Saga等不同强度的协议在一致性与可用性之间寻找平衡点,微服务架构下分布式事务如何实现在微服务架构中,原本属于单一数据库的业务逻辑被拆分到了多个独立的数据库实例中,当一个业务流程跨越多个服务时,传统的本地事务机制失效,必须引入分布式事务协……

    2026年7月14日
    1000
  • AI大模型真实存在吗?如何辨别AI生成内容

    AI大模型的真实面貌并非科幻电影中的超级智能,而是基于海量数据训练的概率预测工具,其核心价值在于通过人机协作大幅提升内容创作与逻辑处理效率,而非完全替代人类决策,很多人对AI大模型存在误解,认为它拥有独立意识或能像人一样“思考”,当你输入一段提示词时,模型是在计算下一个字出现的概率,这种技术机制决定了它既有强大……

    2026年6月16日
    1800
  • AI大模型如何助力科技创新?最新AI大模型应用案例有哪些

    2026年AI大模型已从“尝鲜体验”全面转向“深度嵌入业务流”,核心竞争力的关键不再仅仅是参数规模,而是垂直场景的落地能力、数据隐私的安全性以及人机协作的流畅度,AI大模型在2026年的核心变革与行业共识从通用对话到垂直领域专家回顾过去几年,AI大模型经历了从“什么都能聊”到“什么都能干”的剧烈转变,在2026……

    2026年6月14日
    11110
  • 服务器客户端怎么连接?服务器客户端连接方式有哪些

    服务器与客户端的连接本质上是基于TCP/IP协议的握手过程,核心在于IP地址、端口号及协议类型的正确配置,通常分为直连、代理连接及WebSocket长连接三种主流模式,在数字化基础设施日益复杂的今天,无论是开发分布式应用还是搭建私有云环境,理解服务器与客户端如何建立稳定连接是基础中的基础,很多初学者容易混淆“连……

    2026年7月11日
    3410
  • 服务器磁盘空间怎么启动才正确,云服务器磁盘扩容怎么操作?

    服务器磁盘空间管理指南在服务器运维中,“启动”或“增加”磁盘空间通常分为三种场景:清理现有空间、挂载新磁盘以及扩容已有分区,以下是针对这三种场景的详细操作指南, 快速释放现有磁盘空间当服务器提示磁盘空间不足(Disk Full)导致服务无法启动时,首先应尝试清理冗余文件,查找大文件:使用 du 命令定位占用空间……

    2026年7月13日
    700

发表回复

您的邮箱地址不会被公开。 必填项已用 * 标注