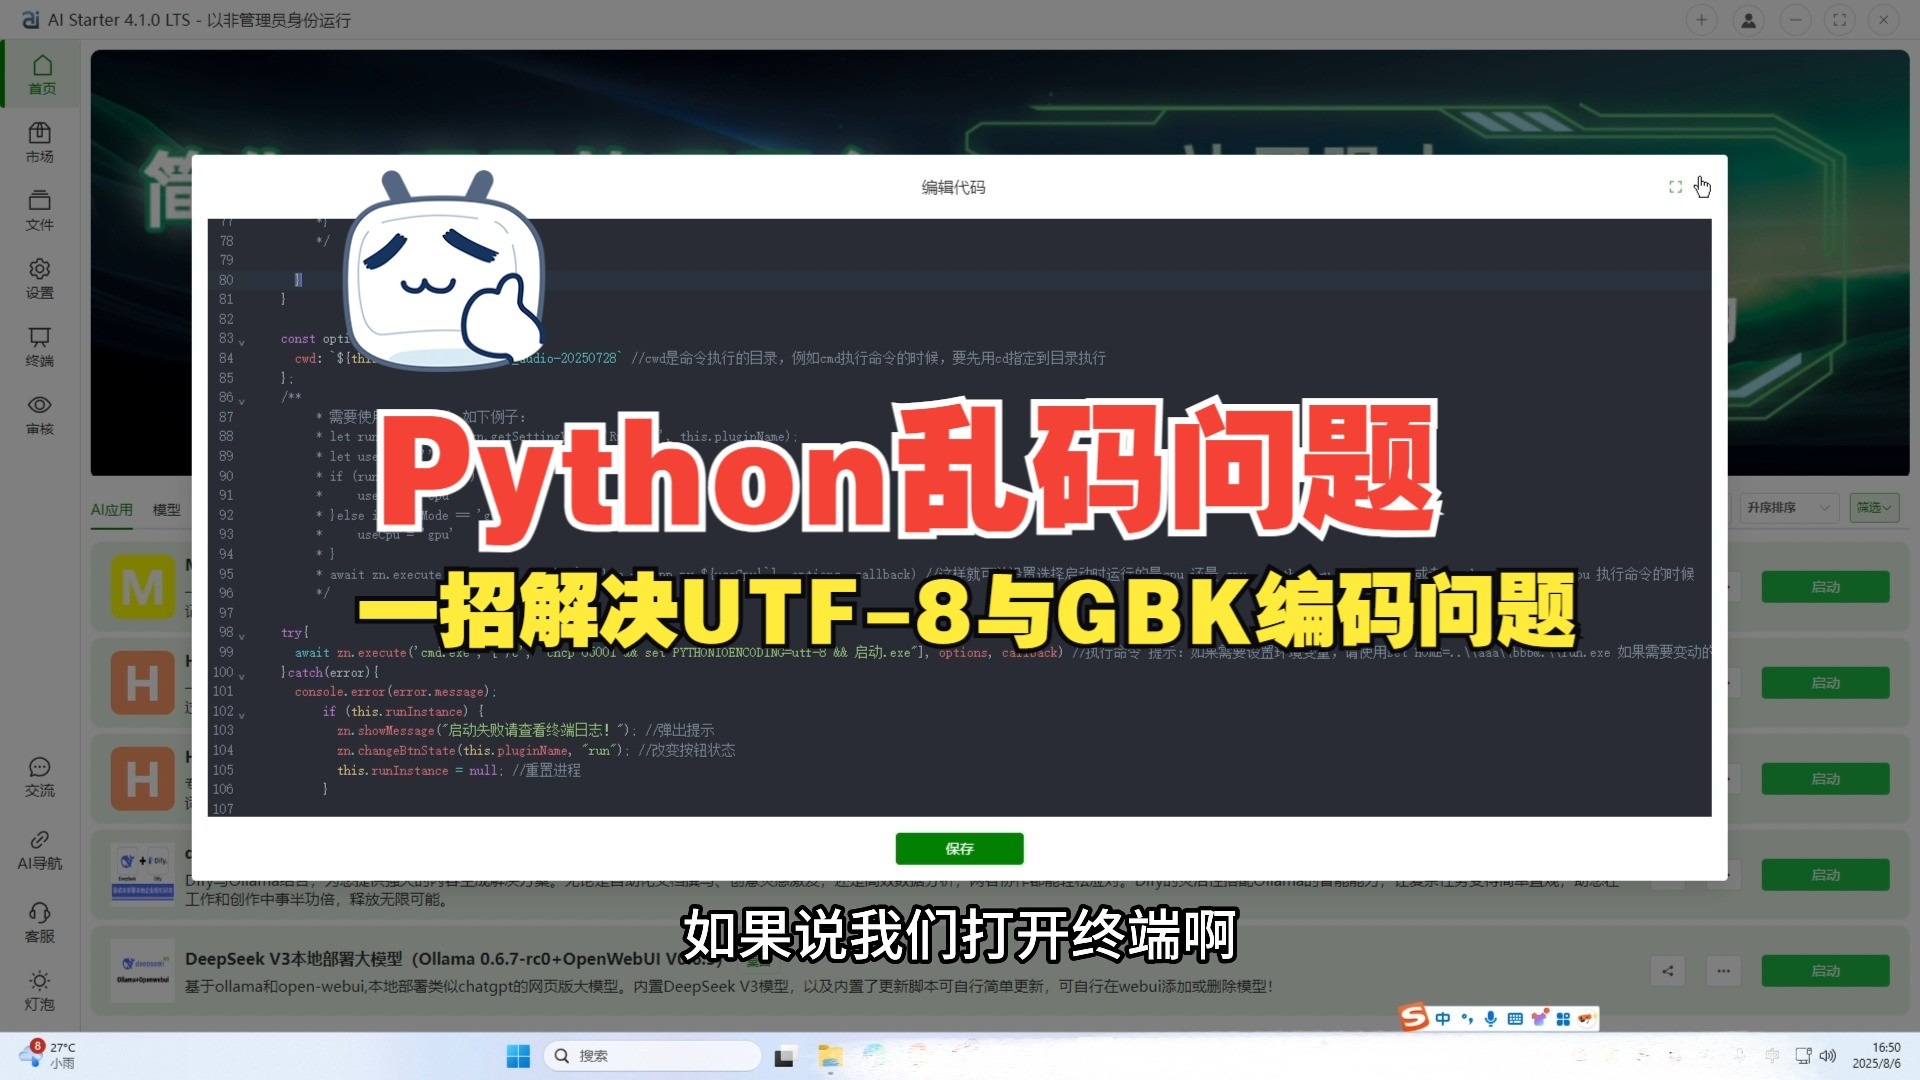
Python编码的核心在于统一使用UTF-8格式,这是解决绝大多数乱码问题的根本途径,开发者应在代码文件头部声明编码,并在读写文件或处理网络数据时显式指定编码格式。
在软件开发领域,编码问题往往被戏称为程序员的“噩梦”,当程序输出一串乱码,或者在读取外部数据时报错,通常意味着编码处理环节出现了偏差,对于Python开发者而言,理解字符集、字节流与字符串之间的转换逻辑,是构建健壮系统的基石。
Python3默认编码与Python2的区别
理解Python编码的演进,是掌握现代Python开发的关键,在Python 2时代,字符串默认是字节序列(bytes),这导致在处理多语言文本时,开发者经常需要在str和unicode之间频繁转换,稍有不慎就会触发编码异常。
行业共识认为,Python 3的出现彻底重构了这一逻辑,Python 3将字符串默认定义为Unicode对象,这意味着代码中的每一个字符在内存中都以Unicode编码存储,从而实现了对全球语言的无缝支持。
以下是Python 2与Python 3在编码处理上的核心差异对比:
| 特性 | Python 2 | Python 3 |
|---|---|---|
| 默认字符串类型 | ASCII (bytes) | Unicode (str) |
| 字节与字符串 | 混淆,需显式转换 | 严格区分,bytes与str互斥 |
| 编码声明 | 需在文件头写 # –– coding: utf-8 –– | 默认UTF-8,无需显式声明 |
| 异常处理 | 隐式转换常导致乱码 | 强制显式转换,报错更及时 |
在现代开发环境中,几乎所有主流框架和库都已停止对Python 2的支持,如果你的项目仍处于迁移阶段,切记核心原则:在Python 3中,永远不要尝试将bytes直接与str拼接,必须先进行解码(decode)或编码(encode)。
Python编码错误怎么解决
当程序抛出 UnicodeDecodeError 或 UnicodeEncodeError 时,很多新手会感到困惑,这类错误本质上是“试图用错误的解码方式去解析字节流”,或者“试图将无法表示的字符编码为特定格式”。
解决Python编码错误,可以遵循以下排查路径:
- 确认源数据编码:不要盲目猜测,如果数据来自网络或文件,首先检查其原始来源的编码格式,很多旧版Windows系统生成的CSV文件默认使用GBK编码,若直接用UTF-8读取必会报错。
- 使用错误处理策略:在无法确定编码的情况下,可以使用
errors参数。errors='ignore':直接忽略无法解码的字节,这会导致部分数据丢失,但在非关键数据处理中有效。errors='replace':用占位符(如问号)替换无法解码的字符,便于后续定位问题。
- 检查环境默认编码:虽然Python 3默认UTF-8,但部分操作系统(尤其是Windows)的系统区域设置会影响
open()函数的默认行为,为了代码的可移植性,永远在open()函数中显式指定encoding参数。
Python读取文件编码设置
在处理文件I/O时,显式设置编码是专业开发者的基本素养,不要依赖系统的默认设置,因为这会导致代码在不同操作系统(如Windows与Linux)之间迁移时出现行为不一致。
正确的做法是始终在 open 函数中加入 encoding 参数,以下是标准操作示例:
# 推荐写法:明确指定编码
with open('data.txt', 'r', encoding='utf-8') as f:
    content = f.read()
# 处理旧系统文件时的写法
with open('legacy_data.csv', 'r', encoding='gbk') as f:
    content = f.read()
如果面对未知编码的文件,可以使用 chardet 库进行探测,在业内专家看来,这是一种折中方案,虽然不能保证100%准确,但对于处理海量异构数据源非常有效。
import chardet
# 探测文件编码
with open('unknown_file.txt', 'rb') as f:
    raw_data = f.read()
    result = chardet.detect(raw_data)
    encoding = result['encoding']
    print(f"检测到的编码为: {encoding}")
Python字符串编码转换
字符串与字节流的转换是Python编码处理的核心,理解 encode() 和 decode() 的方向性是避免逻辑错误的关键。
- encode():将字符串(str)转换为字节流(bytes),这是将数据写入文件、发送到网络或存储到数据库之前的必要步骤。
- decode():将字节流(bytes)转换为字符串(str),这是从文件读取、接收网络请求数据后的必要步骤。
在转换过程中,最常见的误区是混淆了编码格式,UTF-8是目前互联网传输的通用标准,但在处理特定领域数据(如金融、医疗旧系统)时,可能会遇到GBK、ISO-8859-1等编码。
在处理复杂的网络爬虫或API交互时,建议遵循以下流程:
- 接收到原始响应(bytes)。
- 根据响应头中的
Content-Type或charset确定编码。 - 使用对应的编码进行
decode(),将其转换为内存中的Unicode字符串。 - 在程序内部进行逻辑处理。
- 若需输出或存储,再使用
encode('utf-8')转换为字节流。
企业级开发中的编码规范
在大型项目开发中,编码问题往往是导致线上故障的隐蔽元凶,为了规避风险,行业共识建议建立统一的编码规范:
- 全链路UTF-8:从数据库存储、API接口传输、文件读写到前端展示,全链路强制使用UTF-8编码,这是降低系统复杂度的最有效手段。
- 显式声明:在所有涉及I/O操作的代码中,禁止使用系统默认编码,代码必须显式包含
encoding='utf-8'。 - 防御性编程:在处理外部输入数据时,始终假设输入数据可能存在编码异常,并添加相应的异常捕获逻辑,不要让一个编码错误导致整个服务崩溃。
- 数据库配置:确保数据库连接字符串中指定了字符集,在连接MySQL时,应确保连接参数中包含
charset=utf8mb4,以支持包括Emoji在内的全量Unicode字符。
通过上述规范,可以将编码问题在开发阶段拦截,避免其演变为生产环境的故障。
常见问题解答
Python编码错误怎么解决?
定位错误类型是 UnicodeDecodeError(解码失败)还是 UnicodeEncodeError(编码失败),如果是解码失败,检查读取文件时是否指定了正确的编码(如GBK或UTF-8),或尝试使用 errors='replace' 参数,如果是编码失败,通常是因为字符串中包含了目标编码无法表示的字符,建议统一升级为UTF-8编码。
Python读取文件编码设置为什么很重要?
因为不同操作系统和编辑器对文件的默认编码处理方式不同,在Windows上创建的文件可能使用GBK,而在Linux上可能默认为UTF-8,如果不显式设置 encoding 参数,代码在不同环境下运行时,读取出的内容可能出现乱码,导致程序逻辑错误或数据损坏。
如何判断一个文件的编码格式?
可以使用第三方库 chardet 或 charset_normalizer 对文件的前几千字节进行采样分析,这些工具通过统计字符分布特征来推测编码,虽然无法达到100%精准,但对于大多数文本文件,其识别准确率足以满足日常开发需求。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/488696.html