Python的gzipfile模块主要用于高效处理gzip格式的压缩文件,它通过流式读写实现低内存占用,是处理大型日志或数据集的首选方案。
在日常的数据处理和文件管理工作中,我们经常会遇到体积庞大的文件,直接解压这些文件不仅耗时,还可能瞬间耗尽服务器内存,这时候,Python内置的gzip模块及其相关的文件操作类就成了我们的救星,它不像某些第三方库那样需要额外安装依赖,而是开箱即用,既稳定又高效,本文将深入探讨如何利用Python的gzipfile功能,解决从基础读写到异常处理的全链路问题。
gzipfile基础概念与适用场景
理解gzipfile的核心,在于明白它处理的是“流”而非“整个文件”,这意味着数据是边读边解压缩,或者边写边压缩,而不需要一次性将全部数据加载到内存中,这种机制对于处理GB级别的大文件至关重要。
何时选择gzipfile
业内专家指出,在处理结构化数据或非结构化文本时,gzipfile的表现尤为出色,Web服务器生成的Access日志,通常每天产生数百MB甚至数GB的数据,如果直接存储为纯文本,磁盘空间消耗巨大;如果全部解压后处理,内存极易溢出,使用gzipfile,我们可以直接读取压缩后的.gz文件,像操作普通文本文件一样逐行处理,既节省了存储空间,又保证了处理速度。
与其他压缩格式对比
很多人会问,python gzipfile和zipfile有什么区别?这是一个非常经典的对比场景。zipfile模块支持多文件归档,适合打包多个小文件;而gzip模块专注于单个文件的压缩,压缩率通常略高于zip,且解压速度更快,如果目标是单个大文件的传输或存储,gzipfile是更优解,与bzip2相比,gzip的压缩速度更快,虽然压缩率稍低,但在IO密集型任务中,速度往往比微小的空间节省更重要。
核心API操作指南
掌握正确的API调用方式,是避免踩坑的关键,Python的gzip模块提供了open函数,其用法与内置的open函数高度一致,但增加了压缩级别等参数。
读取压缩文件
读取gzip文件时,我们需要指定模式为'rb'(二进制读取)或'rt'(文本读取),对于中文内容,务必使用'rt'模式并指定编码,否则容易出现乱码。
import gzip
# 示例:读取gzip文件
with gzip.open('data.txt.gz', 'rt', encoding='utf-8') as f:
    for line in f:
        print(line.strip())
这段代码展示了最标准的读取流程。with语句确保了文件句柄的正确关闭,即使发生异常也能安全释放资源,对于python gzipfile读取中文乱码的问题,根源往往在于编码设置错误,确保源文件是UTF-8编码,并在open函数中显式声明encoding='utf-8',即可彻底解决。
写入压缩文件
写入操作同样简单,只需将模式改为'wb'或'wt',这里有一个常见的误区:很多人试图先写入内存再压缩,这不仅慢而且浪费内存,正确的做法是直接写入gzip对象,让底层自动完成压缩。
import gzip
# 示例:写入gzip文件
with gzip.open('output.txt.gz', 'wt', encoding='utf-8') as f:
    f.write("Hello, Gzip!n")
    f.write("This is a test line.n")
自定义压缩级别
默认情况下,gzip使用级别6进行压缩,如果你需要更快的写入速度,或者更高的压缩率,可以通过compresslevel参数进行调整,级别范围是1-9,1最快但压缩率最低,9最慢但压缩率最高,对于日志文件,通常建议使用默认值或级别1,因为日志写入频繁,速度优先。
进阶技巧与性能优化
在实际生产环境中,仅仅会读写是不够的,我们需要关注性能瓶颈和异常处理,确保程序的健壮性。
内存优化策略
处理超大型文件时,逐行读取是最佳实践,如果尝试一次性读取整个文件内容(如f.read()),可能会导致内存峰值飙升,对于python gzipfile大文件处理,建议采用迭代器模式,每次只加载一行或一个固定大小的块。
import gzip
def process_large_gzip(file_path):
    with gzip.open(file_path, 'rt', encoding='utf-8') as f:
        # 逐行迭代,内存占用恒定
        for line in f:
            yield process_line(line)
这种生成器模式允许你以流式方式处理数据,无论文件有多大,内存占用始终保持在极低水平。
异常处理机制
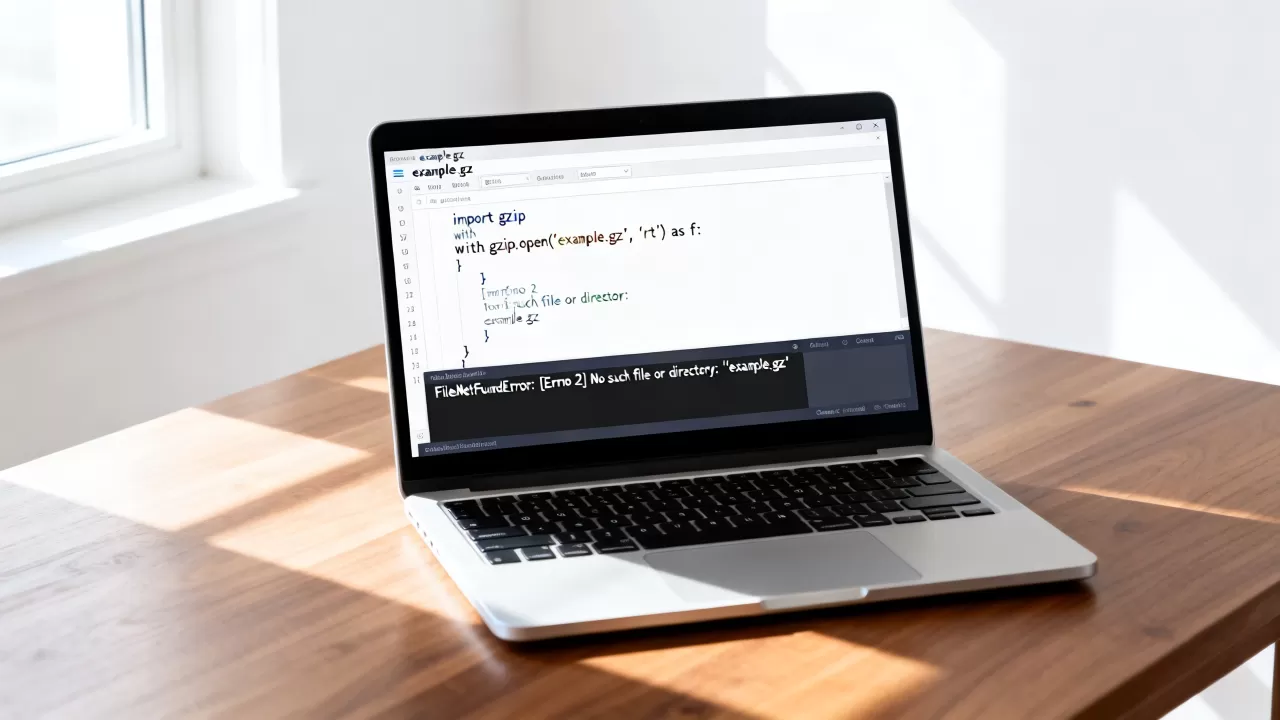
文件操作难免遇到意外,如文件损坏、权限不足或磁盘空间已满,使用try-except块捕获异常是必须的,常见的异常包括OSError(IO错误)和gzip.BadGzipFile(文件格式错误)。
import gzip
try:
    with gzip.open('corrupted.txt.gz', 'rt') as f:
        data = f.read()
except gzip.BadGzipFile:
    print("文件已损坏,无法解压")
except OSError as e:
    print(f"IO错误: {e}")
并行处理加速
对于I/O密集型任务,多线程或多进程可以显著提升速度,虽然gzip压缩本身是CPU密集型,但文件读写是I/O密集型,可以使用concurrent.futures模块来并行处理多个gzip文件。
from concurrent.futures import ThreadPoolExecutor
import gzip
def compress_file(file_path):
    with open(file_path, 'rb') as f_in:
        with gzip.open(f'{file_path}.gz', 'wb') as f_out:
            f_out.write(f_in.read())
files = ['log1.txt', 'log2.txt', 'log3.txt']
with ThreadPoolExecutor(max_workers=4) as executor:
    executor.map(compress_file, files)
常见问题解答
python gzipfile 中文乱码怎么解决?
乱码的根本原因是编码不匹配,确保在gzip.open中指定encoding='utf-8',并且源文件的编码也是UTF-8,如果源文件是GBK编码,需相应调整为encoding='gbk'。
python gzipfile 压缩率如何优化?
压缩率由compresslevel参数控制,范围1-9,默认值为6,若追求极致压缩率,可设为9,但速度会显著下降,若追求速度,可设为1,对于大多数场景,默认值已足够平衡速度与空间。
python gzipfile 和 zipfile 哪个更快?
在单个文件的压缩和解压场景下,gzipfile通常比zipfile更快,因为gzip协议更简单,开销更小,zipfile适用于多文件归档,若仅处理单个大文件,gzipfile是更优选择。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/485923.html