在服务器上部署深度学习模型的核心在于构建从硬件资源调度、环境隔离到服务化封装的完整流水线,推荐使用Docker容器化技术结合NVIDIA GPU驱动,以实现高并发下的稳定推理与资源高效利用。
很多人认为把模型文件拷进服务器就能跑,这其实是最大的误区,真正的部署不是简单的“运行脚本”,而是一场关于算力分配、内存管理和网络IO的系统工程,当你面对成千上万的用户请求时,单线程的Python脚本会瞬间崩溃,而一个健壮的部署架构能像精密的钟表一样,在毫秒级时间内给出准确预测。
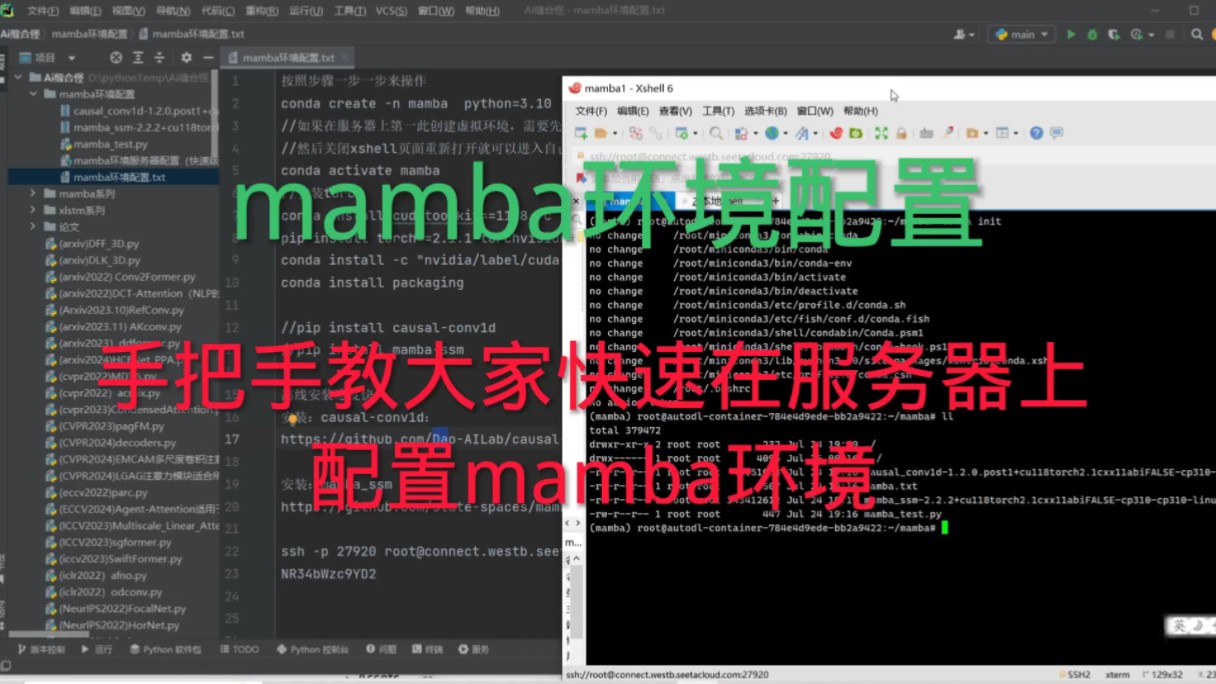
服务器硬件选型与驱动配置基础
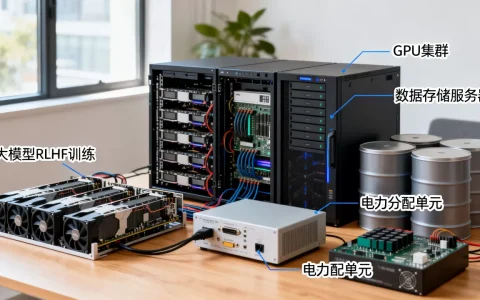
部署深度学习应用,第一步不是写代码,而是看清你的“战场”,不同的业务场景对硬件的需求天差地别,选错硬件不仅浪费预算,还会导致性能瓶颈。
GPU与CPU的资源博弈
业内专家指出,对于实时性要求极高的场景,如自动驾驶感知或在线推荐系统,GPU是绝对的主力,但在某些轻量级任务中,CPU反而更具性价比。
- 显存决定并发量:显存大小直接限制了你能同时加载多少个模型,以及Batch Size(批处理大小)能设多大,如果显存不足,程序会直接报错OOM(Out Of Memory)。
- CPU负责预处理:在数据进入GPU之前,图像缩放、文本分词等预处理工作通常由CPU完成,如果CPU性能太弱,GPU就会处于“等待喂食”的空闲状态,造成资源浪费。
操作系统与驱动环境
绝大多数深度学习框架都基于Linux环境,尤其是Ubuntu系列,Windows虽然也能跑,但在多卡管理和后台服务稳定性上存在先天劣势。
- 安装NVIDIA驱动:这是基础中的基础,务必确保驱动版本与CUDA版本兼容,CUDA 11.8通常对应470及以上版本的驱动。
- 配置CUDA Toolkit:这是GPU编程接口,注意,你不需要安装完整的CUDA包,只需安装对应版本的Runtime即可,节省大量磁盘空间。
- 验证环境:通过命令行输入
nvidia-smi,如果能看到显卡列表、驱动版本和显存使用情况,说明底层通路已打通。
容器化部署:解决环境冲突的终极方案
“在我电脑上能跑”是开发者最大的噩梦,依赖库版本冲突、Python版本不一致、系统库缺失,这些问题在单机开发时容易被忽视,但在服务器集群中却是灾难,Docker的出现,彻底解决了环境隔离问题。
为什么选择Docker进行模型部署
Docker将应用及其所有依赖打包成一个镜像,确保在任何服务器上运行结果一致,对于深度学习而言,这意味着你可以轻松地在本地开发,然后在云端生产环境无缝迁移。
- 环境一致性:无论服务器是新的还是旧的,只要安装了Docker,镜像里的Python、PyTorch、TensorFlow版本就固定不变。
- 资源限制:可以通过参数限制容器使用的CPU核心数和内存上限,防止某个模型服务占满整个服务器资源。
- 快速扩缩容:当流量激增时,只需启动多个相同的容器副本,配合负载均衡器即可实现水平扩展。
构建高效镜像的最佳实践
构建镜像时,体积越小,传输和启动越快。
- 使用官方基础镜像:优先选择
nvidia/cuda或pytorch/pytorch官方镜像,它们已经预编译了优化的底层库。 - 多阶段构建:第一阶段编译模型依赖,第二阶段只复制必要的运行时文件,这样可以剔除编译工具和临时文件,将镜像体积压缩50%以上。
- 层级缓存优化:将安装依赖的命令放在Dockerfile的前面,将复制代码的命令放在后面,这样当代码修改时,无需重新安装庞大的依赖库,利用Docker缓存加速构建。
模型服务化:从静态文件到API接口
模型训练完成后,它只是一个静态的二进制文件,为了让业务系统调用它,必须将其封装为RESTful API或gRPC服务,这一步决定了你的模型能否被前端、移动端或其他后端服务调用。
主流推理框架对比
直接使用Flask或FastAPI包装模型虽然简单,但在高并发下性能较差,业内共识认为,使用专门的推理引擎能显著提升吞吐量。
| 框架名称 | 适用场景 | 优势 | 劣势 |
|---|---|---|---|
| TorchServe | PyTorch模型 | 官方支持,插件丰富 | 配置相对复杂,启动较慢 |
| TensorFlow Serving | TF/Keras模型 | 高性能,支持版本管理 | 仅支持TF生态,学习曲线陡峭 |
| Triton Inference Server | 多框架混合 | 支持GPU/CPU混合推理,动态批处理 | 资源占用较高,架构较重 |
| FastAPI + ONNX Runtime | 轻量级需求 | 开发极快,资源占用低 | 高并发下需自行优化批处理 |
实现动态批处理(Dynamic Batching)
这是提升GPU利用率的关键技术,单个请求的推理延迟可能很高,但如果将多个请求打包成一个Batch一起送入GPU,虽然增加了单个请求的等待时间,但大幅提升了每秒处理的总请求数(Throughput)。
- 配置策略:在推理服务器配置文件中设置
max_batch_size和batch_delay,允许最多等待10毫秒,期间收集到的请求全部合并推理。 - 权衡延迟与吞吐:对于聊天机器人等对延迟敏感的场景,应减小批处理窗口;对于图片分类等离线任务,应增大批处理窗口以榨干GPU性能。
监控、日志与持续集成
部署上线不是终点,而是运维的开始,没有监控的部署就像在黑暗中驾驶,一旦出错,你甚至不知道故障点在哪里。
关键监控指标
你需要关注以下核心数据,它们直接反映服务的健康状况:
- GPU利用率:如果长期低于20%,说明存在IO瓶颈或模型太小,资源闲置。
- 推理延迟(Latency):P99延迟(99%的请求响应时间)比平均延迟更重要,它反映了极端情况下的用户体验。
- 错误率:监控HTTP 500错误,通常源于内存溢出或模型加载失败。
自动化部署流程
手动SSH登录服务器重启服务不仅效率低,而且容易出错,建立CI/CD流水线是专业团队的标配。
- 代码提交:开发者将新版本的模型或代码推送到Git仓库。
- 自动构建:Jenkins或GitLab CI自动触发Docker镜像构建,并运行单元测试。
- 灰度发布:先更新10%的流量到新服务,观察监控指标,若无异常,再全量切换。
- 回滚机制:一旦新服务出现大规模报错,系统自动切换回上一个稳定版本。
常见部署问题与优化策略
在实际操作中,你可能会遇到一些棘手的问题,以下是基于大量实战经验总结的解决方案。
显存泄漏排查
如果服务运行几天后崩溃,大概率是显存泄漏。
- 检查点释放:确保在推理结束后,及时调用
torch.cuda.empty_cache()或断开张量引用。 - 监控趋势:使用
nvidia-smi定期记录显存使用曲线,如果呈阶梯状上升,说明有未释放的内存块。
冷启动优化
对于Serverless架构或容器化部署,模型加载是最大的耗时点。
- 预热机制:在容器启动后,立即发送一个 dummy 请求,强制加载模型到显存中,避免第一个真实用户等待过久。
- 模型量化:将FP32模型转换为INT8或FP16精度,不仅减少显存占用,还能加速推理过程,尤其适合边缘设备部署。
跨平台兼容性
有时模型在Linux服务器上表现良好,但在Windows本地测试时出错。
- 路径分隔符:代码中统一使用
os.path.join或pathlib,避免硬编码或。 - 编码问题:确保所有文本文件使用UTF-8编码,避免在读取配置文件或日志时出现乱码。
深度学习服务器部署常见问题解答
深度学习服务器部署需要多少预算?
预算差异极大,取决于规模,个人开发者使用云服务商的按需实例,每月可能只需几百元;而企业级集群,包含GPU服务器、高速网络存储和负载均衡器,初期投入通常在数十万至数百万不等,建议根据峰值QPS(每秒查询率)估算所需GPU数量,再结合云厂商的预留实例折扣进行成本优化。
如何优化深度学习服务器部署中的推理速度?
优化是一个系统工程,使用ONNX或TensorRT等工具对模型进行算子融合和量化,这是提升速度最直接的手段,调整Batch Size,找到延迟与吞吐量的最佳平衡点,确保数据预处理流水线与模型推理流水线并行执行,避免CPU等待GPU或GPU等待数据。
深度学习服务器部署失败的主要原因是什么?
多数情况下,失败源于环境配置错误,如CUDA版本与驱动不匹配,或Docker镜像中缺少必要的系统库,其次是资源不足,如显存溢出或内存耗尽,最后是代码逻辑问题,如未正确处理异常或死锁,建议在部署前进行严格的环境一致性测试,并建立完善的日志监控体系,以便快速定位故障根源。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/481376.html