K8s故障排查方法
在现代云原生架构中,Kubernetes(K8s)已成为容器编排的事实标准,随着集群规模的扩大和微服务复杂度的提升,故障排查(Troubleshooting)成为了运维团队面临的最大挑战之一,高效的故障排查不仅能缩短平均恢复时间(MTTR),还能显著提升系统的可用性,本文将深入探讨K8s故障排查的核心方法论、常用工具及最佳实践,帮助工程师构建系统化的排错思维。
建立系统化的排查思维
面对K8s集群中的异常,盲目重启或修改配置往往治标不治本,专业的排查应遵循“从宏观到微观,从网络到应用”的逻辑链条。

明确故障现象
需要准确界定故障范围:
- 是单Pod异常还是全局性故障?
- 是启动失败、运行中断还是性能下降?
- 是否伴随特定的错误代码(如OOMKilled, CrashLoopBackOff, ImagePullBackOff)?
分层排查模型
K8s的架构层次分明,建议按照以下顺序进行隔离:
- 应用层:日志分析、应用健康检查。
- 容器层:资源限制、镜像完整性。
- Pod/Node层:调度状态、节点资源、网络插件。
- 集群/控制平面层:API Server、Etcd、Controller Manager。
核心排查工具与命令实战
kubectl是K8s操作的核心CLI工具,熟练掌握其子命令是高效排错的基础。
查看Pod状态与事件
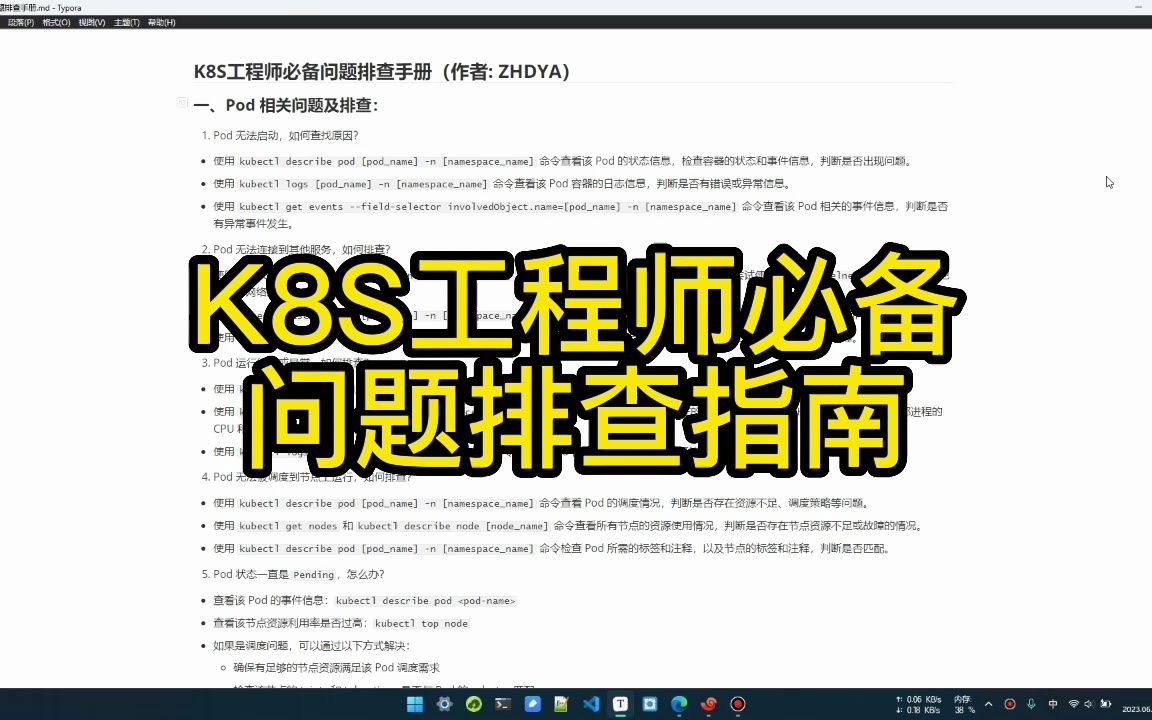
当Pod处于Pending、CrashLoopBackOff或Error状态时,第一步永远是查看其事件记录。
# 查看指定命名空间下所有Pod的状态
kubectl get pods -n <namespace>
# 查看特定Pod的详细事件,这是定位调度失败或镜像拉取失败的关键
kubectl describe pod <pod-name> -n <namespace>
在describe输出中,重点关注Events部分,若看到FailedScheduling,通常意味着资源不足或节点选择器不匹配;若看到ErrImagePull,则需检查镜像仓库权限或网络连通性。
深入容器日志
应用内部的错误信息往往隐藏在容器日志中。
# 查看最新日志
kubectl logs <pod-name> -n <namespace>
# 查看重启前的日志(对于CrashLoopBackOff至关重要)
kubectl logs <pod-name> -n <namespace> --previous
# 查看多容器Pod中特定容器的日志
kubectl logs <pod-name> -n <namespace> -c <container-name>
注意:如果日志输出过大,建议使用tail或grep进行过滤,kubectl logs <pod-name> | grep ERROR。
进入容器进行交互式调试
当日志无法提供足够信息时,可以直接进入容器内部进行调试。
# 启动一个临时调试容器,挂载原Pod的卷
kubectl debug node/<node-name> -it --image=busybox
# 进入正在运行的Pod中的特定容器
kubectl exec -it <pod-name> -n <namespace> -c <container-name> -- /bin/sh
在容器内,可以使用curl测试API连通性,使用nslookup检查DNS解析,使用netstat或ss检查端口监听情况。
常见故障场景深度解析
Pod无法启动(Pending状态)
原因分析:
- 资源不足:集群中剩余CPU或内存无法满足Request要求。
- 节点选择器不匹配:Pod的
nodeSelector或affinity规则在当前集群中无符合的节点。 - 持久卷绑定失败:PVC无法绑定到可用的PV。
排查步骤:
- 执行
kubectl describe pod,查看Events中是否有Insufficient cpu或No nodes available。 - 检查节点资源使用情况:
kubectl top nodes。 - 检查PV/PVC状态:
kubectl get pvc,确认是否处于Pending状态。
容器频繁重启(CrashLoopBackOff)
原因分析:
- 应用启动失败:配置文件错误、依赖服务不可达。
- 资源超限:内存使用超过Limit导致OOMKilled。
- 健康检查失败:Liveness Probe配置不当,导致容器被误杀。
排查步骤:
- 查看
--previous日志,寻找启动时的异常堆栈。 - 检查资源限制设置,对比
kubectl top pod的实际使用情况。 - 审查Deployment YAML中的
livenessProbe和readinessProbe配置,确保探针路径和超时时间合理。
网络不通(Service/Endpoint异常)
原因分析:
- Endpoint缺失:Service未正确关联到Pod。
- 网络插件故障:CNI插件(如Calico, Flannel)异常。
- 防火墙/安全组限制:云厂商的安全组规则阻止了流量。
排查步骤:
- 检查Service的Endpoints:
kubectl get endpoints <service-name> -n <namespace>。 - 验证Selector是否正确:确保Service的
selector与Pod的labels完全匹配。 - 测试Pod间网络连通性:在两个不同节点上的Pod中互相
ping或curl。
高级排查技巧:使用eBPF与监控集成
对于复杂的生产环境,仅靠kubectl命令可能效率低下,引入现代化的可观测性工具是必然趋势。
集成Prometheus与Grafana
通过部署Prometheus Operator,可以实时监控集群指标,重点关注以下指标:
- kube_pod_status_phase:监控Pod状态分布。
- container_memory_usage_bytes:监控内存使用趋势,预防OOM。
- kubelet_pleg_relist_duration_seconds:监控PLEG(Pod Lifecycle Event Generator)延迟,若过高可能暗示节点负载过重或磁盘IO瓶颈。
使用eBPF进行内核级追踪
对于性能瓶颈或难以捉摸的网络问题,eBPF技术提供了无需修改内核源码即可追踪系统调用的能力。
- 工具推荐:
bpftrace、Pixie、Cilium Hubble。 - 应用场景:追踪慢查询、分析TCP重传、监控系统调用延迟。
预防优于治疗:构建高可用架构
故障排查的最终目标是减少故障发生,以下措施可显著提升K8s集群的稳定性:
- 合理的资源配额(Resource Quotas):在命名空间级别限制资源使用,防止单个租户耗尽集群资源。
- 完善的健康检查:配置合理的Liveness和Readiness Probe,确保流量只路由到健康的Pod。
- 自动扩缩容(HPA/VPA):根据CPU/内存使用率自动调整副本数或资源请求值。
- 定期演练:通过Chaos Engineering(混沌工程)工具(如Chaos Mesh)定期注入故障,验证系统的自愈能力。
K8s故障排查是一项结合了系统知识、网络原理和应用逻辑的综合技能,建立标准化的排查流程,熟练运用kubectl及可观测性工具,并持续优化集群架构,是保障业务连续性的关键,随着云原生技术的演进,自动化故障诊断和智能运维(AIOps)将成为未来发展的重点方向。
服务器资源推荐与活动优惠
为了保障K8s集群的稳定运行,选择合适的服务器硬件至关重要,我们特别推出针对云原生场景优化的服务器配置,满足高并发、低延迟的业务需求。
2026年度云原生专属优惠活动
| 服务器配置 | 核心规格 | 内存 | 带宽 | 适用场景 | 2026年特惠价 (元/月) |
|---|---|---|---|---|---|
| 入门级 K8s Node | 4 vCPU | 8 GB | 5 Mbps | 开发测试、小型微服务集群 | ¥199 |
| 标准级 K8s Master | 8 vCPU | 16 GB | 10 Mbps | 生产环境控制平面、中小型集群 | ¥399 |
| 高性能 K8s Worker | 16 vCPU | 32 GB | 20 Mbps | 高负载应用、大数据处理节点 | ¥799 |
| 企业级 K8s Cluster | 32 vCPU | 64 GB | 50 Mbps | 大规模集群、核心业务承载 | ¥1599 |
活动说明:
- 活动时间:2026年1月1日 – 2026年12月31日
- :所有K8s优化服务器享受5折优惠,并赠送价值¥500的集群监控插件License。
- 技术支持:购买企业级配置用户,可享受7×24小时专属K8s专家技术支持服务。
立即行动,为您的云原生架构奠定坚实基础。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/481150.html