Hadoop数据仓库的核心价值在于利用HDFS实现海量数据的低成本存储,并通过MapReduce或Spark引擎完成离线批处理,最终为上层BI工具提供稳定、一致的分析数据源,它是构建企业级大数据平台的基石。
在数字化转型的深水区,企业面对的数据量呈指数级增长,传统的MySQL或Oracle数据库早已不堪重负,无法应对TB甚至PB级的数据吞吐,基于Hadoop生态构建的数据仓库成为许多中大型企业的必然选择,它不仅仅是一个存储系统,更是一套完整的数据治理与分析框架。
Hadoop数据仓库整体架构解析
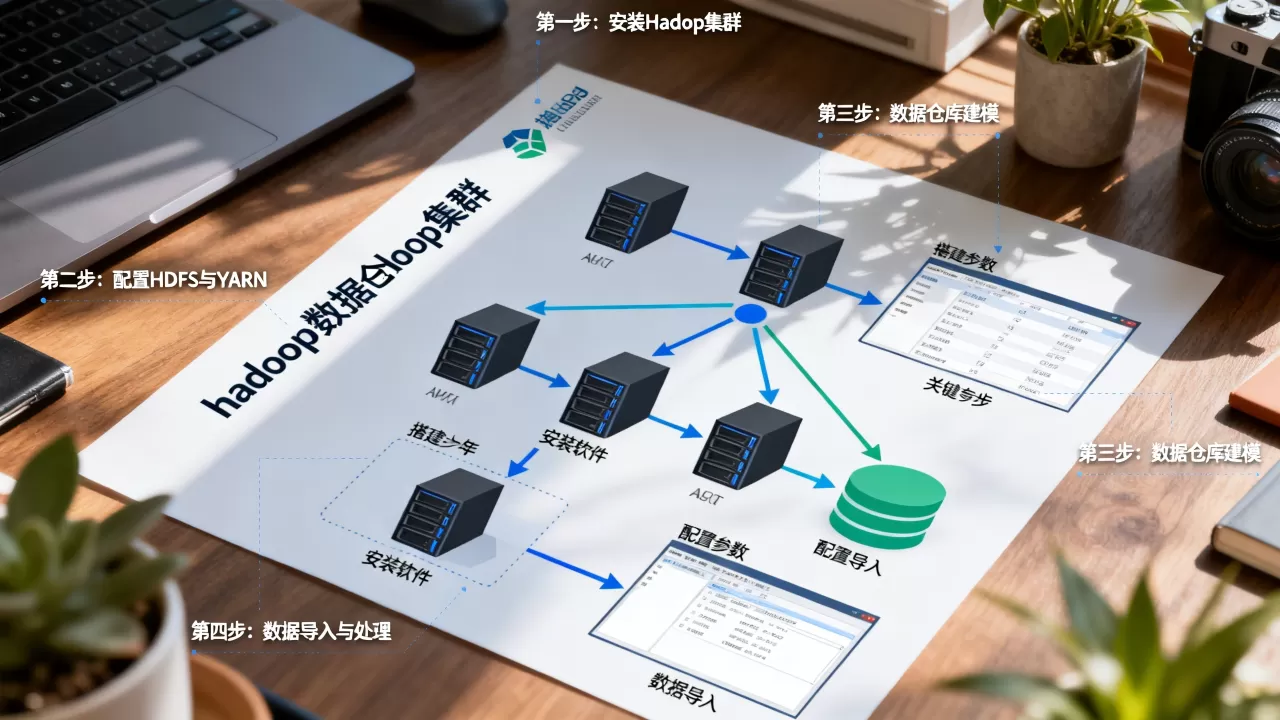
理解Hadoop数据仓库,首先要看清其分层架构,业内专家指出,这种分层设计并非为了炫技,而是为了解耦,让数据从采集到应用的路径清晰可控。
数据源层:多源异构数据的入口
一切始于数据,在这个层级,你需要处理来自业务系统、日志文件、传感器以及第三方API的各种数据。
- 结构化数据:来自ERP、CRM系统的订单、用户信息,通常通过Sqoop等工具导入。
- 半结构化数据:JSON格式的日志、XML配置文件,适合直接存入HDFS或NoSQL数据库。
- 非结构化数据:图片、视频、音频,直接以文件形式存储在HDFS中。
这一层的关键在于“全量接入”,不要试图在源头清洗所有脏数据,那是数仓中层的工作。
数据存储层:HDFS与元数据管理
这是Hadoop的底座,HDFS(Hadoop Distributed File System)负责将大文件切块,分散存储在集群的各个节点上,提供高容错性和高吞吐率。
- 高可用性:通过副本机制(默认3副本),确保单点故障不影响数据读取。
- 扩展性:只需增加节点即可线性扩展存储容量,无需停机。
Hive Metastore负责管理元数据,将HDFS上的文件映射为数据库中的表,让不懂Java代码的业务人员也能通过SQL查询数据。
数据处理层:计算引擎的选择
数据存下来只是第一步,算得动才是硬道理,这里涉及两种主流模式:
- MapReduce:早期的标准引擎,适合离线、超大规模数据的批处理,但迭代次数多时效率较低。
- Spark:基于内存的计算引擎,速度比MapReduce快10-100倍,是目前实时流处理和复杂ETL的首选。
在实际操作中,多数企业采用“Spark做ETL,Hive做查询”的组合策略,Spark负责将原始数据清洗、转换后写入Hive表,Hive则利用其SQL接口对外提供服务。
核心组件与数据流转机制
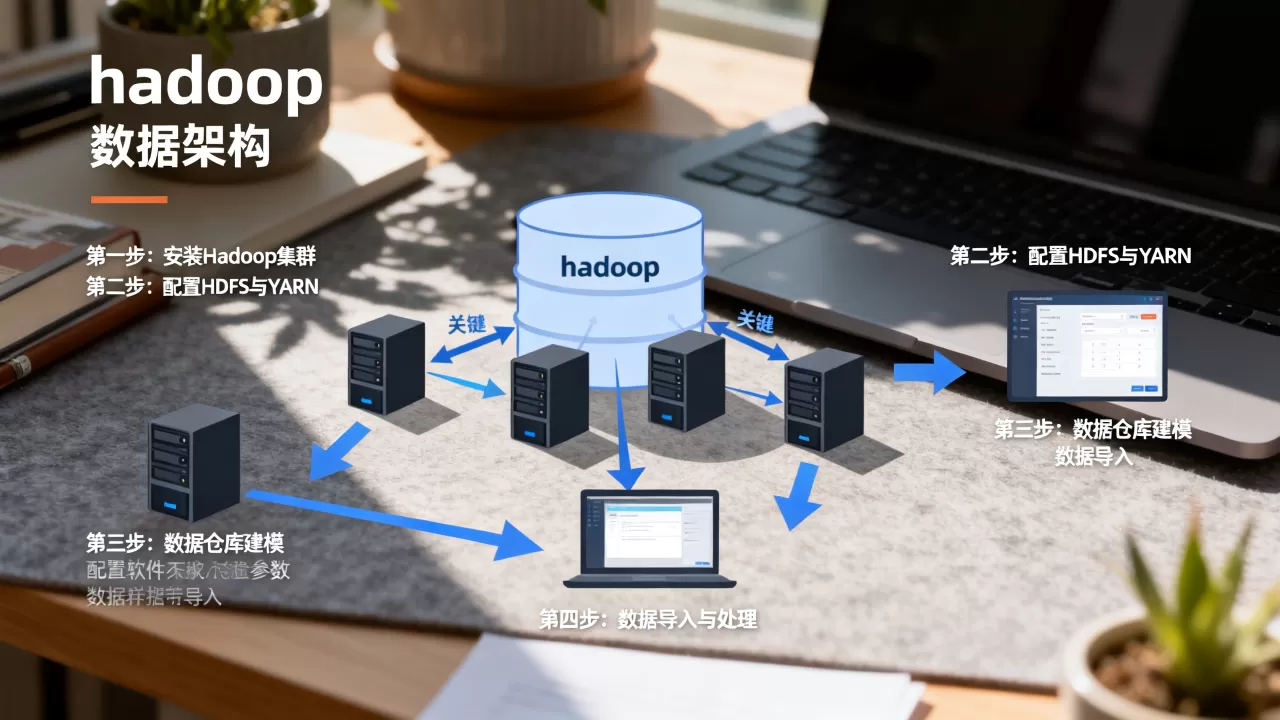
要让数据仓库跑起来,必须理清数据是如何流动的,这涉及到几个关键组件的协同工作。
数据采集与传输
Flume是日志采集的利器,它能从Web服务器抓取日志并实时推送到HDFS,对于数据库同步,Sqoop是经典选择,它能高效地在关系型数据库和Hadoop之间传输数据。
数据仓库建模
在Hive中建立数据仓库,必须遵循维度建模理论。
- ODS层(操作数据层):保持与源系统一致,不做修改,仅做备份。
- DWD层(明细数据层):进行数据清洗、脱敏、标准化,是数仓的核心。
- DWS层(汇总数据层):按主题域进行轻度汇总,如“用户行为日报”。
- ADS层(应用数据层):面向具体报表,提供最终结果数据。
这种分层结构能有效避免重复计算,提升查询性能。
Hadoop数据仓库与其他方案的对比分析
很多企业在选型时会有疑问,Hadoop数据仓库到底比传统方案好在哪里?
成本与扩展性对比
传统MPP数据库(如Greenplum)性能强劲,但硬件成本极高,且扩展困难,Hadoop基于廉价x86服务器,存储成本仅为传统方案的1/5甚至更低,对于预算有限但数据量巨大的企业,Hadoop是更务实的选择。
处理模式对比
| 特性 | 传统数据仓库 (RDBMS) | Hadoop数据仓库 |
|---|---|---|
| 数据规模 | TB级以下 | PB级及以上 |
| 计算引擎 | 专用硬件加速 | 通用CPU集群 |
| 数据格式 | 强模式,结构化为主 | 弱模式,支持多格式 |
| 实时性 | 高,支持事务 | 低,主要面向离线批处理 |
| 灵活性 | -schema-on-write | schema-on-read |
需要注意的是,Hadoop并非万能,如果业务对实时性要求极高(如毫秒级响应),Hadoop并非最佳选择,此时应考虑Flink或ClickHouse等实时数仓方案。
实施Hadoop数据仓库的常见挑战
尽管架构成熟,但在落地过程中,坑依然不少。
数据倾斜问题
这是分布式计算中最头疼的问题,当某个Key的数据量远大于其他Key时,会导致个别节点负载过高,拖慢整个任务,解决思路包括:加盐打散Key、调整Reduce数量、使用MapJoin优化小表关联。
小文件问题
HDFS不适合存储大量小文件,因为NameNode内存消耗巨大,在ETL过程中,需定期合并小文件,或调整Map输出合并参数。
数据一致性
Hadoop默认采用最终一致性,在金融等强一致性要求场景下,需结合HBase或ZooKeeper进行额外控制,或采用事务型Hive表(如ACID支持)。
未来演进:从Hadoop到云原生数仓
随着云计算的发展,纯本地部署的Hadoop集群正在减少,越来越多的企业选择云上的托管服务,如简米云MaxCompute、AWS EMR或Azure HDInsight。
这些云原生方案继承了Hadoop的核心逻辑,但屏蔽了底层运维复杂度,它们支持存算分离,进一步降低了成本,对于中小企业而言,直接采用云数仓服务,往往比自建Hadoop集群更具性价比。
Hadoop数据仓库常见问题解答
Hadoop数据仓库适合哪些行业场景?
Hadoop数据仓库特别适合互联网、电商、金融、电信等行业,这些行业数据量大、增长快,且需要复杂的用户行为分析和风控模型,电商平台利用Hadoop数仓分析用户点击流,实现精准推荐;银行利用其进行反欺诈交易监测。
搭建Hadoop数据仓库需要多少预算?
预算取决于数据规模和性能要求,自建集群需考虑服务器硬件、机房电力、运维人力成本,初期小规模集群(10-20节点)硬件投入可能在几十万元级别,但隐性运维成本较高,若采用云服务,通常按存储量和计算时长付费,初期投入更低,但长期运行成本需精细核算,业内共识认为,对于数据量超过100TB的企业,自建或混合云模式更具经济性。
如何确保Hadoop数据仓库的数据质量?
数据质量是数仓的生命线,在ODS层建立数据校验规则,拦截异常数据,在DWD层实施严格的数据清洗逻辑,如去重、空值处理、格式标准化,建立数据监控体系,对核心指标进行波动监测,一旦数据量或分布出现异常,立即告警。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/478012.html