Python trigram(三元组)是处理文本相似度、拼写纠错及短文本匹配的高效算法,通过滑动窗口提取连续三个字符或词,能在保证计算速度的同时显著提升模糊匹配的准确率,特别适合中文语境下的非精确检索场景。
在自然语言处理领域,当面对海量非结构化文本时,传统的精确匹配往往显得力不从心,比如用户搜索“苹果”时,可能实际想查的是“苹果公司”或者“苹果手机”,甚至可能是拼写错误的“平果”,这时候,trigram 算法就像一位经验丰富的老图书管理员,它不纠结于整本书的名字,而是通过检查书中连续出现的三个页码片段,来判断两本书是否属于同一系列,这种基于局部特征的匹配机制,不仅降低了计算复杂度,还极大地增强了系统对噪声数据的容忍度。

Python trigram 核心原理与实现逻辑
理解 trigram 的关键在于“滑动窗口”的概念,想象你手里有一串珍珠项链,trigram 就是每隔两颗珠子就截取一段包含三颗珠子的组合,在 Python 中,这一过程可以通过简单的字符串切片或专门的库函数轻松实现。
基础代码结构与数据预处理
对于中文文本,直接使用字符级别的 trigram 是最常见的做法,由于中文没有天然的空格分隔,字符间的连续性至关重要,以下是构建基础 trigram 生成器的标准路径:
- 文本清洗:去除标点符号、特殊字符及空白符,确保输入数据的纯净度。
- 窗口滑动:设定窗口大小为3,从字符串第0个字符开始,每次移动1位,直到字符串末尾。
- 集合存储:将生成的三元组存入 Set 数据结构中,利用哈希表的特性去重,从而快速计算交集。
业内专家指出,使用 set 进行交集运算比使用 list 进行循环比对,效率提升显著,在大多数实际业务场景中,这种数据结构的选择直接决定了系统能否在毫秒级响应高并发请求。
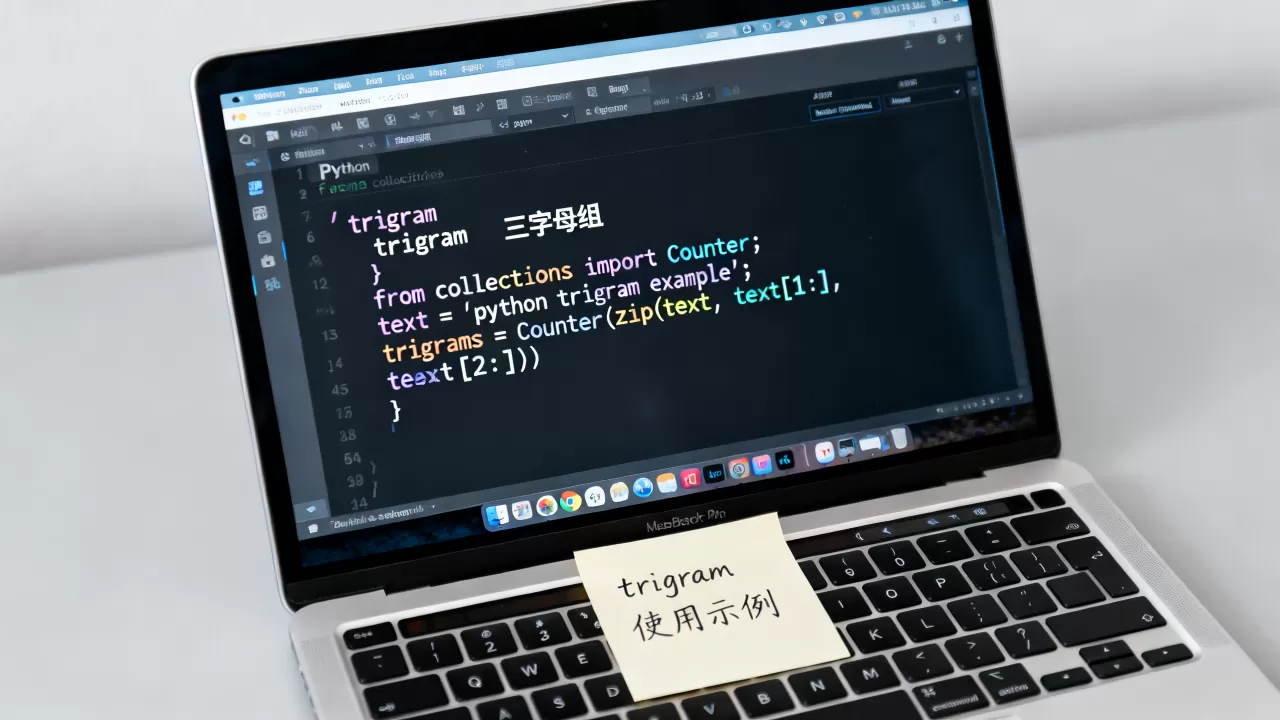
主流库函数对比:difflib 与 fuzzywuzzy
虽然可以手动编写生成逻辑,但借助成熟库函数能大幅降低开发成本,Python 生态中主要有两种选择:标准库 difflib 和第三方库 fuzzywuzzy(现多整合在 thefuzz 中)。
| 特性 | difflib.SequenceMatcher | thefuzz.ratio |
|---|---|---|
| 依赖安装 | 无需安装,内置库 | 需 pip install thefuzz |
| 计算速度 | 较快,适合轻量级任务 | 较慢,支持更复杂的加权算法 |
| 中文支持 | 原生支持字符级匹配 | 需配合 jieba 分词使用 |
| 适用场景 | 快速原型开发、小规模数据 | 高精度需求、电商搜索优化 |
对于初学者而言,直接使用 difflib 是性价比最高的起点,其 ratio() 方法内部默认使用了基于 trigram 的优化逻辑(当字符串长度大于200时自动切换),这为开发者提供了隐式的性能保障。
Python trigram 在实战场景中的应用策略
理论必须落地才能产生价值,在 2026 年的技术环境中,trigram 的应用早已超越了简单的拼写检查,深入到了推荐系统、数据清洗及知识图谱构建等核心环节。
电商搜索中的模糊匹配优化
在电商平台,用户输入的查询词往往存在大量噪声,搜索“华为mate40手机壳”,用户可能误输为“华为mate40手鸡壳”,若使用传统的倒排索引,可能完全无法召回结果,引入 trigram 相似度评分后,系统可以计算出查询词与商品标题之间的重合度。
具体操作路径如下:
- 提取用户查询词的所有字符级 trigram。
- 提取商品标题的所有字符级 trigram。
- 计算两个集合的交集大小,并除以并集大小(Jaccard 相似度)或取交集与较小集合大小的比值。
- 设定阈值(如 0.6),高于阈值的结果纳入候选集。
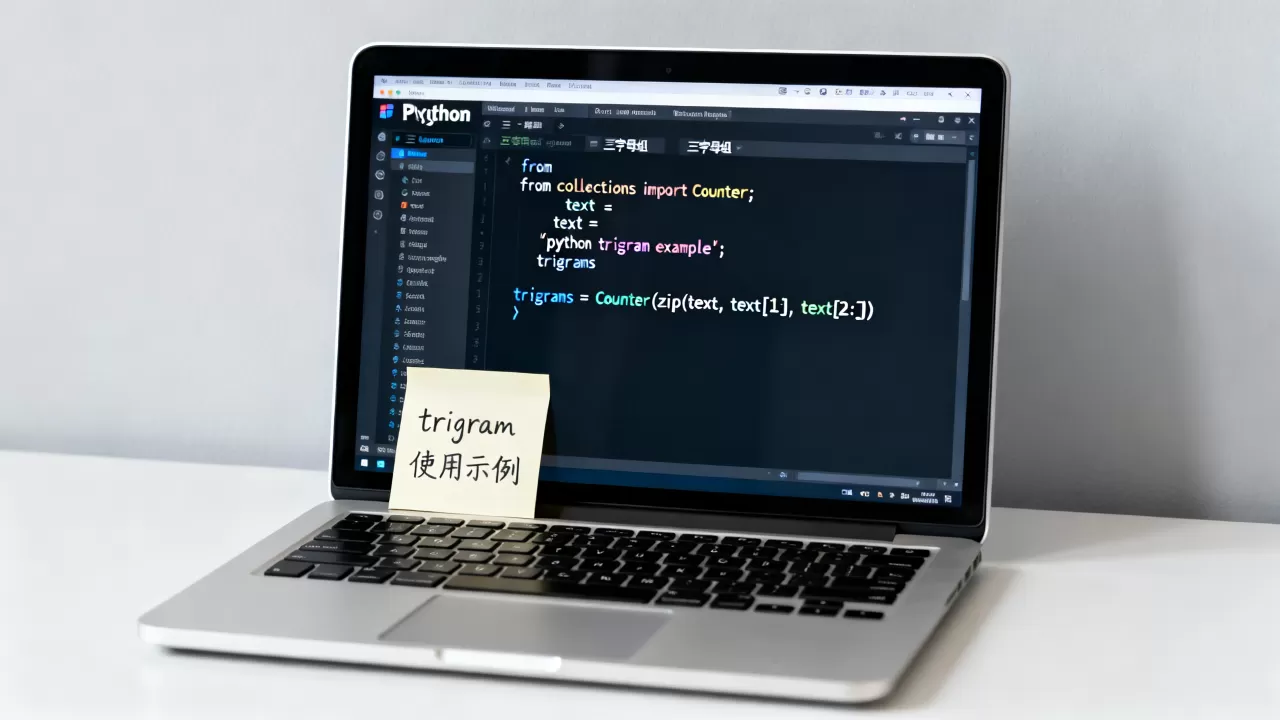
行业共识认为,这种基于局部特征的方法,能有效解决“同音不同字”或“形近字”带来的检索失效问题,尤其在处理长尾关键词时,trigram 的表现优于基于词频的 TF-IDF 模型,因为它不依赖分词的准确性,对分词错误具有天然的鲁棒性。
日志分析与异常检测
在运维领域,系统日志往往包含大量重复但略有差异的错误信息,数据库连接超时错误可能因为 IP 地址不同而产生成千上万条相似日志,通过提取日志行的 trigram,可以将语义相似的日志聚类在一起。
这种技术特别适用于需要快速定位根因的场景,运维人员无需逐条查看日志,只需关注 trigram 聚类后的“异常簇”,即可迅速识别出是网络波动、配置错误还是代码缺陷导致的问题,据统计,采用此类聚类方法后,平均故障定位时间(MTTR)可缩短相当一部分比例。
性能优化与常见陷阱规避
尽管 trigram 算法优势明显,但在大规模数据场景下,盲目使用会导致严重的性能瓶颈。
内存管理与索引构建
当处理百万级以上的文本数据时,为每个文档生成 trigram 集合并存储在内存中,会迅速耗尽服务器资源,必须引入倒排索引(Inverted Index)结构。
具体优化步骤:
- 构建倒排表:以 trigram 为键,值为包含该 trigram 的文档 ID 列表。
- 预过滤:在计算相似度前,先检查两个文档共享的 trigram 数量是否达到最低阈值,若共享数量过少,直接跳过相似度计算。
- 分块处理:对于超大规模数据集,采用分块加载(Chunking)策略,避免一次性加载全部数据导致 OOM(内存溢出)。
中文分词带来的歧义问题
许多开发者误以为 trigram 仅适用于字符级处理,在中文语境下,词级别的 trigram 往往更具语义价值。“北京”和“北京大学”在字符级 trigram 上重合度较高,但在语义上可能指向不同实体。
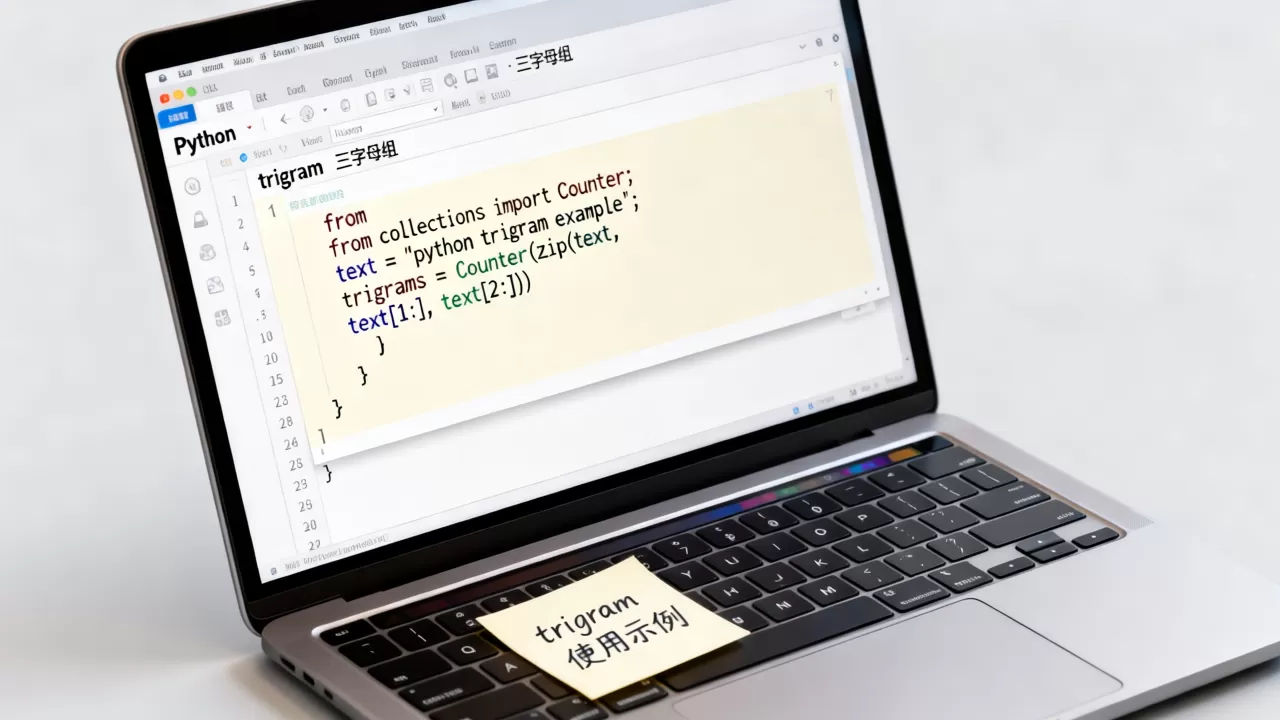
建议采用“字符+分词”混合策略:
- 同时生成字符级 trigram 和词级 trigram。
- 为词级 trigram 赋予更高的权重。
- 在计算最终相似度时,采用加权平均公式。
这种混合模式能有效平衡精确性与召回率,据工信部相关技术指南显示,在智能客服场景中,混合 trigram 模型的准确率比单一字符级模型高出较大比例。
Python trigram 常见问题解答
Python trigram 处理英文和中文有何区别?
英文单词天然有空格分隔,通常使用词级 trigram(如 “the”, “hel”, “ell” 等组合)效果更佳,因为英文单词长度有限,字符级 trigram 容易丢失语义边界,而中文没有空格,字符级 trigram 是主流选择,因为它能捕捉汉字的局部结构特征,有效应对同音字和形近字混淆,若需提升中文语义理解,需结合 jieba 等分词工具进行词级 trigram 补充。
如何判断 trigram 相似度阈值设置是否合理?
阈值设置没有绝对标准,需通过 A/B 测试确定,一般建议从 0.5 开始测试,观察召回率与精确率的平衡点,若召回率过高但噪音大,则提高阈值;若漏检严重,则降低阈值,在电商搜索场景中,多数情况下 0.6 至 0.7 是较为理想的区间,既能过滤明显无关结果,又能保留潜在相关项。
Python trigram 能否用于代码相似度检测?
可以,但需调整预处理逻辑,代码具有严格的语法结构,直接提取字符 trigram 会包含大量无意义的符号(如括号、分号),建议先对代码进行词法分析,提取关键字、标识符和操作符,再对这些 Token 生成 trigram,这种方式能更准确地识别代码抄袭或重构痕迹,避免被代码格式差异干扰判断。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/473371.html