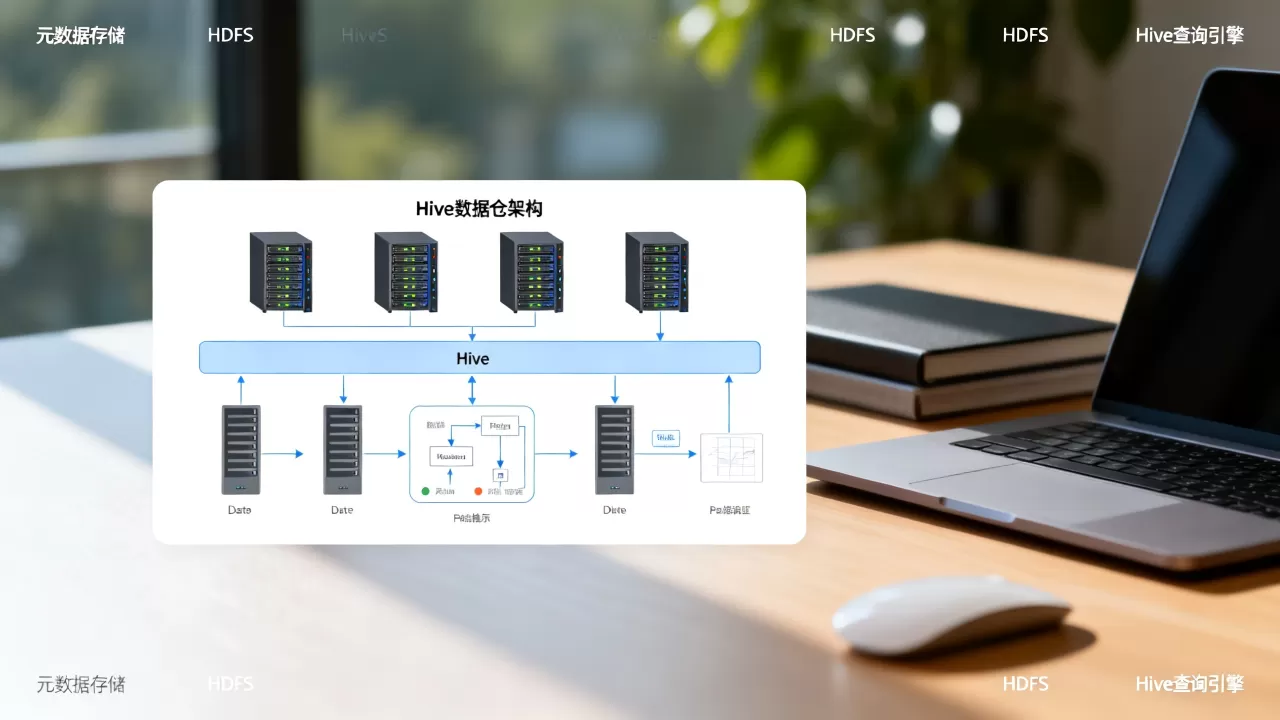
Hive数据仓库架构的核心在于利用Hadoop生态将结构化数据映射为表,通过SQL接口实现大规模数据的离线分析,其本质是MapReduce或Tez执行引擎之上的抽象层。
Hive架构核心组件解析
理解Hive架构,首先要打破“它只是一个数据库”的误区,Hive并非传统的关系型数据库,而是一个基于Hadoop的数据仓库工具,它的核心价值在于降低大数据处理的门槛,让熟悉SQL的开发人员无需编写复杂的MapReduce代码,即可对海量数据进行统计分析。
用户接口层:交互的入口
用户接口层是Hive与外界沟通的桥梁,业内专家指出,这一层的设计初衷是为了兼容现有的SQL生态,确保用户能够无缝迁移。
- CLI(命令行接口):这是最基础的交互方式,适合脚本自动化任务和简单的调试。
- JDBC/ODBC驱动:对于Java、Python等应用程序,通过驱动连接HiveServer2,实现远程查询。
- Web UI:提供可视化的管理界面,方便查看作业状态和元数据信息。
元数据存储:数据的地图
元数据(Metadata)是Hive的灵魂,它存储了表的结构信息,如表名、列名、数据类型、分区信息以及数据在HDFS上的存储路径,如果没有元数据,Hive就只是一堆无法识别的二进制文件。
- 内嵌模式(Derby):默认配置,仅支持单会话连接,适合本地测试,生产环境严禁使用。
- 本地模式(MySQL/PostgreSQL):将元数据存储在外部关系型数据库中,支持多用户并发访问,是企业级部署的标准选择。
元数据同步的重要性
当HDFS上的数据文件发生变动(如新增分区、修改Schema),元数据必须同步更新,否则,Hive查询将返回错误结果或抛出异常,维护元数据的一致性是整个架构稳定性的基石。
执行引擎与存储机制对比
Hive的性能瓶颈往往不在于SQL解析,而在于底层的执行引擎和存储格式,选择合适的组合,直接决定了查询效率。
执行引擎的演进路线
早期的Hive默认使用MapReduce引擎,虽然稳定性高,但启动开销大,延迟高,不适合交互式查询,随着技术发展,业界逐渐转向更高效的引擎。
- MapReduce:老牌引擎,适合离线批量处理,容错性强,但速度慢。
- Tez:基于DAG(有向无环图)的执行引擎,减少了中间结果的落地,显著提升了ETL任务的执行速度。
- Spark:内存计算引擎,对于迭代式算法和交互式查询表现优异,但资源消耗较大。
存储格式的选择策略
数据在HDFS上的存储格式直接影响I/O效率和CPU开销,常见的格式包括TextFile、SequenceFile、RCFile、ORC和Parquet。
| 存储格式 | 压缩比 | 查询速度 | 适用场景 |
|---|---|---|---|
| TextFile | 低 | 慢 | 数据导入、日志存储 |
| ORC | 高 | 快 | 列式分析、复杂查询 |
| Parquet | 高 | 快 | 混合负载、跨平台兼容 |
行业共识认为,在大多数OLAP(联机分析处理)场景下,ORC或Parquet是首选,它们支持列式存储,能够大幅减少I/O读取量,并支持谓词下推(Predicate Pushdown),即在读取数据前就过滤掉不需要的列和行。
分区与分桶的实战应用
在处理PB级数据时,全表扫描是不可接受的,通过分区和分桶技术,可以极大提升查询效率,这是Hive性能优化的关键手段,也是许多初学者容易混淆的概念。
分区:粗粒度的数据隔离
分区是将数据按照特定字段(如日期、地区)划分为不同的目录,查询时,Hive只会扫描符合条件的分区目录,从而避免全表扫描。
- 静态分区:手动指定分区值,适用于数据量固定且已知的场景。
- 动态分区:根据数据内容自动创建分区,适用于数据流入不确定且量大的场景。
分桶:细粒度的数据分布
分桶是对数据进行哈希取模,将数据分散到固定数量的文件中,它主要用于提高Join操作的效率,特别是Map-Side Join。
- 适用场景:当两个大表进行Join操作,且Join键分布均匀时,分桶可以确保相同键的数据落在同一个文件中,从而避免Shuffle阶段的数据倾斜。
- 注意事项:分桶数量必须是2的幂次方,且需要设置
hive.enforce.bucketing参数。
常见问题与优化建议
在实际生产环境中,Hive往往面临数据倾斜、小文件过多等问题,解决这些问题需要结合具体的业务场景进行调整。
数据倾斜的处理方案
数据倾斜是指某些Reduce任务处理的数据量远大于其他任务,导致整体作业进度缓慢。
- 开启Map端聚合:设置
hive.map.aggr=true,在Map阶段预先聚合数据,减少Shuffle数据量。 - 空值过滤:对于Join键为NULL的数据,赋予随机值,避免NULL值集中到一个Reduce节点。
- 加大Reducer数量:通过设置
hive.exec.reducers.bytes.per.reducer参数,强制增加Reducer数量,分散负载。
小文件治理
HDFS不适合存储大量小文件,这会消耗NameNode的内存资源,并降低读取效率。
- 合并策略:在ETL任务结束后,使用
HDFS Balancer或专门的合并工具,将小文件合并为大文件。 - 调整参数:设置
hive.merge.mapfiles和hive.merge.mapredfiles,让Hive在任务结束时自动合并小文件。
Hive与其他数据仓库技术的对比
随着大数据技术的发展,出现了许多新的数据仓库解决方案,了解Hive的定位,有助于在技术选型时做出正确决策。
Hive vs Impala
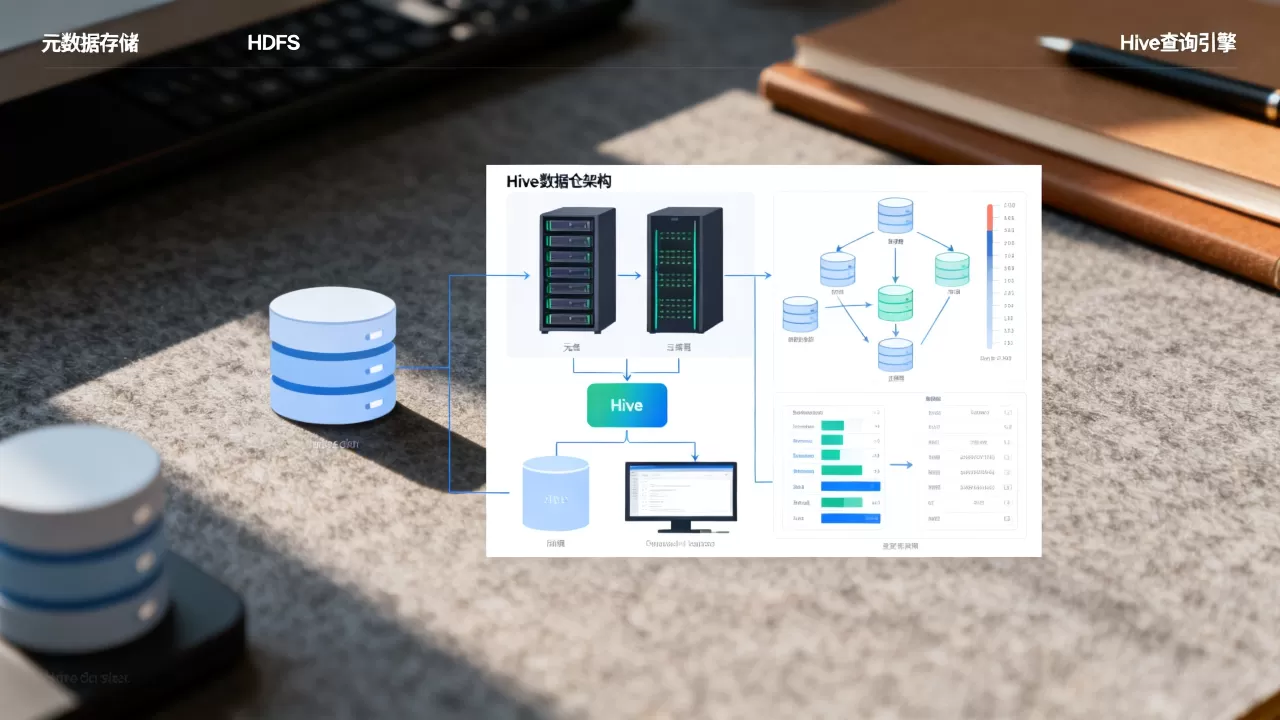
Impala是Cloudera开发的MPP架构SQL查询引擎,它直接在内存中执行查询,无需经过MapReduce或Tez。
- 延迟对比:Impala的查询延迟通常在秒级,而Hive通常在分钟级。
- 适用场景:Impala适合交互式报表和即席查询;Hive适合离线批处理和数据清洗。
Hive vs Spark SQL
Spark SQL是Spark生态系统中的SQL引擎,它同样支持Hive的元数据。
- 性能对比:Spark SQL利用内存计算,性能通常优于Hive on Tez,特别是在迭代计算场景下。
- 生态整合:如果团队已经深度使用Spark,Spark SQL可能是更自然的选择;如果依赖Hadoop生态的其他组件,Hive更为合适。
Q&A:Hive数据仓库架构常见问题
Hive数据仓库架构教程中,如何选择合适的存储格式?
选择存储格式需权衡压缩比、查询速度和兼容性,对于以查询分析为主的OLAP场景,推荐优先使用ORC或Parquet格式,因为它们支持列式存储和谓词下推,能显著减少I/O开销,若需与其他工具(如Pandas、Spark)进行数据交换,Parquet因其广泛的兼容性更具优势,对于仅需存储原始日志且无需频繁查询的场景,TextFile或SequenceFile更为合适。
Hive数据仓库架构教程里,分区和分桶有什么区别?
分区是目录级别的隔离,通过划分目录减少扫描范围,适用于高基数且查询条件明确的字段(如日期),分桶是文件级别的哈希分布,通过哈希值将数据均匀分散到固定数量的文件中,主要用于优化Join操作和抽样查询,分区适合粗粒度过滤,分桶适合细粒度数据分布和加速连接操作。
Hive数据仓库架构教程中,如何解决数据倾斜问题?
数据倾斜通常由Key分布不均或空值过多引起,解决思路包括:开启Map端聚合(hive.map.aggr)以减少Shuffle数据量;对Join键为NULL的数据赋予随机值,避免集中处理;调整Reducer数量,通过参数控制每个Reducer处理的数据量;对于严重倾斜的Key,可将其单独提取出来进行特殊处理,再与主表结果合并。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/472976.html