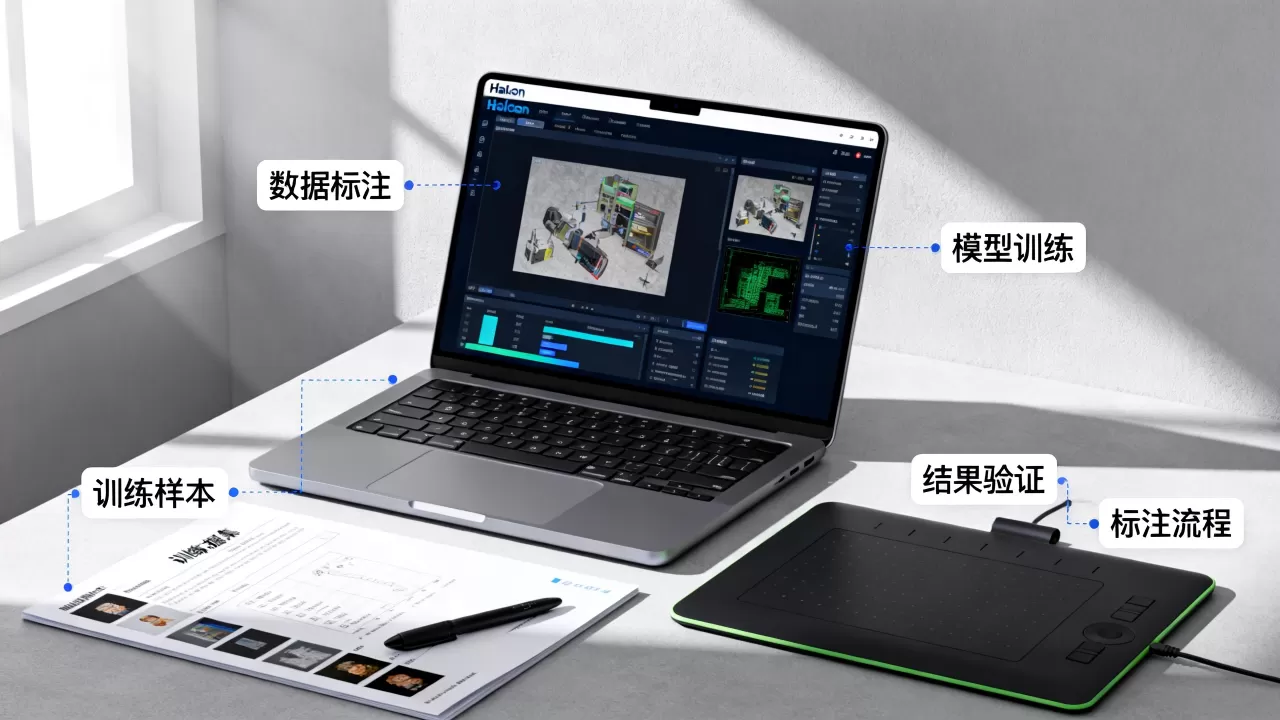
利用Halcon深度学习进行工业检测,核心在于通过标注工具构建高质量训练集,配置合适的网络架构进行训练,最终在应用中加载模型实现高精度缺陷识别。
Halcon作为机器视觉领域的老牌强者,其深度学习模块的引入并非简单的功能叠加,而是对传统算法逻辑的一次重构,很多工程师在初次接触时,往往会被复杂的参数劝退,只要理清数据准备、模型训练、应用部署这条主线,整个过程就像搭积木一样清晰,我们不需要成为AI算法专家,只需要掌握如何正确指挥Halcon去执行任务。
数据准备:决定成败的基石
业内专家指出,深度学习模型的性能上限,完全取决于训练数据的质量,在Halcon的工作流中,数据准备占据了超过一半的时间,这一步做不好,后面所有的努力都是徒劳。
图像采集与标注规范
图像采集需要覆盖各种工况,光照变化、产品位置偏移、背景干扰,这些变量必须在数据集中体现,如果只采集完美状态下的图片,模型上线后遇到稍微复杂的场景就会失效。
标注是另一大难点,Halcon提供了专门的标注工具,支持多种标注类型,对于表面缺陷,通常使用矩形框或轮廓标注;对于分类任务,则使用图像级标签,标注的准确性至关重要,标注框必须紧贴缺陷边缘,不能留有过多空白,也不能遗漏微小瑕疵。
标注工具的操作路径
- 打开Halcon开发环境,创建新的深度学习项目。
- 导入图像文件夹,系统会自动扫描所有图片。
- 选择标注工具,根据任务类型选择“矩形框”、“轮廓”或“点”。
- 在图像上绘制标注区域,输入对应的类别标签。
- 保存标注文件,Halcon会自动生成对应的XML或JSON格式数据。
注意,标注过程中要保持标签的一致性。“划痕”和“裂纹”不能混用,除非它们在业务逻辑中属于同一类缺陷,标签命名要简洁明了,避免使用生僻词。
数据增强策略
为了提升模型的泛化能力,必须进行数据增强,Halcon内置了多种增强算子,可以在训练前自动对图像进行处理。
常见的增强手段包括:
- 随机旋转:模拟产品在不同角度下的外观。
- 亮度调整:模拟不同光照条件下的成像效果。
- 高斯噪声:增加图像的随机性,提高模型抗干扰能力。
- 裁剪与缩放:模拟相机距离变化带来的尺寸差异。
这些操作不需要手动编写代码,只需在训练配置中勾选相应的选项即可,建议开启至少三种增强方式,以覆盖主要的干扰因素。
模型配置与训练:寻找最优解
数据准备好后,进入模型训练阶段,Halcon支持多种深度学习框架,包括TensorFlow、PyTorch等,用户可以根据硬件环境和项目需求进行选择。
网络架构选择
对于大多数工业缺陷检测任务,YOLO系列或SSD系列目标检测网络是首选,它们速度快,精度适中,适合实时检测,如果任务侧重于细微纹理差异,可以考虑使用分割网络,如U-Net。
在选择网络时,需要考虑以下因素:
- 检测速度:生产线节拍要求越高,对速度要求越苛刻。
- 硬件资源:GPU显存大小决定了能加载多大的模型。
- 检测精度:微小缺陷需要更深的网络结构。
超参数设置
训练过程中的超参数设置直接影响模型效果,Halcon提供了默认值,但通常需要根据实际情况进行调整。
- 学习率:初始学习率不宜过大,否则模型难以收敛,建议从0.001开始尝试。
- 批次大小:批次大小越大,梯度估计越准确,但显存占用越高,一般设置为16或32。
- 迭代次数:根据验证集损失曲线确定,当损失曲线趋于平稳时,即可停止训练。
训练监控与调优
训练过程中,需要密切关注损失曲线和验证集准确率,如果训练集损失下降,但验证集损失上升,说明模型过拟合,此时应增加数据增强强度,或引入正则化项,如果两者都未下降,可能是学习率过小,或网络结构不适合当前任务。
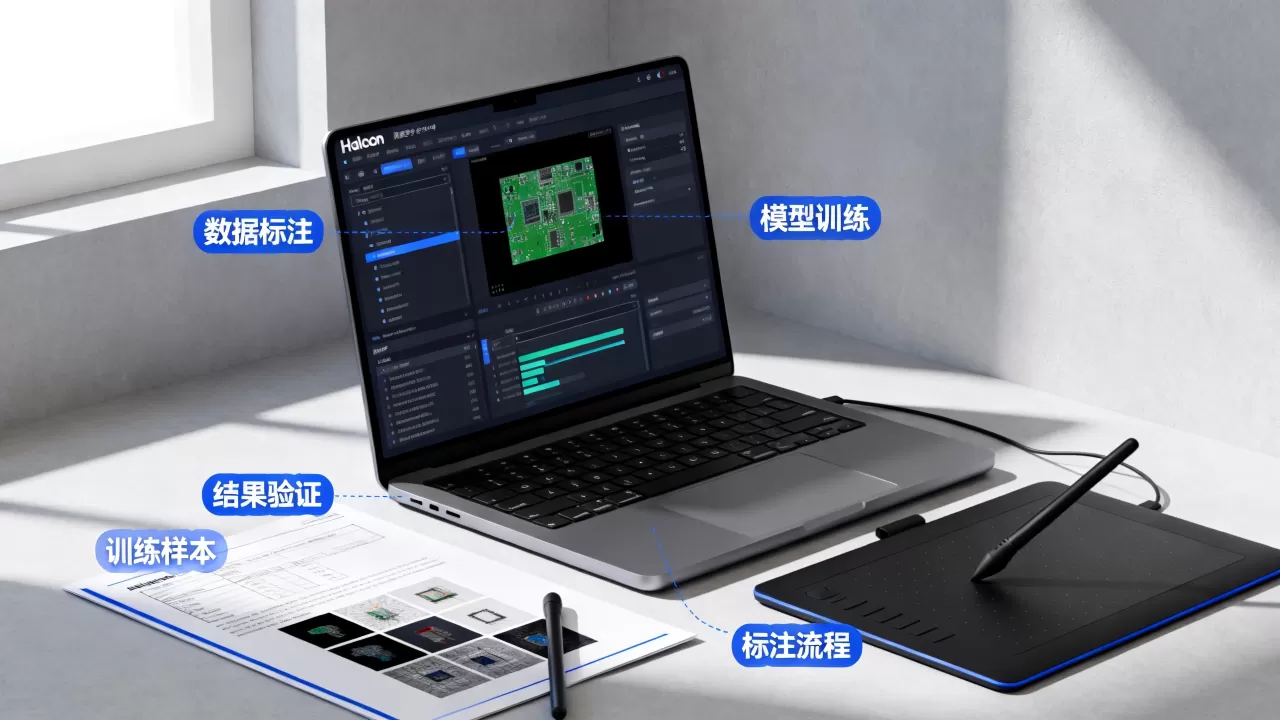
据工信部相关数据显示,近年来工业视觉检测中,深度学习模型的迭代周期已缩短至原来的三分之一,这得益于自动化调优工具的应用,Halcon的自动调优功能可以帮助用户快速找到较优的参数组合,减少人工试错成本。
模型部署与应用:落地最后一公里
训练好的模型需要部署到实际生产环境中,Halcon提供了灵活的部署方案,支持在PC端、嵌入式设备甚至边缘计算盒子中运行。
模型导出与加载
训练完成后,需要将模型导出为Halcon可识别的格式,Halcon支持导出为.hdl文件,该文件包含了网络结构和权重信息。
在应用中加载模型的步骤如下:
- 使用
read_train_net算子读取训练好的网络。 - 使用
set_train_net_param设置推理参数,如置信度阈值、NMS阈值等。 - 使用
apply_train_net算子对输入图像进行推理。
性能优化技巧
在实际应用中,推理速度是关键指标,以下是一些优化建议:
- 模型量化:将浮点数模型转换为整数模型,可显著提升推理速度,且精度损失极小。
- 批量推理:如果硬件支持,可以一次性处理多张图像,提高GPU利用率。
- ROI区域限制:只检测感兴趣区域,减少无效计算。
常见部署场景对比
| 部署平台 | 优势 | 劣势 | 适用场景 |
|---|---|---|---|
| PC端 | 开发调试方便,算力充足 |
成本较高,体积大 | 研发测试,离线分析 |
| 嵌入式GPU | 实时性好,功耗适中 | 开发难度较大 | 在线检测,高速产线 |
| 边缘盒子 | 独立运行,易于集成 | 算力有限 | 分布式检测节点 |
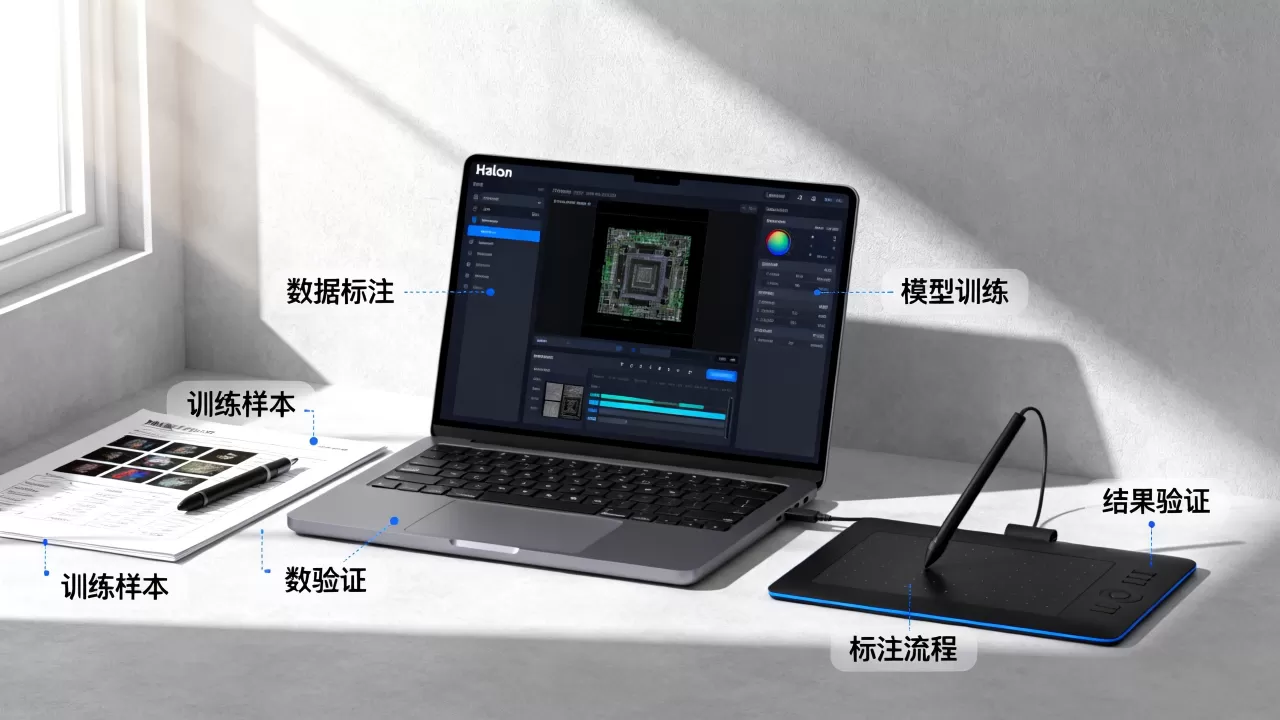
行业共识认为,选择合适的部署平台,比追求极致的模型精度更为重要,一个在实验室中精度99%但速度过慢的模型,在实际产线中可能毫无价值。
常见问题与解答
Halcon深度学习模型训练失败常见原因有哪些?
训练失败通常由数据问题或配置错误引起,首先检查标注数据是否正确,标签是否对应,其次检查图像分辨率是否一致,输入尺寸是否匹配网络要求,确认学习率是否设置合理,批次大小是否超出显存限制,多数情况下,调整学习率和增加数据量即可解决问题。
如何评估Halcon深度学习模型的检测效果?
评估模型效果主要看混淆矩阵、精确率、召回率和mAP(平均精度均值),在Halcon中,可以通过eval_train_net算子获取这些指标,精确率反映检测结果的可靠性,召回率反映漏检情况,在实际应用中,需要根据业务需求平衡两者,安全检测更看重召回率,而分类任务更看重精确率。
Halcon深度学习与其他视觉方案相比有何优势?
相比传统基于规则的视觉算法,Halcon深度学习在处理复杂背景、非刚性形变和微小缺陷时具有显著优势,它不需要人工设计特征,能够自动学习数据中的深层特征,Halcon提供了完整的工具链,从数据标注到模型部署,一站式解决视觉问题,降低了开发门槛,对于追求高精度和高灵活性的工业场景,深度学习已成为主流选择。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/469972.html