Python中的SVMSMOTE通过结合支持向量机与SMOTE算法,能有效解决类别不平衡问题,其核心优势在于仅对“困难样本”进行过采样,从而避免传统SMOTE在噪声区域生成无效数据的问题。
在处理机器学习数据时,我们常遇到“少数派”被淹没在“多数派”海洋里的尴尬局面,传统的过采样方法像是不分青红皂白地复制粘贴,导致模型过拟合;而欠采样又直接丢弃了大量宝贵信息,SVMSMOTE的出现,就像是给数据清洗请了一位经验丰富的老中医,它先通过支持向量机(SVM)找出那些处于决策边界附近、最难分类的“困难样本”,再针对这些特定样本生成新的合成数据,这种做法不仅保留了数据的分布特征,还显著提升了分类器的鲁棒性。

为什么选择SVMSMOTE而非传统SMOTE?
业内专家指出,在处理高维稀疏数据时,传统SMOTE算法往往会产生大量重叠甚至噪声化的合成样本,SVMSMOTE通过引入SVM的边界概念,精准定位那些靠近决策边界的少数类样本,只对它们进行插值生成,这种“精准打击”的策略,使得生成的样本更具代表性,避免了在多数类密集区域盲目生成数据导致的决策边界模糊。
算法原理深度拆解
SVMSMOTE的工作流程可以概括为“筛选-生成-融合”三个步骤,每一步都至关重要:
第一步:SVM边界识别
算法首先使用支持向量机对原始数据集进行训练,SVM会计算出每个样本的支持向量权重,或者通过计算样本到最近邻多数类样本的距离,来识别哪些少数类样本位于“危险区”,这些样本通常靠近决策边界,分类器对它们的判断最不确定。
第二步:困难样本筛选
并非所有少数类样本都需要过采样,SVMSMOTE利用SVM的结果,筛选出那些被判定为“困难”或“噪声”的少数类样本,这一步是算法的核心创新点,它确保了后续生成的合成数据只集中在需要加强学习的区域。
第三步:SMOTE插值生成
针对筛选出的困难样本,算法执行标准的SMOTE操作,即对于每个困难样本,随机选择一个其K近邻中的少数类样本,并在两者之间的连线上随机选取一点作为新的合成样本,由于样本是经过筛选的,这些新数据能更有效地扩充少数类的决策边界。
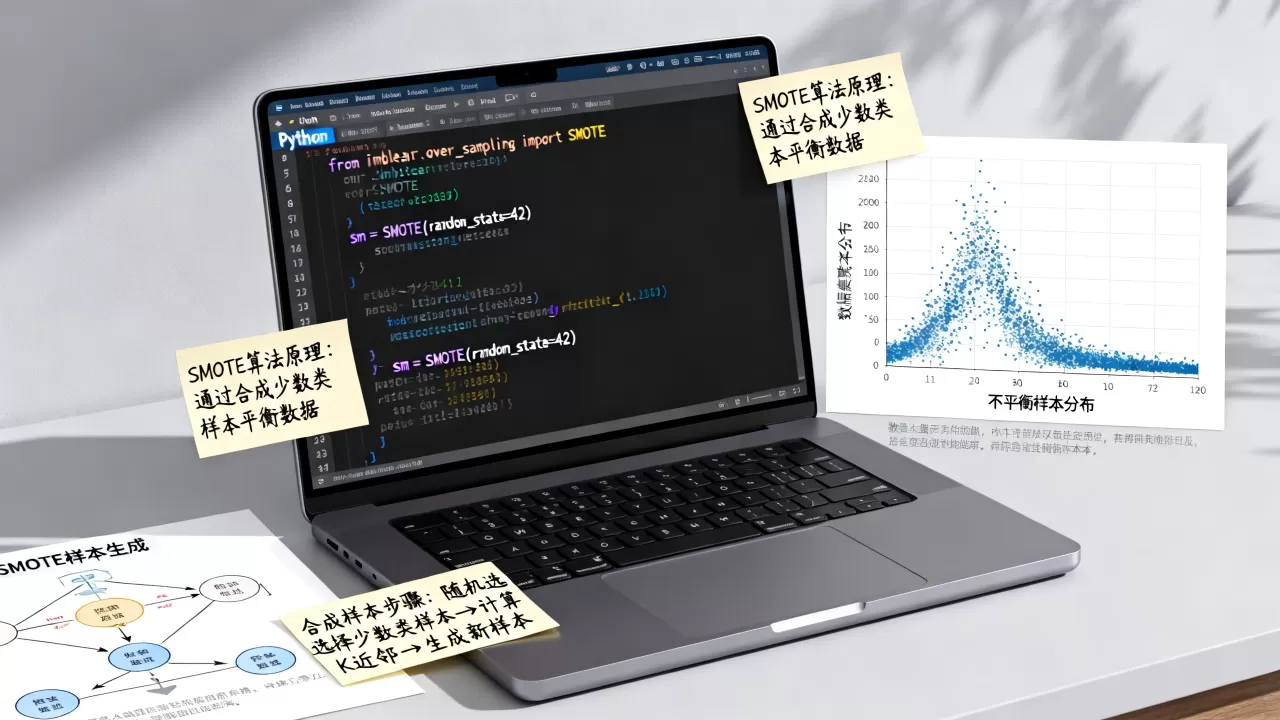
Python实战:SVMSMOTE代码实现指南
对于开发者而言,理解原理只是第一步,如何在Python环境中高效落地才是关键。imbalanced-learn库(简称imblearn)是处理此类任务的主流工具,它提供了便捷的API接口。
环境配置与依赖安装
在开始编码前,确保你的Python环境已安装必要的库,推荐使用conda或pip进行安装,命令如下:
pip install imbalanced-learn scikit-learn pandas numpy
核心代码示例
以下是一个标准的SVMSMOTE应用流程,展示了如何加载数据、应用算法并评估效果:
import numpy as np
import pandas as pd
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split
from sklearn.svm import SVC
from sklearn.metrics import classification_report
from imblearn.over_sampling import SVMSMOTE
from imblearn.pipeline import Pipeline
# 1. 生成不平衡数据集示例
X, y = make_classification(n_samples=5000, n_features=20,
                           n_informative=2, n_redundant=10,
                           weights=[0.95, 0.05], random_state=42)
# 2. 划分训练集和测试集
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# 3. 构建包含SVMSMOTE的Pipeline
# 注意:SVMSMOTE需要指定svm_estimator参数,通常使用线性核函数效率更高
pipeline = Pipeline([
    ('smote', SVMSMOTE(svm_estimator=SVC(kernel='linear'), random_state=42)),
    ('clf', SVC(kernel='rbf'))
])
# 4. 训练模型
pipeline.fit(X_train, y_train)
# 5. 预测与评估
y_pred = pipeline.predict(X_test)
print(classification_report(y_test, y_pred))
关键参数调优建议
在使用SVMSMOTE时,有几个参数直接影响最终效果,需根据具体场景调整:
- svm_estimator:默认使用SVC,但为了计算速度,通常建议使用
SVC(kernel='linear')或LinearSVC,SVM的训练复杂度随样本量增加而急剧上升,线性核函数能大幅降低计算开销。 - k_neighbors:默认值为5,在特征维度较高时,可适当减少该值,以避免引入过多噪声;在数据分布较紧凑时,可适当增加。
- sampling_strategy:控制过采样的目标比例,默认情况下,它会尝试平衡类别比例,但在某些业务场景下,可能不需要完全平衡,只需提升少数类的召回率即可。
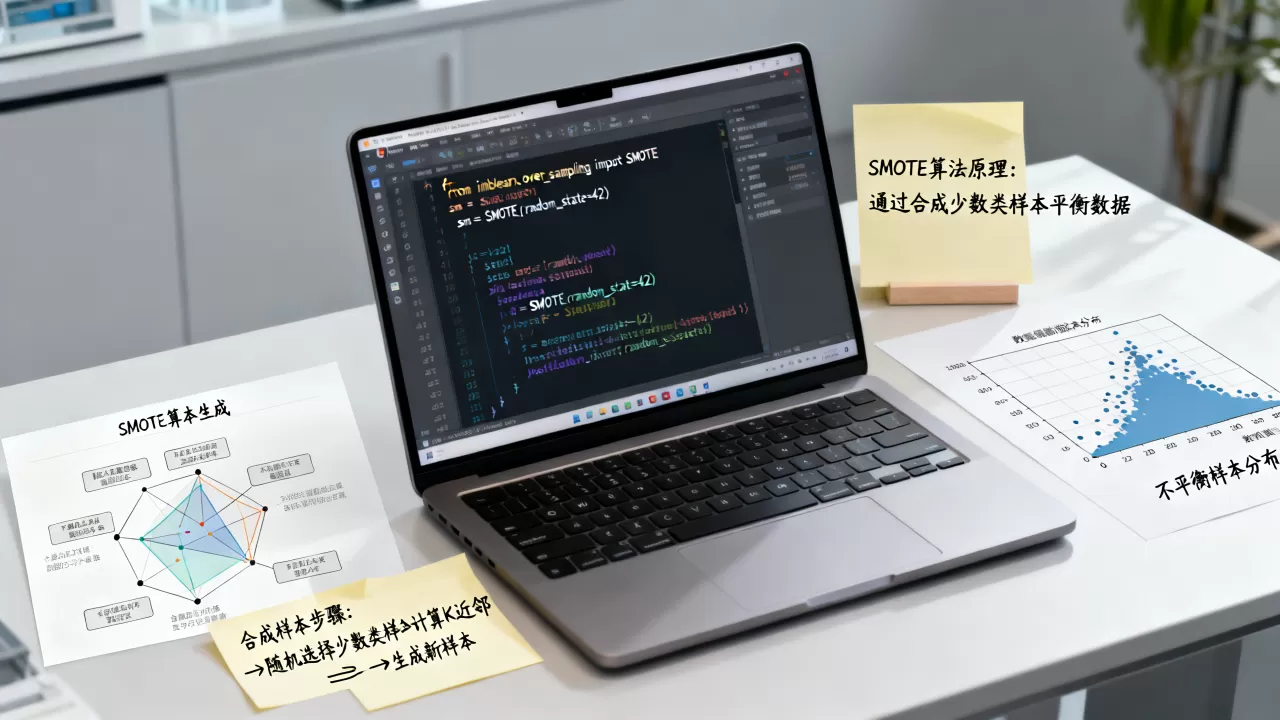
应用场景与性能对比分析
SVMSMOTE并非万能药,它在特定场景下表现优异,而在其他场景下可能不如其他算法,了解其适用边界,能帮助开发者做出更明智的技术选型。
适用场景
- 金融风控:在欺诈检测中,欺诈样本极少且特征复杂,SVMSMOTE能精准定位那些看似正常但实际异常的样本,生成具有代表性的合成数据,提升模型对新型欺诈的识别能力。
- 医疗诊断:罕见病样本稀缺,且误诊成本极高,SVMSMOTE通过增强少数类边界,有助于提高模型对罕见病的敏感度,减少漏诊。
- 工业缺陷检测:在生产线中,合格品占绝大多数,缺陷品极少,SVMSMOTE能有效扩充缺陷样本,帮助模型学习到更细微的缺陷特征。
与传统方法的对比
为了更直观地展示SVMSMOTE的优势,我们将其与RandomOverSampler(随机过采样)和传统SMOTE进行对比:
| 特性 | RandomOverSampler | 传统SMOTE | SVMSMOTE |
|---|---|---|---|
| 生成策略 | 直接复制少数类样本 | 在所有少数类样本间插值 | 仅在困难样本间插值 |
| 噪声敏感度 | 高,易放大噪声 | 中,可能在噪声区生成数据 |
低,通过SVM过滤噪声 |
| 计算复杂度 | 极低 | 中等 | 较高,需训练SVM模型 |
| 决策边界优化 | 差,易导致过拟合 | 一般,边界可能模糊 | 优,精准强化边界 |
| 适用数据规模 | 任意规模 | 中小规模 | 中小规模(大数据集需采样) |
常见问题解答(Q&A)
SVMSMOTE在大数据集上运行太慢怎么办?
SVMSMOTE的计算瓶颈在于SVM模型的训练,当数据量达到十万级以上时,建议采取以下措施:对数据进行随机采样,提取一个具有代表性的子集用于训练SVM模型;使用线性核函数(kernel='linear')代替径向基核函数(kernel='rbf'),因为线性SVM的训练速度远快于非线性SVM;考虑使用NearMiss或ADASYN等替代算法,它们在计算效率上通常更高。
SVMSMOTE生成的样本是否会影响模型的可解释性?
SVMSMOTE生成的合成样本本质上是原始特征的线性组合,因此不会改变特征本身的物理意义,由于引入了合成数据,模型可能会学习到一些在原始数据中不存在的“伪特征”,为了保持可解释性,建议在应用SVMSMOTE后,使用SHAP或LIME等工具对模型进行事后解释,重点关注原始特征对预测结果的贡献度,而非合成样本的具体数值。
SVMSMOTE的价格是多少?
SVMSMOTE是imbalanced-learn库的一部分,而该库是基于BSD许可证开源的Python库,SVMSMOTE本身完全免费,无需支付任何授权费用,开发者只需承担服务器计算资源成本即可,对于企业用户,若需要商业支持或定制化服务,可联系相关技术供应商获取报价,但核心算法本身无隐性收费。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/468962.html