

Hive本质上是构建在HDFS之上的数据仓库工具,它利用HDFS提供的高容错性和高吞吐量存储底层数据,并通过MapReduce、Tez或Spark等计算引擎实现结构化查询,二者是“存储底座”与“查询接口”的协同关系。
在大数据生态系统中,HDFS和Hive常常被新手混淆,很多人以为Hive就是数据库,或者HDFS只是普通的文件存储,HDFS是地基,负责把海量数据稳稳地存下来;Hive则是地上的大楼,负责让你能用熟悉的SQL语言去管理和分析这些数据,理解它们的分工,是构建高效数据仓库的第一步。
HDFS:大数据的坚实底座
HDFS(Hadoop Distributed File System)是Hadoop生态的存储核心,它的设计初衷就是为了处理PB级别的数据,强调高吞吐量和容错性,而不是低延迟。
核心架构与存储机制
HDFS采用主从架构,由NameNode和DataNode组成,NameNode是“大脑”,管理文件系统的元数据,比如文件名、权限、目录结构等;DataNode是“手脚”,负责实际存储数据块。
- 分块存储:HDFS将大文件切分成固定大小的块(默认128MB或256MB),分散存储在集群的不同节点上,这种设计让并行读取成为可能。
- 副本机制:为了保证数据不丢失,每个数据块默认会有3个副本,副本分布在不同的机架或节点上,即使某个节点宕机,数据依然可用。
适用场景与局限性
HDFS适合“一次写入,多次读取”的场景,它不支持随机修改,也不适合小文件存储。
- 优势:极高的容错能力,硬件故障不影响整体服务;扩展性强,可以轻松增加节点提升存储容量。
- 劣势:延迟较高,不适合需要毫秒级响应的在线事务处理(OLTP);小文件过多会导致NameNode内存压力巨大,因为每个小文件都占用元数据空间。
业内专家指出,对于日志收集、离线数据分析等场景,HDFS是无可替代的存储方案,但如果你需要频繁更新数据或处理大量小文件,直接操作HDFS会非常痛苦。
Hive:让SQL触达HDFS
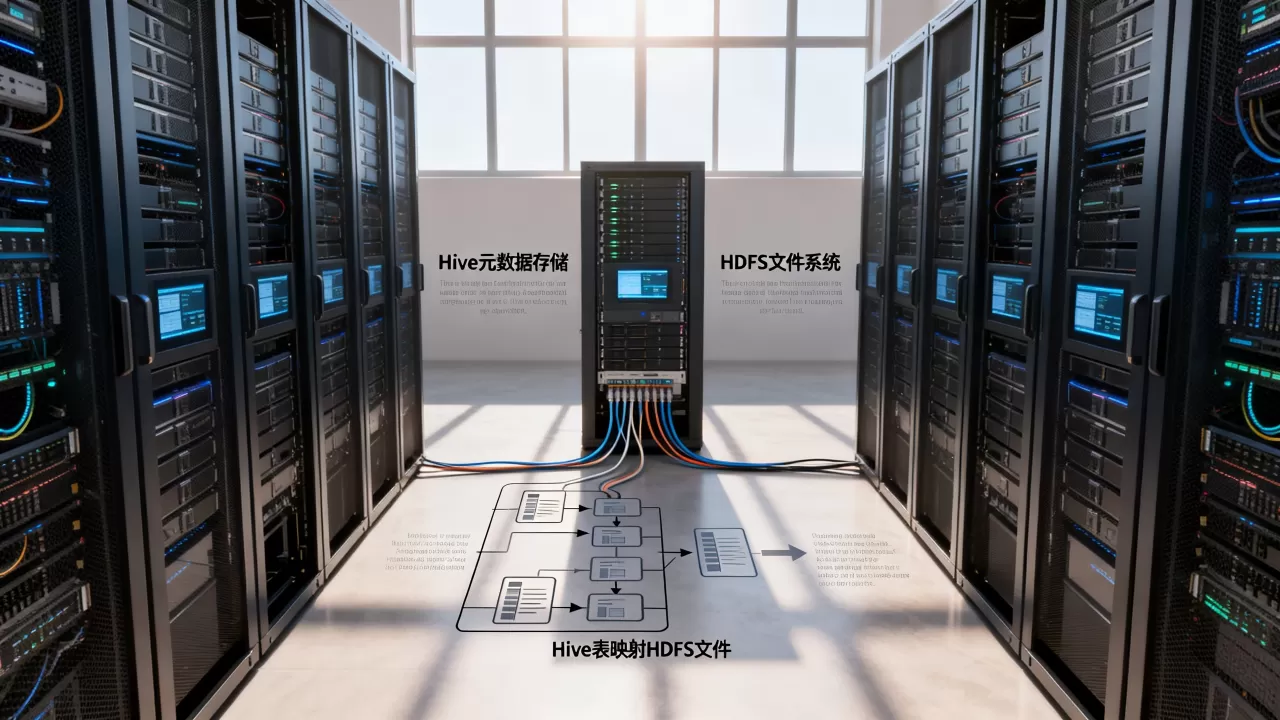
Hive是由Facebook开源,现由Apache基金会维护的数据仓库工具,它的核心价值在于将结构化的数据文件映射为一张数据库表,并提供完整的SQL查询功能。
元数据与数据分离
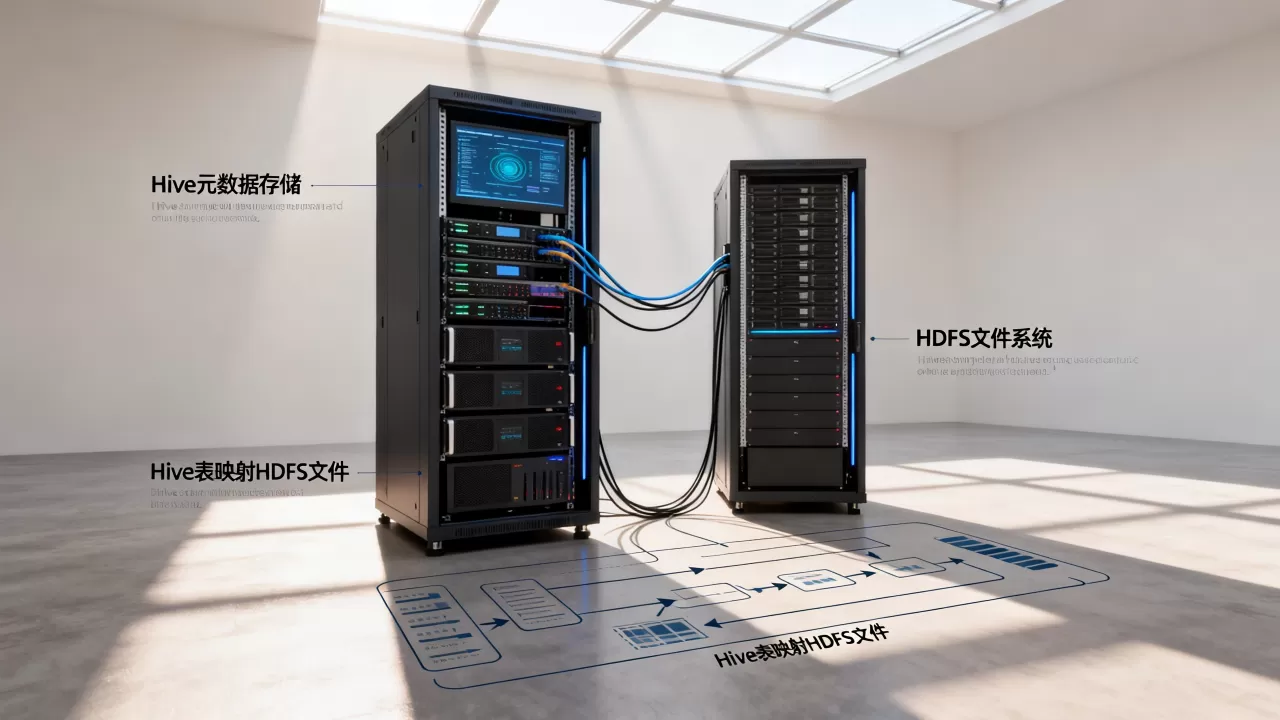
Hive本身不存储数据,它只存储元数据(Metadata),元数据包括表名、列信息、分区信息、存储格式等,通常存储在关系型数据库(如MySQL)中。
- 数据位置:实际数据依然存放在HDFS上。
- 映射关系:当你执行
CREATE TABLE时,Hive只是在元数据中记录了一张表的信息,并指向HDFS上的某个目录。
计算引擎的演进
早期的Hive使用MapReduce作为计算引擎,速度慢但兼容性好,随着技术发展,Hive逐渐支持更高效的引擎。
- Tez:将MapReduce的DAG(有向无环图)任务优化为更细粒度的执行计划,适合交互式查询。
- Spark:基于内存计算,速度极快,适合复杂的数据清洗和ETL任务。
- LLAP:Live Long and Process,提供低延迟的交互式查询能力,适合即席查询场景。
Hive与HDFS的深度协同
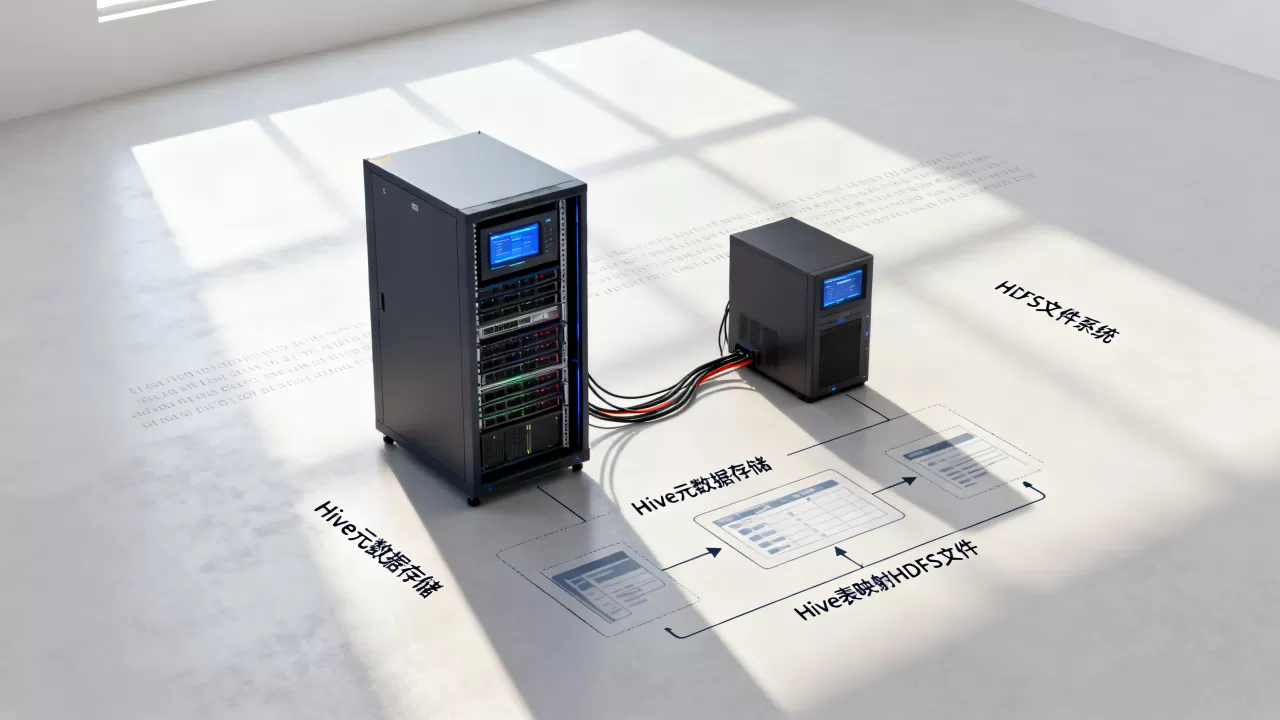
理解Hive如何调用HDFS,是优化查询性能的关键,二者并非独立存在,而是紧密耦合。
数据流转过程
当你在Hive中执行一条SQL查询时,背后发生了什么?
- 解析:Hive编译器将SQL语句解析成语法树,检查元数据中的表结构。
- 优化:优化器对执行计划进行优化,比如谓词下推、列裁剪等。
- 生成任务:将优化后的计划转换为底层计算引擎(如Tez或Spark)的任务DAG。
- 执行读取:计算引擎从HDFS读取数据块,HDFS负责提供数据块的位置信息和容错读取。
- 结果返回:计算完成后,结果可能写回HDFS(如果是INSERT操作),或直接返回给客户端。
存储格式的影响
Hive支持多种存储格式,直接影响了HDFS的读取效率。
- TextFile:默认格式,压缩率低,解析成本高,不推荐用于生产环境。
- SequenceFile:二进制格式,支持压缩,适合大规模数据写入。
- ORC/Parquet:列式存储格式,支持压缩和索引,查询时只需读取相关列,极大减少I/O开销。
据统计,使用ORC或Parquet格式相比TextFile,查询性能可提升数倍,同时节省大量HDFS存储空间。
分区与分桶策略
为了进一步加速查询,Hive引入了分区和分桶概念,这直接影响HDFS上的目录结构。
- 分区:将数据按某个字段(如日期、地区)划分到不同的目录,查询时,Hive会跳过无关目录,实现“分区裁剪”。
- 分桶:对数据按某个字段哈希取模,分散到不同文件中,适合Join操作和抽样查询。
常见误区与最佳实践
在实际应用中,很多团队因为对Hive和HDFS理解不足,导致集群性能瓶颈。
避免小文件问题
HDFS最怕小文件,Hive的INSERT操作如果频繁触发,会产生大量小文件,拖慢NameNode。
- 解决方案:使用
INSERT OVERWRITE DIRECTORY配合合并工具,或在Hive中设置hive.merge.mapfiles和hive.merge.tezfiles参数,在任务结束时合并小文件。
合理选择存储格式
不要为了省事使用默认的TextFile,对于分析型数据仓库,强烈建议使用ORC或Parquet,并开启Snappy压缩。
- 对比:ORC适合写多读少、需要复杂过滤的场景;Parquet适合读多写少、兼容Spark生态的场景。
元数据维护
Hive的元数据是查询的导航图,如果元数据与实际数据不一致,会导致查询错误。
- 操作建议:定期执行
MSCK REPAIR TABLE修复分区信息;使用ANALYZE TABLE收集统计信息,帮助优化器生成更好的执行计划。
Q&A:Hive存储和hdfs常见疑问
Hive可以直接操作HDFS文件吗?
Hive不能直接像Linux命令那样操作HDFS文件,但可以通过HiveQL间接管理,使用LOAD DATA INPATH 'hdfs://...'将HDFS文件加载到Hive表中,或者使用INSERT OVERWRITE DIRECTORY将Hive查询结果导出到HDFS指定目录,Hive支持外部表,外部表的元数据与数据分离,删除表不会删除HDFS上的数据,便于灵活管理。
Hive和HDFS的价格成本如何考量?
HDFS本身是开源软件,软件授权费用为零,但硬件成本取决于集群规模,Hive也是开源的,但企业级应用可能需要购买商业支持或云服务的托管费用,在成本考量上,HDFS的存储成本相对较低,尤其是使用廉价硬件时;而Hive的计算成本取决于使用的引擎和集群资源调度,对于中小企业,使用云厂商的托管Hive服务(如简米云MaxCompute、AWS EMR)可以降低运维成本,按量付费模式适合波动性大的业务。
地域性数据合规对Hive存储有什么影响?
在不同国家和地区,数据主权法规(如欧盟GDPR、中国数据安全法)要求数据存储在特定地域,这意味着HDFS集群必须部署在合规的数据中心,Hive的元数据库和实际数据文件都需遵循地域限制,跨国企业通常采用多区域部署策略,每个区域独立运行Hive和HDFS集群,通过数据同步工具进行跨区备份,确保既满足合规要求,又实现数据可用性。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/467513.html




评论列表(1条)
太真实了,天天跟Hive打交道。底层都是HDFS上的Parquet文件,别整那些虚的。