Embedding Python 的核心在于利用预训练模型将非结构化文本转化为高维向量,从而实现语义搜索、推荐系统及大模型知识库构建,其关键在于选择合适的 Embedding 模型并优化向量化流程。
在人工智能应用落地的今天,数据不再是冰冷的字符,而是可以被机器理解的“意义”,当你问“怎么做 Embedding Python”时,你实际上是在寻找一种让计算机读懂人类语言的技术桥梁,这项技术不仅是大语言模型(LLM)的基石,更是企业构建私有知识库、实现智能客服和精准推荐系统的核心组件。

Embedding Python 基础原理与核心概念
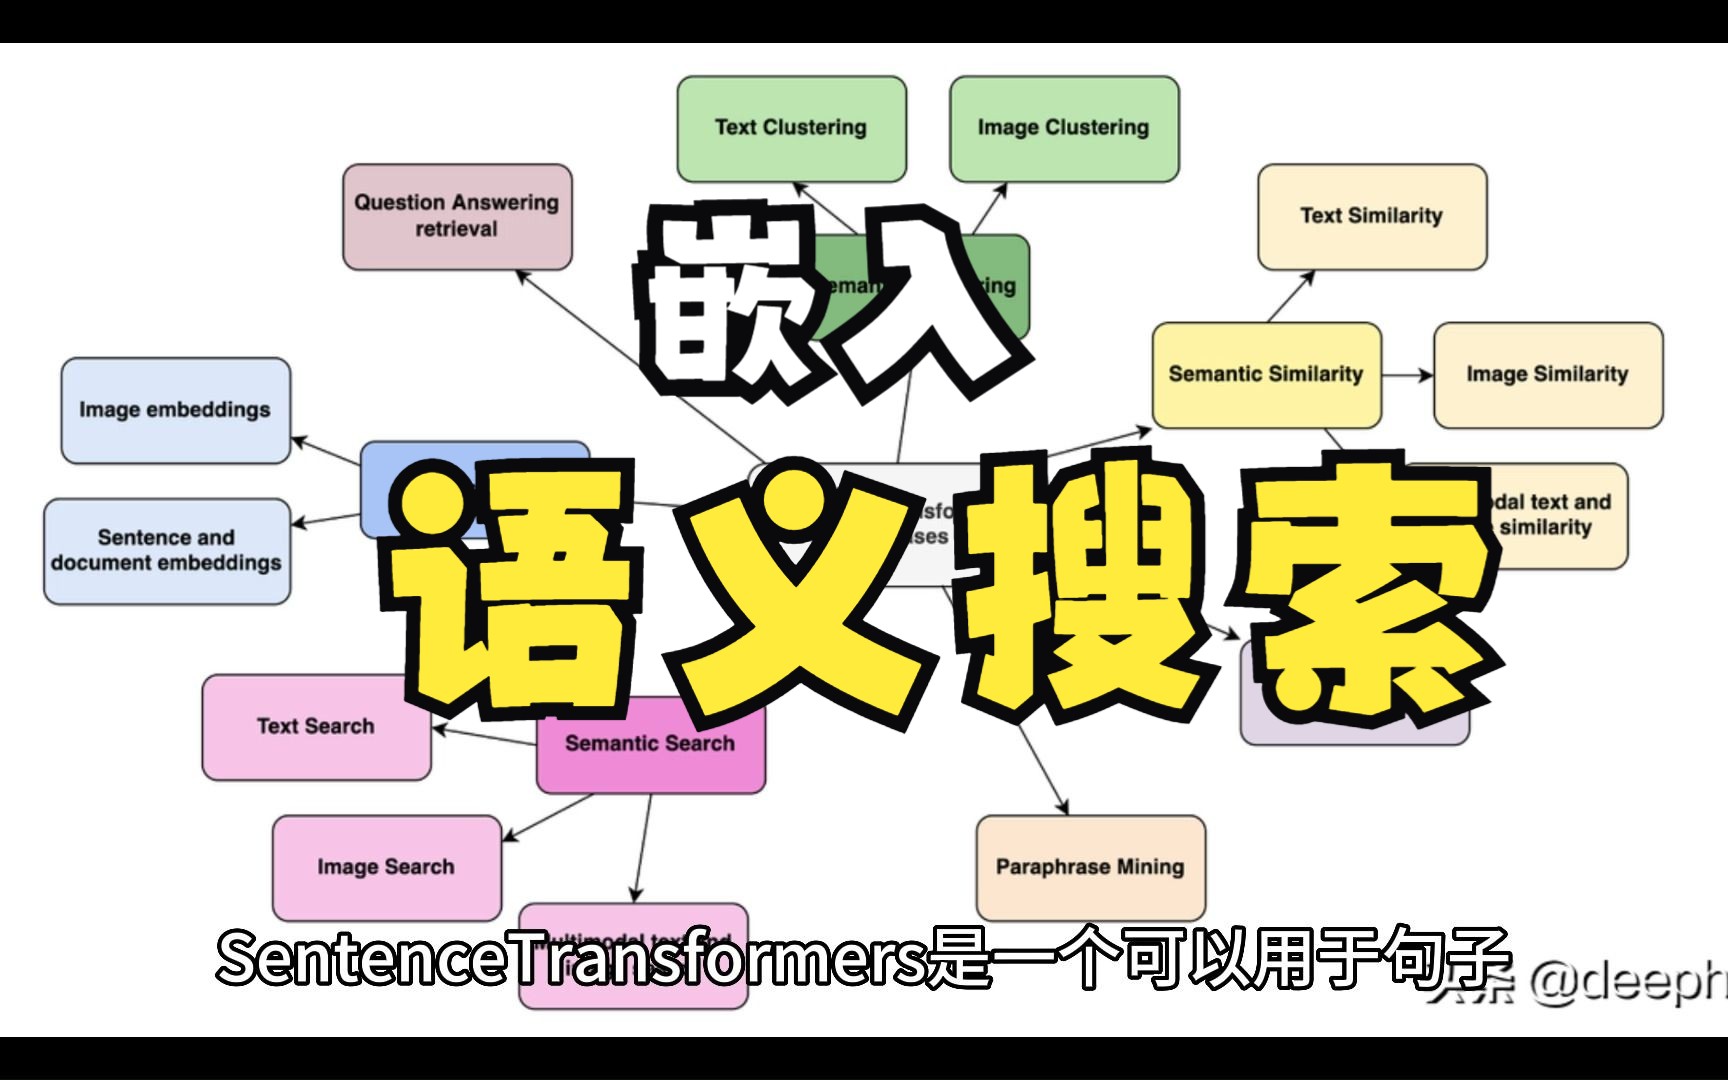
理解 Embedding 是高效使用 Python 库的前提,Embedding 就是把单词、句子甚至整篇文章映射到一个多维空间中的点,在这个空间里,语义相近的词距离更近,语义相远的词距离更远。
为什么需要向量化?
传统的关键词匹配只能找到完全相同的字,却无法理解“苹果”在水果和手机两个语境下的不同含义,通过 Embedding,计算机能捕捉到这种语义关联。
- 语义理解:模型能识别“开心”和“快乐”的相似性。
- 降维压缩:将高稀疏的文本数据转化为低稠密的连续向量,节省存储和计算资源。
- 通用性:同一套向量空间可以服务于搜索、分类、聚类等多种任务。
主流 Embedding 模型对比
选择模型是项目成功的关键,目前业内主流的选择包括 OpenAI 的 text-embedding 系列、Hugging Face 上的开源模型(如 BGE、M3)以及本地部署的 Sentence-BERT。
| 模型类型 | 代表产品 | 优势 | 劣势 |
|---|---|---|---|
| 云端 API | OpenAI Ada | 精度高,无需维护基础设施 | 数据隐私风险,长期成本高 |
| 开源本地 | BGE-M3 | 数据可控,支持多语言,免费 | 需要 GPU 资源,需自行部署 |
| 轻量级 | Sentence-Transformers | 部署简单,CPU 友好 | 精度略低于大型模型 |
业内专家指出,对于大多数中小企业而言,平衡成本与效果的最佳方案是使用开源模型进行本地部署,既保证了数据不出域,又避免了高昂的 API 调用费用。
Python 实现 Embedding 的实操步骤
在实际开发中,使用 Python 生成 Embedding 并不复杂,以下以目前社区最流行的 sentence-transformers 库为例,展示从环境配置到代码实现的全过程。
环境配置与依赖安装
确保你的 Python 环境版本在 3.8 以上,推荐使用虚拟环境隔离依赖。
- 创建虚拟环境:`python -m venv venv`
- 激活环境:`source venv/bin/activate`(Linux/Mac)或 `venvScriptsactivate`(Windows)
- 安装核心库:`pip install sentence-transformers torch`
基础代码实现
这段代码展示了如何加载模型并将文本转换为向量。
from sentence_transformers import SentenceTransformer
# 加载预训练模型,推荐使用中文优化过的模型
model = SentenceTransformer('shibing624/text2vec-base-chinese')
# 输入文本列表
sentences = [
    "人工智能正在改变世界",
    "AI技术如何影响未来就业",
    "Python编程入门指南"
]
# 生成 Embedding 向量
embeddings = model.encode(sentences)
# 输出向量形状,(3, 768) 表示3条文本,每条768维
print(embeddings.shape)
批量处理与性能优化
当面对海量数据时,逐条处理效率极低,利用 model.encode 的批量处理能力可以显著提升速度。
- 设置 Batch Size:根据 GPU 显存大小调整 batch_size,32 或 64 是较好的起点。
- 使用 Device:明确指定 `device=’cuda’` 以利用 GPU 加速,若只有 CPU 则设为 `’cpu’`。
- 归一化处理:在计算相似度前,对向量进行 L2 归一化,确保余弦相似度计算准确。
Embedding Python 在搜索与知识库中的应用
生成向量只是第一步,如何存储和检索这些向量才是决定应用效果的关键。
向量数据库的选择
传统的 MySQL 或 PostgreSQL 并不擅长处理高维向量搜索,你需要引入专门的向量数据库或插件。
- Pinecone / Milvus:专为大规模向量搜索设计,支持分布式扩展,适合生产环境。
- FAISS:Facebook 开源的库,速度极快,适合内存中快速检索,但持久化需额外处理。
- PostgreSQL + pgvector:如果你希望保持技术栈统一,这是一个性价比极高的选择。
构建 RAG 系统的核心环节
检索增强生成(RAG)是当前最热门的应用场景,其流程包括:文档切片 -> Embedding 向量化 -> 存入向量库 -> 用户提问 -> 向量检索 -> 拼接上下文 -> 发送给 LLM。
文档切片策略
切分文本的质量直接影响检索效果。
- 固定长度切分:简单粗暴,但可能切断句子语义。
- 语义切分:利用模型识别段落边界,保持语义完整性。
- 重叠窗口:相邻切片保留一定重叠字符,防止关键信息在边界丢失。
常见问题与避坑指南
在实际落地过程中,开发者经常遇到一些典型问题。
Embedding Python 模型选型困惑
很多开发者纠结于“哪个模型最好”,没有绝对的最好,只有最适合。
- 中文场景:优先选择经过中文语料微调的模型,如 BGE 系列或 text2vec。
- 英文场景:OpenAI 的 text-embedding-3-small 依然是基准线,但开源的 E5 系列也在快速追赶。
- 多语言场景:需要支持多语言的模型,如 m3 或 LaBSE。
据统计,多数情况下,使用经过领域数据微调的模型,其检索准确率比通用模型高出较大比例。
向量维度与存储成本
高维度向量虽然精度高,但占用存储空间大,检索速度慢。
- 降维技术
:可以使用 PCA 等技术对向量进行降维,牺牲少量精度换取效率。
- 量化压缩:将浮点数向量量化为 8 位整数,可节省 75% 的存储空间。
Embedding Python 未来趋势展望
随着大模型技术的发展,Embedding 技术也在不断演进。
- 多模态 Embedding:未来的 Embedding 将不仅限于文本,还将涵盖图像、音频和视频,实现跨模态的统一语义空间。
- 动态 Embedding:根据上下文动态调整向量表示,而非静态的固定向量。
- 端侧部署:随着模型轻量化,Embedding 将在手机端和 IoT 设备上直接运行,提升实时性和隐私性。
行业共识认为,掌握 Embedding 技术是进入 AI 应用开发领域的必修课,它不仅是连接数据与智能的桥梁,更是构建下一代智能应用的基础设施。
Embedding Python 常见问题解答
Embedding Python 实现本地部署需要多少显存?
显存需求取决于模型大小和 Batch Size,对于 768 维的中等大小模型(如 BGE-base),在 Batch Size 为 32 的情况下,大约需要 2-4GB 显存,若使用更大模型(如 3000+ 维),则需要 8GB 或更高显存,CPU 模式下虽然不需要显存,但推理速度会显著降低,适合对实时性要求不高的场景。
Embedding Python 生成的向量可以直接用于分类任务吗?
可以,但通常需要配合简单的分类器,Embedding 向量本身是高维连续空间,可以直接输入到 SVM、逻辑回归或简单的神经网络中进行分类,这种方式被称为“特征提取+传统机器学习”,在许多小样本场景下,效果优于直接微调大模型,且训练速度更快。
Embedding Python 如何处理长文本超过模型上下文限制?
当文本长度超过模型最大上下文窗口(如 512 或 8192 个 token)时,通常采用分段处理策略,将长文本切分为多个片段,分别生成 Embedding,然后通过加权平均或最大池化(Max Pooling)合并为一个整体向量,另一种方法是使用专门支持长文本的模型,如支持 8192 或 16384 上下文的 BGE 系列,直接编码完整段落。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/466764.html