股票预测机器学习准吗?机器学习预测股票准确率

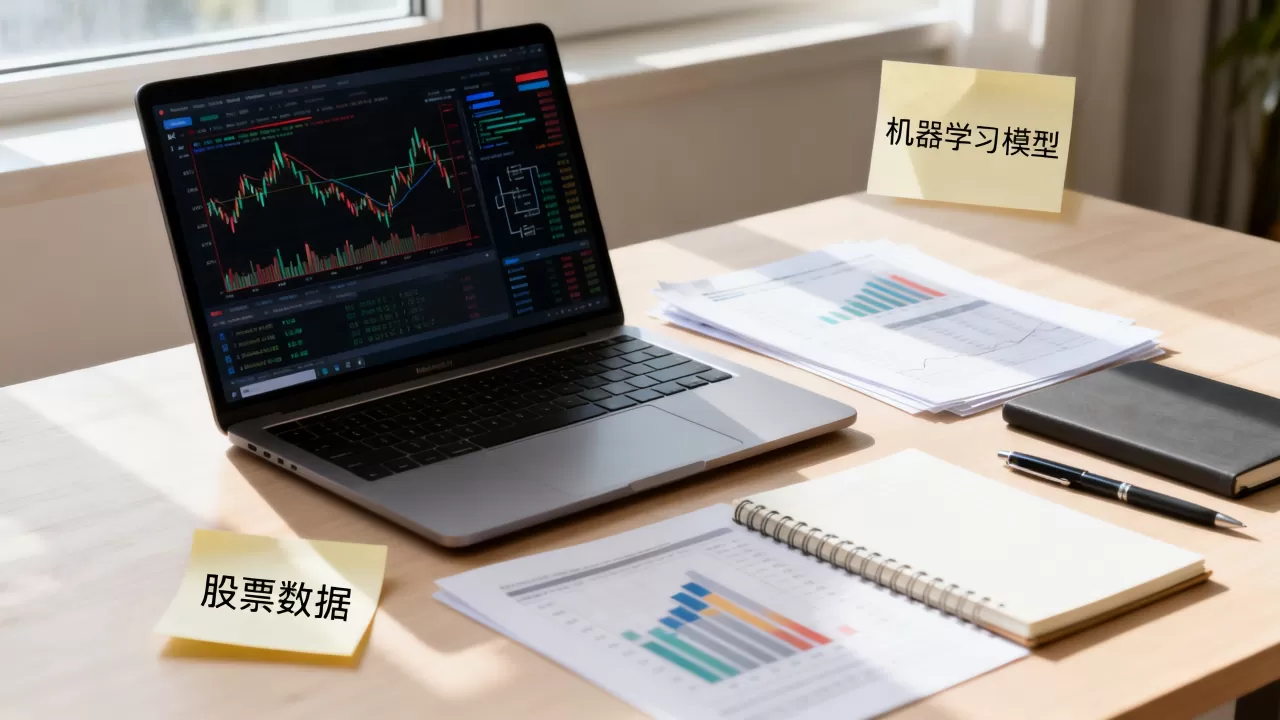
股票预测机器学习并非水晶球,而是通过量化历史数据、识别市场模式来辅助决策的概率工具,其核心价值在于提升交易胜率而非保证绝对盈利。

机器学习在股市预测中的底层逻辑

传统的技术分析依赖人工绘制K线、寻找支撑位,这容易受情绪干扰且效率低下,机器学习模型则能处理海量非结构化数据,从新闻情绪到订单流,寻找人类肉眼难以察觉的微弱信号,业内专家指出,算法交易已成为机构投资者的标配,因为机器不会疲劳,也不会因为恐惧或贪婪而偏离既定策略。
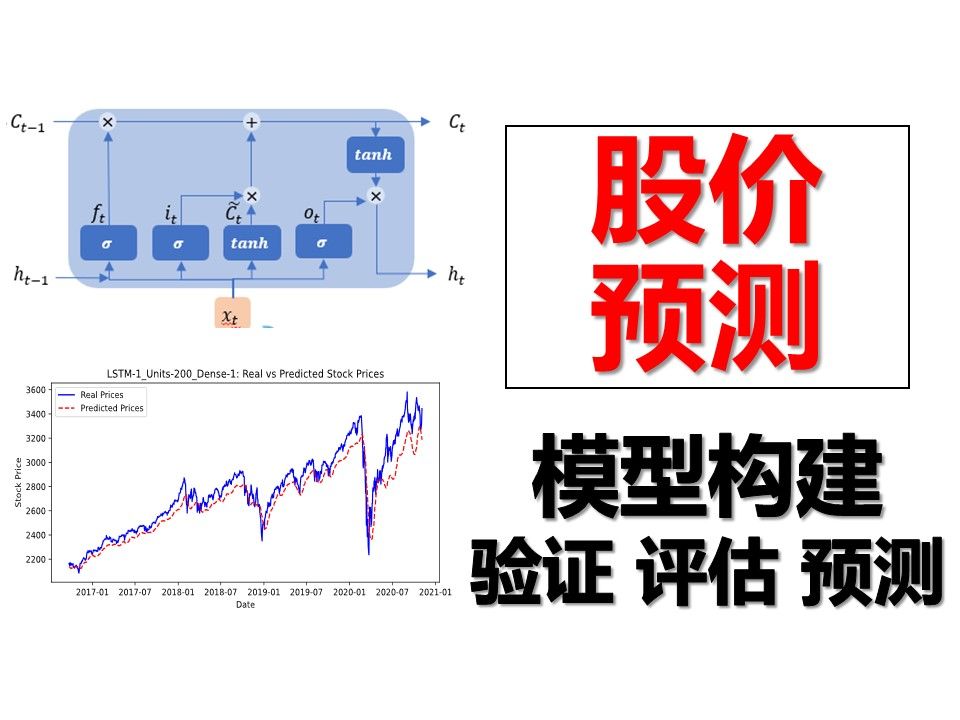
基于LSTM的股价预测python实战教学-模型构建、验证、评估、预测股价_时序预测实战_机器学习
加载中
基于LSTM的股价预测python实战教学-模型构建、验证、评估、预测股价_时序预测实战_机器学习

从线性回归到深度学习的技术演进

早期的量化模型多基于线性回归,假设股价变动与某些因子呈线性关系,金融市场充满非线性特征,简单的线性模型难以捕捉复杂的市场波动,近年来,随着算力提升,深度学习架构成为主流。

常见算法模型对比

不同模型适用于不同场景,选择错误会导致过拟合或欠拟合,以下是几种主流模型的特性分析:

  • LSTM(长短期记忆网络):擅长处理时间序列数据,能记住长期依赖关系,适合预测股价趋势。
  • Transformer:源自自然语言处理,能并行处理数据,捕捉全局特征,在高频交易场景中表现优异。
  • 随机森林:集成学习方法,抗过拟合能力强,适合处理包含大量噪声的基础面数据。

数据清洗:决定模型上限的关键步骤

很多初学者直接拿原始数据训练模型,结果往往惨不忍睹,数据质量直接决定预测精度。

  1. 去噪处理:使用移动平均线或卡尔曼滤波剔除市场噪音。
  2. 缺失值填补:采用前向填充或插值法处理停牌期间的数据空白。
  3. 股票预测机器学习准吗?机器学习预测股票准确率

    特征标准化:将不同量纲的数据(如价格与成交量)归一化到同一区间,避免梯度消失。

据工信部及相关行业报告显示,数据预处理在量化项目中的时间占比通常超过60%,这充分说明了数据质量的重要性。

构建股票预测模型的核心流程

构建一个可用的预测系统并非一蹴而就,需要严谨的工程化思维,以下是实操中的关键路径。

特征工程:挖掘Alpha的来源

特征工程是机器学习的灵魂,单纯的价格数据信息量有限,需要衍生出更多维度的指标。

技术指标类特征

  • 动量指标:RSI、MACD、KDJ等,反映价格变动的速度和强度。
  • 波动率指标:ATR、布林带宽度,衡量市场的不确定性。
  • 成交量特征:OBV、成交量加权平均价(VWAP),反映资金流向。

另类数据类特征

传统财务数据滞后性强,另类数据更具前瞻性。

  • 社交媒体情绪:抓取微博、Twitter上的关键词情感得分。
  • 新闻舆情:利用NLP技术分析财经新闻的正负面倾向。
  • 宏观数据:CPI、PMI、利率决议等宏观经济指标。

模型训练与验证:避免过拟合陷阱

在股票预测中,过拟合是最常见的错误,模型在历史数据上表现完美,实盘却亏损累累。

  • 时间序列交叉验证:不能使用随机K折交叉验证,必须按时间顺序划分训练集和测试集,确保未来数据不会泄露到过去。
  • 滚动窗口验证:使用滚动窗口进行回测,模拟真实交易中的模型更新过程。
  • 正则化手段:引入L1、L2正则化,限制模型复杂度,提高泛化能力。
  • 股票预测机器学习准吗?机器学习预测股票准确率

行业共识认为,夏普比率是评估模型优劣的核心指标,而非单纯的准确率,一个准确率为51%但风险控制得当的模型,可能比准确率80%但回撤巨大的模型更具实战价值。

实战中的挑战与应对策略

尽管机器学习前景广阔,但在实际应用中面临诸多挑战,理解这些难点并制定应对策略,是从小白进阶为专业量化人员的关键。

市场非平稳性与概念漂移

股市规律并非恒定不变,牛市中的强势策略在熊市中可能失效,这种现象称为概念漂移。

  • 动态权重调整:根据近期市场表现,动态调整不同特征的重要性。
  • 在线学习:采用增量学习算法,让模型随着新数据的到来不断自我更新。
  • 多周期融合:结合日线、小时线、分钟线不同周期的信号,降低单一周期失效的风险。

交易成本与滑点的影响

回测结果往往过于理想,忽略了交易摩擦。

  • 手续费扣除:在回测中必须扣除双边手续费,高频交易下这笔费用不容忽视。
  • 滑点模拟:假设每次交易都有1-2个跳价的滑点,更真实地反映成交情况。
  • 流动性约束:对于小盘股,大额订单会导致价格剧烈波动,需限制单笔交易规模。

过拟合的终极解决方案:样本外测试

如何判断模型是否真的有效?

  • 严格划分数据集:将数据分为训练集、验证集和测试集,测试集在整个训练过程中不可见。
  • 模拟盘运行:在实盘前进行至少3-6个月的模拟盘交易,验证模型在不同市场环境下的稳定性。
  • 参数敏感性分析:微调模型参数,观察收益曲线是否发生剧烈变化,若变化剧烈则说明模型不稳定。
  • 股票预测机器学习准吗?机器学习预测股票准确率

未来趋势:多模态与强化学习的融合

随着人工智能技术的发展,股票预测正进入新的阶段。

多模态数据融合

未来的模型将不再局限于数字数据,而是融合文本、图像、音频等多种模态,通过分析CEO在财报电话会议中的语调变化,结合财报数据,综合判断公司前景,这种多模态融合能提供更全面的市场视角。

强化学习的应用

传统监督学习预测价格涨跌,而强化学习直接优化交易策略,智能体(Agent)在模拟环境中不断试错,学习如何在不同市场状态下最大化收益,这种方式更接近真实交易逻辑,能够自动学习仓位管理和止损策略。

据多家头部券商研报显示,强化学习在资产配置和算法执行领域的应用正在快速增长,预计未来五年将成为量化投资的主流方向之一。

常见问题解答(股票预测机器学习)

机器学习能100%预测股票涨跌吗?

不能,金融市场受政策、情绪、黑天鹅事件等多重因素影响,具有高度随机性,机器学习只能提高预测的概率优势,无法消除不确定性,任何声称能100%预测的说法都是误导。

初学者应该从哪个模型开始学习?

建议从线性回归或逻辑回归入手,理解基本特征与标签的关系,随后过渡到随机森林或XGBoost,这类模型对数据预处理要求较低,且效果稳定,掌握基础后再深入LSTM或Transformer等复杂深度学习模型。

回测盈利实盘就亏,主要原因是什么?

主要原因包括过拟合、忽略交易成本、滑点未模拟以及市场风格切换,实盘中的人性弱点如恐惧和贪婪也会导致执行偏差,解决之道在于简化模型、严格回测纪律以及引入自动化交易系统。

首发原创文章,作者:王坚‌,如若转载,请注明出处:https://test.idctop.com/article/466207.html

赞 (0)
linux自动交互怎么设置?shell脚本实现自动输入密码
上一篇 2026年7月7日 07:54
备案增加域名怎么操作?ICP备案新增域名流程
下一篇 2026年7月7日 07:57

相关推荐

  • 服务器有几家知名品牌?国内服务器租用哪家好?

    要准确回答服务器有几家这个问题,不能仅凭一个简单的数字,因为服务器市场涵盖了云服务商、IDC托管商、硬件制造商等多个维度,全球范围内,市场呈现“寡头垄断与长尾共存”的格局,头部厂商占据主要份额,而中小型服务商则提供差异化服务,对于企业用户而言,理解这一市场格局的分层结构,比单纯追求数量更有助于做出正确的采购决策……

    2026年2月23日
    16500
  • 如何科学地预测服务器容量以避免资源浪费,有哪些常见的方法和工具

    服务器容量预测的核心,是根据历史负载、业务增长曲线和关键性能指标,提前估算未来资源需求,从而在性能和成本之间找到最佳平衡点,服务器容量预测方法对比:统计模型与AI方案评估在选择容量预测方法时,团队经常在传统统计模型和机器学习方案之间权衡,二者在处理数据的方式、适用场景和资源消耗上差异明显,理解这些区别有助于做出……

    2026年7月21日
    800
  • 服务器快速复原怎么操作?服务器数据恢复方法详解

    服务器快速复原的核心在于建立系统化的应急响应机制与完善的备份策略,而非单纯依赖技术人员的临时故障排查,企业要实现业务连续性保障,必须将复原时间目标(RTO)和复原点目标(RPO)控制在分钟级别,这需要通过自动化工具、异地容灾架构以及标准化的操作手册来共同实现,最大限度降低因硬件故障、人为误操作或网络攻击导致的停……

    2026年3月23日
    10100
  • 服务器Linux系统如何安装?,安装步骤有哪些?

    服务器装Linux系统,推荐选择CentOS Stream或Ubuntu Server LTS,按步骤操作即可完成安装,linux服务器安装步骤安装Linux系统前,先确认硬件兼容性,绝大多数现代服务器都能跑,但建议内存不低于1GB,磁盘空间在20GB以上,版本选择方面,CentOS Stream适合追求稳定……

    2026年8月6日
    800
  • Python QuerySet怎么查数据?Python QuerySet常用方法

    在 Python 中,QuerySet 是 Django 框架中用于与数据库交互的核心对象,它代表从数据库中查询出来的一组记录(对象集合),并提供了丰富的方法来过滤、排序、聚合数据,以下是关于 Django QuerySet 的全面指南:什么是 QuerySet?惰性加载(Lazy Evaluation):创建……

    2026年7月11日
    11000
  • FC SAN存储是对象存储吗,有什么区别

    FC SAN存储不是对象存储,它是典型的块存储架构,而对象存储是另一种完全不同的数据管理方式,FC SAN存储的本质:块存储的典型代表SAN存储全称是存储区域网络,FC SAN则是利用光纤通道协议搭建的专用存储网络,它的核心工作方式是把存储设备上的空间以块设备的形式映射给服务器,服务器操作系统看到的是一块块未格……

    2026年7月24日
    500
  • 为什么服务器总出故障?修复方法大全来了!

    服务器“不管用”?这12种故障场景与专业解决方案服务器出现“不管用”的状况,核心原因通常可归结为:硬件故障、软件/系统错误、网络问题、资源耗尽、配置不当、人为操作失误、环境因素、安全攻击、备份失效、兼容性问题、固件/驱动缺陷以及监控告警缺失这十二大类根本原因, 每一类问题都需要系统、专业的诊断与解决策略,🔧 一……

    2026年2月14日
    12400
  • 服务器开机关机状态获取方法,如何查看服务器运行状态

    准确获取服务器的开关机状态是运维管理的基石,直接决定了业务连续性与资源调度效率,核心结论在于:单一检测手段往往存在误判风险,构建多层级的检测机制,结合IPMI底层协议、网络层心跳检测与应用层响应验证,是实现服务器状态精准监控的最佳实践, 这一过程不仅要求技术手段的多样化,更依赖于对状态判定逻辑的深度理解, 状态……

    2026年3月27日
    9700
  • python pytable是什么?,怎么用?

    PyTables是Python生态中处理大规模结构化数据的高效方案,它基于HDF5格式,能够在内存和磁盘间灵活管理数据,尤其适合需要快速查询和低内存占用的场景,PyTables是什么:从数据存储到查询PyTables是一个在Python中访问HDF5文件的库,它把HDF5的强大存储能力封装成类似数据库表的接口……

    2026年7月21日
    400
  • python sor是什么?python sor模块怎么用

    Python Sor并非单一软件,而是指代基于Python的多种排序算法实现或特定数据处理库,核心在于利用Python高效的数据结构优化排序性能,解决大规模数据清洗与处理中的效率瓶颈,在2026年的数据驱动环境下,开发者面对的海量非结构化数据呈指数级增长,传统的Excel或基础脚本已难以应对TB级数据的实时排序……

    2026年7月8日
    18800

发表回复

您的邮箱地址不会被公开。 必填项已用 * 标注

评论列表(1条)

  • 田晓燕
    田晓燕 2026年7月11日 04:07

    卧槽这不就是我当年用KNN回测比特币那会儿的翻版? 看了下,说机器学习能抓“人类忽略的模式”——笑死,我模型跑出来连MA