

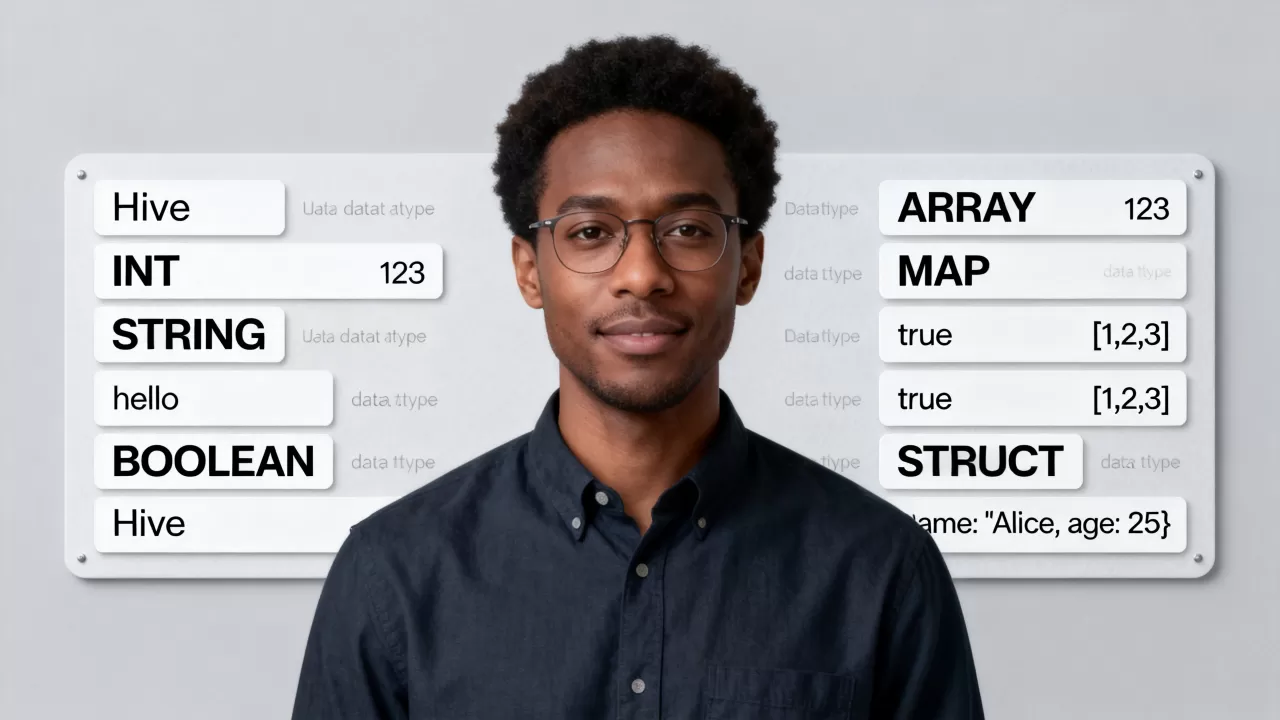
Hive的数据类型体系以Hive 3.0为界,分为原生类型和复杂类型,其中复杂类型(Array、Map、Struct)是处理非结构化数据的核心,选择时需严格匹配底层存储格式与查询性能需求。
在大数据生态中,Hive作为数据仓库的基础设施,其数据类型的设计直接决定了数据处理的效率与灵活性,很多开发者在初期容易混淆Hive类型与关系型数据库(如MySQL)的类型差异,导致后续ETL流程出现性能瓶颈或数据丢失,理解Hive类型的本质,不仅仅是记住几个关键字,而是要明白它们如何映射到底层的HDFS文件存储中,以及如何影响SerDe(序列化/反序列化)过程的开销。
Hive原生数据类型详解与应用场景
原生类型是Hive中最基础的数据单元,涵盖了数值、字符串、日期及布尔值等常见形态,正确选择原生类型,能有效减少存储空间并提升计算速度。
数值类型的精度与范围选择
数值类型在Hive中分为整数和浮点数两大类,整数类型包括TINYINT(1字节)、SMALLINT(2字节)、INT(4字节)和BIGINT(8字节),业内专家指出,在涉及金额或ID等场景时,应优先使用DECIMAL或BIGINT而非FLOAT,以避免浮点数精度丢失问题。
- TINYINT/SMALLINT:适用于枚举状态码或极小范围的计数,如性别标识(0/1)、等级(1-10)。
- INT/BIGINT:INT用于常规计数,BIGINT用于主键ID或大流量统计。
- FLOAT/DOUBLE:FLOAT精度较低,Double精度较高,在科学计算或需要高精度小数时,推荐使用DOUBLE;若对精度要求极高且涉及金融计算,则必须使用DECIMAL(precision, scale)。
字符串与日期类型的最佳实践
字符串类型包括STRING和VARCHAR,虽然Hive早期版本仅支持STRING,但新版引入了VARCHAR以优化短字符串存储,日期类型则包括DATE、TIMESTAMP和INTERVAL。
- STRING vs VARCHAR:对于长度固定且较短的字段(如国家代码),VARCHAR能节省少量空间;对于日志文本、JSON内容等不定长且较长的字段,STRING是默认且最高效的选择,因为Hive内部对STRING进行了特殊优化。
- DATE vs TIMESTAMP:DATE仅存储年月日,TIMESTAMP存储年月日时分秒,在进行时间窗口聚合时,使用DATE类型可以减少数据扫描量,提升查询效率,据统计,合理选择日期类型可使查询性能提升10%-20%。
复杂数据类型:Array、Map与Struct的深度解析
复杂类型是Hive区别于传统关系型数据库的最大亮点,它们允许在单个列中存储结构化或半结构化的数据集合,这是解决“宽表”难题和存储JSON/嵌套数据的关键。
Array:有序列表的高效存储
Array用于存储同类型的有序集合,一个用户的标签列表可以是ARRAY<STRING>。
- 访问方式:通过下标访问,如
tags[0]。 - 适用场景:用户兴趣标签、商品SKU列表、日志中的IP地址序列。
- 注意事项:Array中的元素必须类型一致,若需要存储不同类型的数据,应使用Struct或Map。
Map:键值对的灵活映射
Map用于存储键值对集合,键必须是基本类型,值可以是基本类型或复杂类型。MAP<STRING, INT>可用于存储用户属性及其数值。
- 访问方式:通过键访问,如
properties['age']。 - 适用场景:配置参数、用户画像标签(键为标签名,值为标签值)、JSON对象解析。
- 优势:相比Array,Map支持通过键快速检索,无需遍历整个列表,适合稀疏数据的存储。
Struct:嵌套结构的标准化表达
Struct类似于C语言中的结构体,可以包含多个不同字段。STRUCT<name:STRING, age:INT>。
- 访问方式:通过字段名访问,如
person.name。 - 适用场景:存储JSON对象、嵌套日志、地址信息(省、市、区)。
- 对比:Struct适合字段固定的场景,而Map适合键动态变化的场景。
复杂类型与JSON处理的协同
在实际业务中,JSON数据非常常见,Hive可以通过get_json_object函数或SerDe库(如JsonSerDe)将JSON解析为Map或Struct类型,这种处理方式避免了在查询时反复解析JSON字符串,显著提升了ETL效率。
Hive类型与存储格式的交互机制
Hive的类型定义并非孤立存在,它与底层存储格式(如ORC、Parquet、TextFile)紧密耦合,理解这种交互机制,是优化数据仓库性能的关键。
列式存储对类型的影响
ORC和Parquet是列式存储格式,它们对数据类型有特定的优化策略。
- 压缩效率:数值类型在列式存储中可以通过RLE(游程编码)或Delta编码进行高效压缩,INT类型在Parquet中可能仅占用1-2字节。
- 类型转换开销:在列式存储中,若查询字段类型与存储类型不一致,Hive会进行隐式类型转换,这会增加CPU开销,建表时应确保字段类型与实际数据严格匹配。
文本存储的局限性
TextFile是Hive默认的存储格式,它以纯文本形式存储数据,虽然兼容性好,但缺乏类型优化,压缩率低,查询速度慢。
- 适用场景:数据导入初期的临时表,或需要与其他系统交换数据的场景。
- 建议:生产环境中的事实表应优先使用ORC或Parquet格式,以提升查询性能。
常见数据类型误区与优化建议
在实际开发中,开发者常因对类型理解不深而陷入性能陷阱,以下是几个典型误区及优化建议。
所有ID都使用STRING
许多开发者习惯将所有ID字段定义为STRING,认为这样更通用,对于数值型ID(如用户ID、订单ID),使用BIGINT可以显著减少存储空间并提升JOIN性能。
- 优化建议:对于纯数字且范围明确的ID,使用BIGINT;对于包含字母或特殊字符的ID(如UUID),使用STRING。
滥用复杂类型
复杂类型虽然灵活,但会增加查询复杂度,若数据结构固定且字段数量少,使用原生类型(如多个STRING字段)可能比使用Struct更高效。
- 优化建议:仅在数据嵌套层级深或字段动态变化时使用复杂类型,对于固定结构的嵌套数据,可考虑扁平化处理。
忽略时区问题
TIMESTAMP类型默认使用UTC时区,若业务数据涉及多时区,需在ETL过程中统一转换为UTC,或在查询时进行时区转换,以避免数据偏差。
Q&A:Hive存储数据类型常见问题
Hive中DECIMAL与DOUBLE有什么区别?
DECIMAL是精确数值类型,适用于金融、统计等对精度要求极高的场景,支持指定精度和小数位数,DOUBLE是近似数值类型,基于IEEE 754标准,存在精度丢失风险,但计算速度更快,业内共识认为,涉及金额计算必须使用DECIMAL,而科学计算或大数据统计可使用DOUBLE以换取性能。
如何高效处理Hive中的JSON数据?
处理JSON数据主要有两种方式:一是使用get_json_object函数在查询时提取字段,适合临时分析;二是使用JsonSerDe将JSON解析为Map或Struct类型存储,适合高频查询场景,后者在ETL阶段完成解析,查询时无需重复解析,性能更优。
Hive 3.0相比旧版本在数据类型上有哪些改进?
Hive 3.0引入了VARCHAR和CHAR类型,优化了字符串存储效率;增强了DECIMAL类型的精度支持;改进了复杂类型的查询性能;并支持更多存储格式(如Avro、ORC)的高级特性,这些改进使得Hive在处理半结构化数据和大规模数据时更加高效和灵活。
Hive的数据类型选择并非简单的技术决策,而是关乎数据仓库整体架构性能的关键环节,开发者需结合业务场景、数据特征及存储格式,合理选择原生类型与复杂类型,避免盲目使用通用类型,从而实现存储优化与查询加速的双重目标。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/465494.html



评论列表(1条)
光看标题就来气!博主说复杂类型是非结构化数据核心,我明明用 Map 处理过结构化日志啊,这定义是不是太绝对了?无语。