

观察者模式通过解耦发送者与接收者,配合消息队列实现异步削峰,是构建高并发、高可用分布式系统的核心架构方案。
在早期的单体应用时代,业务逻辑往往像一团乱麻,模块之间紧耦合,牵一发而动全身,随着业务量激增,这种架构迅速暴露出性能瓶颈,引入观察者模式与消息队列(MQ),就像是给系统装上了“缓冲垫”和“广播塔”,让各个模块可以各司其职,互不干扰,这不仅是代码层面的优化,更是系统架构思维的升级。

观察者模式:解耦的艺术与实战
观察者模式的核心在于定义一种一对多的依赖关系,当一个对象的状态发生改变时,所有依赖于它的对象都会得到通知并自动更新,在软件设计中,这被称为“发布-订阅”模型。
为什么需要观察者模式?
想象一下电商下单的场景,用户提交订单后,系统需要完成扣减库存、发送优惠券、记录日志、通知物流等多个动作,如果将这些逻辑全部写在一个方法里,代码会变得极其臃肿且难以维护。
- 降低耦合度:订单模块不需要知道库存模块或优惠券模块的具体实现,只需发布一个“订单创建”事件。
- 提升扩展性:新增业务逻辑(如积分增加)时,只需新增一个观察者,无需修改原有代码,符合开闭原则。
- 支持广播通信:一个事件可以触发多个不同的处理流程,实现业务逻辑的自然分流。
具体场景与代码实现思路
在Java或C#等面向对象语言中,通常通过接口或抽象类来实现。
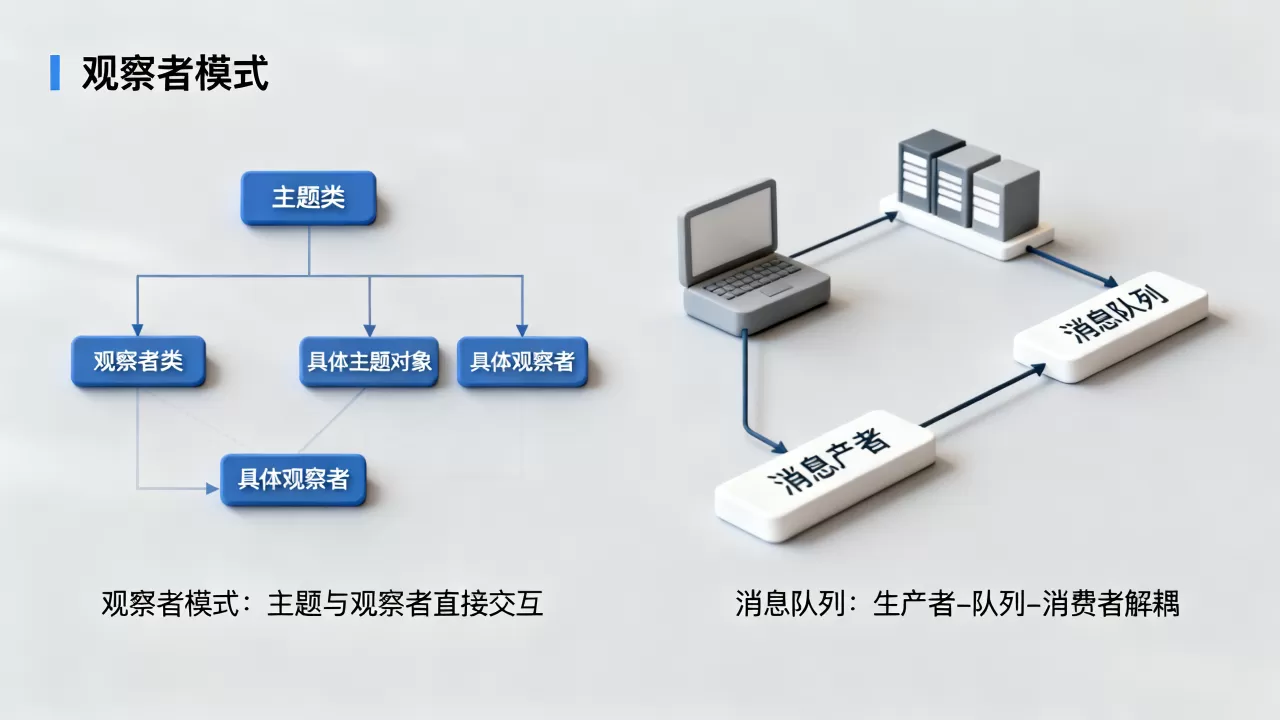
核心组件拆解
- Subject(主题/被观察者):维护一个观察者列表,提供添加、删除和通知观察者的方法。
- Observer(观察者):定义更新接口,当收到通知时执行具体业务逻辑。
- ConcreteSubject/ConcreteObserver:具体的主题和观察者实现类。
当用户注册成功时,系统发布UserRegisteredEvent
,邮件服务观察者接收事件发送邮件,数据分析观察者接收事件更新用户画像,两者互不感知,却协同工作。
消息队列:异步处理与流量削峰
虽然观察者模式解决了模块间的解耦,但在高并发场景下,同步调用依然会导致主线程阻塞,响应时间变长,消息队列(MQ)的引入,将同步调用转化为异步处理,彻底释放了系统资源。
消息队列的核心价值
业内专家指出,消息队列在分布式系统中扮演着“缓冲器”和“解耦器”的双重角色。
- 异步处理:将非核心业务(如发送短信、生成报表)放入队列,主流程立即返回,显著提升用户体验。
- 流量削峰:在秒杀活动中,瞬时流量巨大,MQ可以暂存请求,按系统处理能力匀速消费,防止后端服务崩溃。
- 应用解耦:生产者只需关注消息发送,消费者只需关注消息处理,双方无需了解彼此的存在。
常见消息队列选型对比
目前主流的消息队列包括Kafka、RabbitMQ、RocketMQ和Pulsar,选择时需根据具体场景权衡。
| 特性 | Kafka | RabbitMQ | RocketMQ |
|---|---|---|---|
| 吞吐量 | 极高,适合大数据流 | 中等,适合复杂路由 | 高,适合金融级事务 |
| 延迟 | 毫秒级 | 微秒级 | 毫秒级 |
| 可靠性 | 高,依赖磁盘顺序写 | 高,支持持久化 | 极高,支持事务消息 |
|
适用场景 | 日志采集、行为分析 | 任务调度、即时通讯 | 电商订单、支付清算 |
实操:如何避免消息丢失?
在生产环境中,消息丢失是致命问题,确保消息不丢失需要从三个环节入手:
- 生产者确认:启用ACK机制,确保消息成功发送到Broker。
- Broker持久化:将消息写入磁盘,防止服务重启导致数据丢失。
- 消费者确认:业务逻辑处理成功后再发送ACK,避免重复消费或漏消费。
观察者模式与消息队列的融合应用
将观察者模式与消息队列结合,可以构建出既灵活又稳健的分布式架构,消息队列可以作为观察者模式的底层实现,或者作为解耦的中间件。
架构设计模式
基于MQ的事件驱动架构
在这种模式下,业务系统发布事件到MQ,各个微服务作为消费者订阅相应主题,订单服务发布OrderCreated消息到Topic,库存服务、物流服务、营销服务分别订阅该Topic。
- 解耦更彻底:观察者之间完全通过MQ通信,甚至可以使用不同的技术栈。
- 可靠性更强:MQ提供持久化、重试机制,保证消息最终可达。
- 扩展性极佳:新增服务只需订阅相应Topic,无需修改现有系统。
本地观察者+远程MQ混合模式
对于同一JVM内的模块,使用本地观察者模式,减少网络开销;对于跨服务或跨机房的消息,使用MQ,这种混合模式兼顾了性能与解耦。
实战中的常见陷阱
尽管优势明显,但在实际应用中需注意以下问题:
- 消息重复消费:网络抖动可能导致消息被多次投递,消费者需实现幂等性,通过唯一业务ID去重。
- 消息积压:当消费者处理速度慢于生产者速度时,队列会积压,需优化消费者性能或增加消费者实例。
- 顺序性问题:部分场景要求消息严格顺序处理,需确保同一业务的消息路由到同一队列或分区。
选型建议与成本考量
在选择观察者模式与消息队列方案时,需综合考虑团队技术栈、业务规模及预算。
技术栈匹配
如果团队熟悉Java生态,RocketMQ或Spring Cloud Stream是不错的选择,若涉及大数据实时处理,Kafka是首选,对于轻量级任务调度,RabbitMQ更为合适。
运维成本与价格因素
开源MQ需要自行搭建集群、监控和维护,人力成本较高,云厂商提供的托管MQ服务(如简米云RocketMQ、酷番云CMQ)虽然价格相对较高,但提供了高可用、自动扩缩容等能力,适合中小企业快速上线,据统计,多数企业在初期会选择云托管服务以降低运维负担。
地域与网络延迟
对于跨国或跨地域业务,需考虑网络延迟对消息传输的影响,选择就近的数据中心部署MQ集群,或使用全球同步方案,确保用户体验。
Q&A:常见问题解析
观察者模式与消息队列有什么区别?
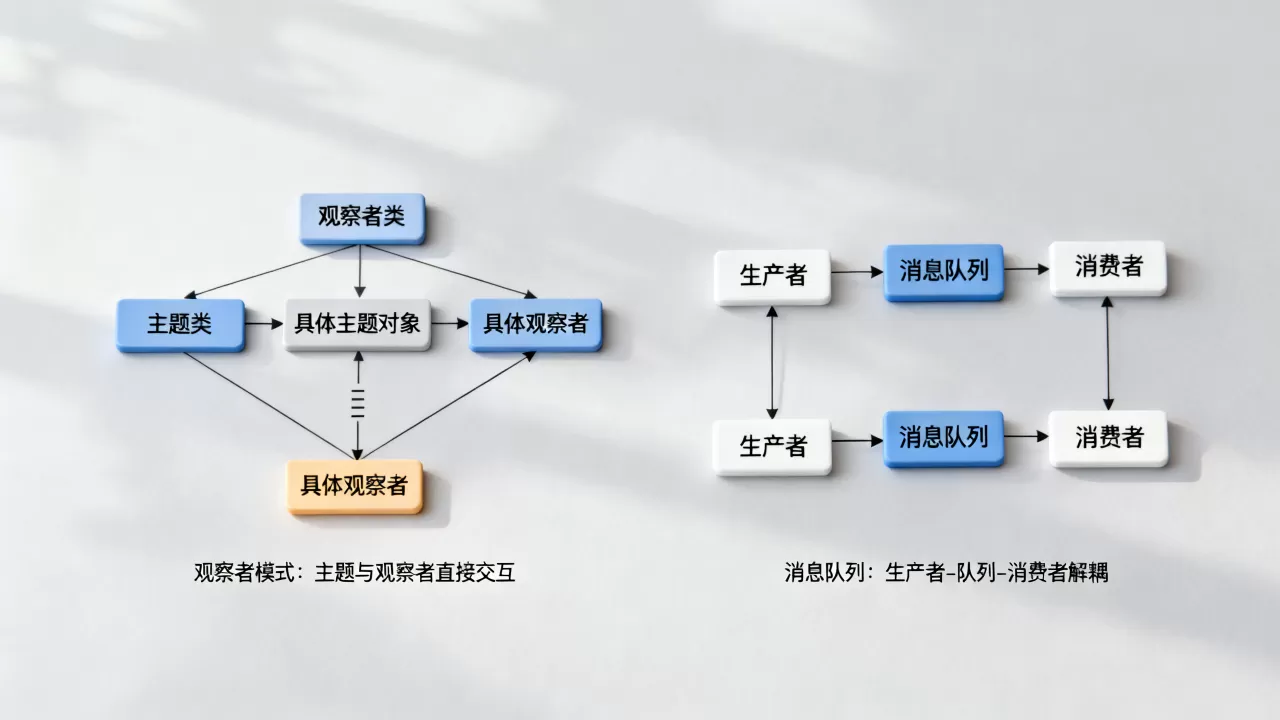
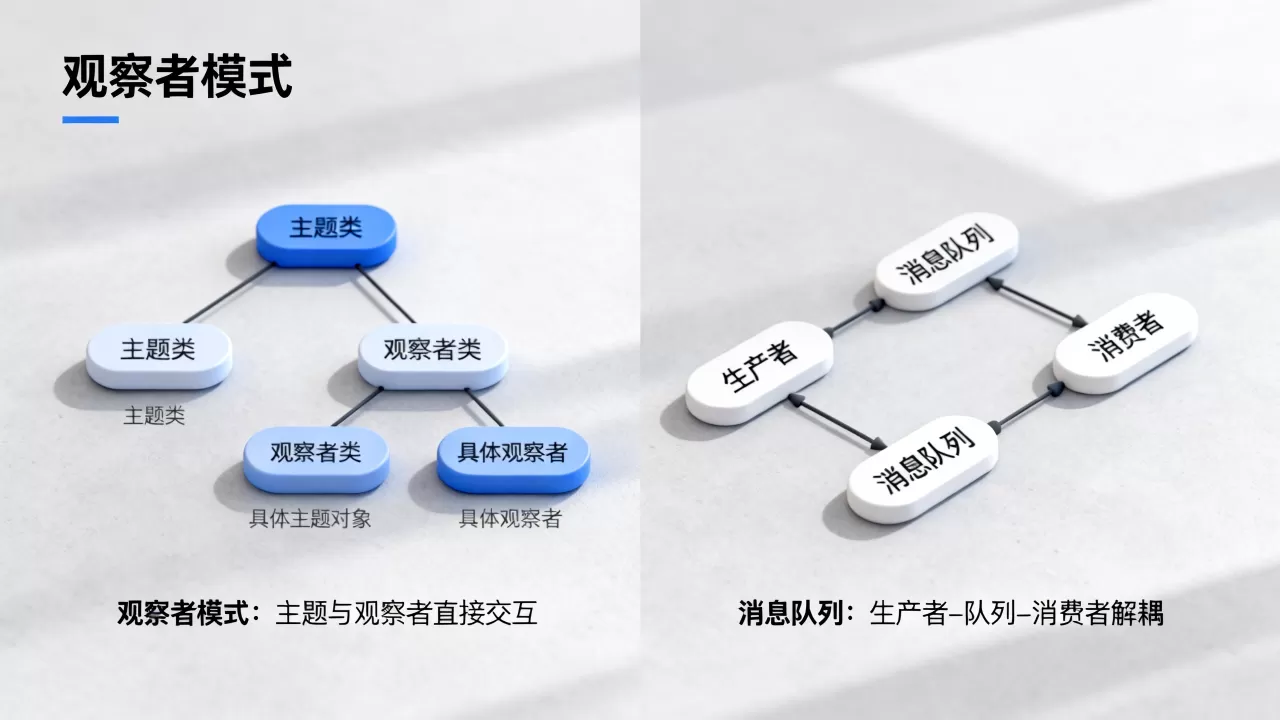
观察者模式是一种设计模式,侧重于对象间的通信机制,通常在内存中实现,适用于同一进程内的模块解耦,消息队列是一种中间件,侧重于数据的持久化传输和异步处理,适用于跨进程、跨网络的系统解耦,两者可以结合使用,MQ作为观察者模式的底层传输通道。
如何保证消息队列的高可用性?
高可用性主要通过集群部署和故障转移机制实现,常见的做法包括:采用主从架构或分布式集群,确保单点故障不影响整体服务;启用数据持久化和同步复制,防止数据丢失;配置监控告警,及时发现并处理异常。
消息队列适合所有场景吗?
并非所有场景都适合引入消息队列,对于实时性要求极高、逻辑简单且无耦合问题的场景,同步调用可能更高效,引入MQ会增加系统复杂度和运维成本,仅在需要异步处理、流量削峰或模块解耦时才推荐使用。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/464101.html





评论列表(1条)
看标题就懂了,以前单体搞崩全靠背锅,现在直接甩锅给 MQ 和观察者,笑死,真香!