Hive存储的数据实例本质上是HDFS上的文件集合,通过元数据映射实现结构化查询,其核心优势在于处理PB级海量数据的离线分析能力。
在大数据生态系统中,Hive扮演着“数据仓库”的关键角色,它让熟悉SQL的开发者能够轻松操作底层复杂的HDFS文件系统,对于很多初次接触大数据的技术人员来说,理解Hive存储的数据实例究竟长什么样,是打通从传统关系型数据库到大数据平台思维转换的第一道关卡。
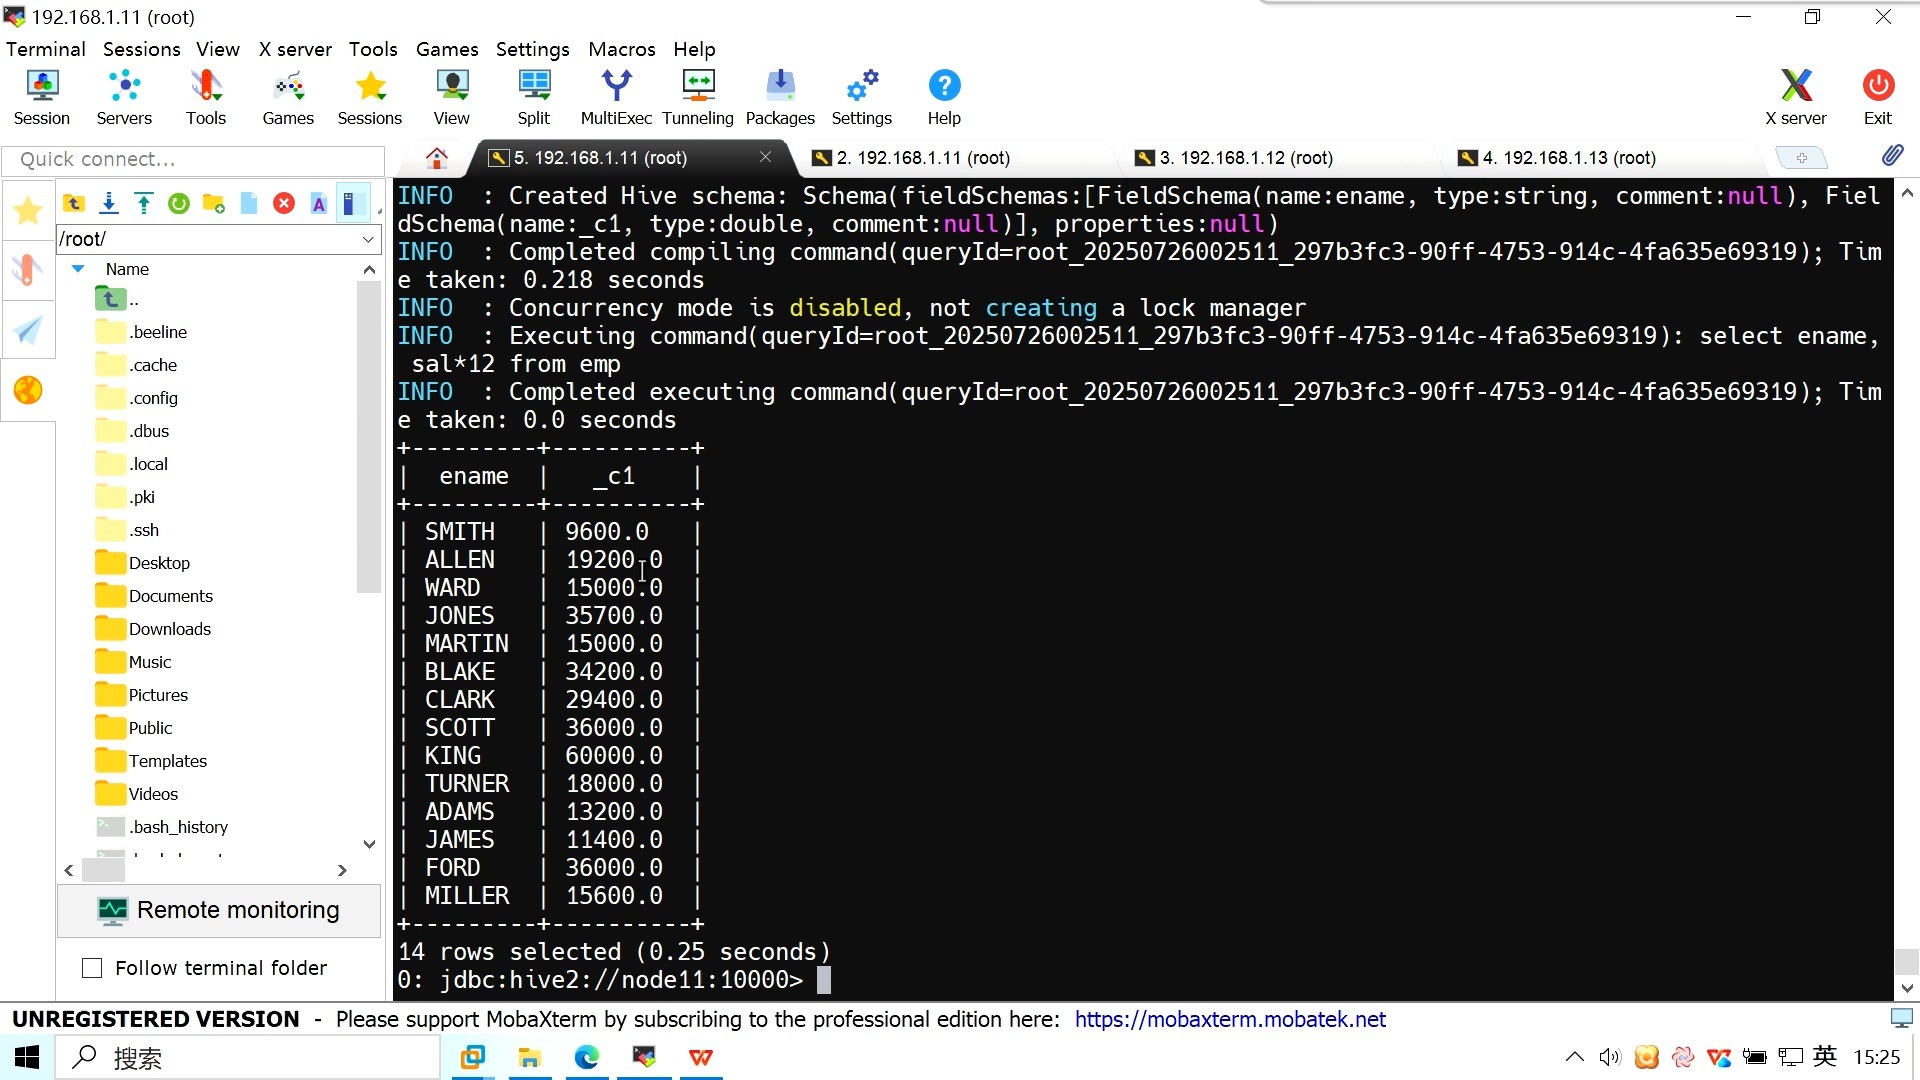
Hive数据实例的物理存储形态解析
很多人误以为Hive里存的是类似MySQL那样的行式存储文件,实际上完全不是,Hive的数据实例在物理层面上,就是Hadoop分布式文件系统(HDFS)上的一堆普通文本文件或二进制文件。
内部表与外部表的区别
理解Hive存储实例,首先要区分内部表(Managed Table)和外部表(External Table),这两者在数据存储位置上的逻辑差异,直接决定了数据生命周期管理的方式。
- 内部表:当你创建一张内部表并导入数据后,Hive会在HDFS上为该表创建一个专属目录,如果你执行
DROP TABLE命令,Hive不仅会删除元数据,还会连同HDFS上的数据文件一起删除,这种机制适合那些完全由Hive生命周期管理的数据实例。 - 外部表:外部表指向HDFS上已存在的某个目录,执行
DROP TABLE时,Hive只删除元数据映射关系,HDFS上的原始数据文件依然完好无损,这在多团队共享数据、或数据需要被Spark、Pig等其他工具读取的场景下非常常见。
存储格式对实例大小的影响
Hive支持多种存储格式,不同的格式会导致同一个数据实例在磁盘上占据完全不同的空间,业内专家指出,选择合适的存储格式可以显著降低存储成本并提升查询效率。
| 存储格式 | 压缩比 | 查询速度 | 适用场景 |
|---|---|---|---|
| TextFile | 无 | 慢 | 数据导入临时文件,不推荐生产环境使用 |
| SequenceFile | 中 | 中 |
二进制存储,适合MapReduce中间结果 |
| RCFile | 高 | 快 | 列式存储,适合OLAP分析,但写入性能较差 |
| ORC | 高 | 极快 | 优化后的列式存储,支持索引,当前主流选择 |
| Parquet | 高 | 快 | 列式存储,与Spark生态兼容性极佳 |
在大多数现代Hive集群中,ORC格式已成为存储数据实例的首选,它不仅提供了极高的压缩比,还内置了索引结构,使得Hive在进行SELECT查询时,能够跳过不需要的数据块,从而大幅减少I/O开销。
元数据:连接逻辑与物理的桥梁
如果HDFS上的文件是“肉体”,那么Hive的元数据(Metastore)灵魂”,没有元数据,HDFS上的那些文件只是一堆毫无意义的字节流,Hive存储的数据实例之所以能被SQL查询,完全依赖于元数据库中保存的表结构、分区信息以及文件路径映射。
元数据的存储介质
Hive的元数据通常存储在关系型数据库中,如MySQL、PostgreSQL或Derby,Derby仅适用于单用户测试环境,而在生产环境中,MySQL是绝对的主流选择。
当你在Hive CLI中输入CREATE TABLE时,Hive客户端会将表的定义(列名、类型、分隔符等)写入MySQL数据库,Hive会在HDFS上创建对应的目录,当你执行INSERT INTO时,数据被写入HDFS文件,而元数据中会增加一条记录,指向这个新文件的位置。
分区与分桶:实例的组织艺术
面对PB级数据,线性扫描是不可接受的,Hive通过分区(Partition)和分桶(Bucket)来优化数据实例的访问路径。
- 分区:相当于在HDFS目录结构中建立子目录,按日期分区,数据实例会被存储在
/data/dt=20260101/和/data/dt=20260102/等不同目录下,查询时,Hive可以根据WHERE dt='20260101'直接定位到特定目录,避免全表扫描。 - 分桶:是对数据进一步细分,通常基于某个字段的哈希值,分桶数据实例在HDFS上表现为多个文件,每个文件包含特定哈希范围的数据,这对于
JOIN
数据实例的实操管理与维护
理解理论之后,掌握具体的操作路径至关重要,在实际工作中,如何高效地管理和维护这些Hive数据实例,是数据工程师的核心技能。
数据导入与导出路径
将数据加载到Hive实例中,通常有以下几种常见方式:
-
本地文件加载:
使用LOAD DATA LOCAL INPATH命令。LOAD DATA LOCAL INPATH '/home/user/data.csv' OVERWRITE INTO TABLE my_table;
这条命令会将本地文件复制到HDFS对应的表目录中,注意,
OVERWRITE关键字会清空目标表原有数据。 -
HDFS文件移动:
如果数据已经在HDFS上,可以使用LOAD DATA INPATH。LOAD DATA INPATH '/input/data.csv' INTO TABLE my_table;
这实际上是一个HDFS的文件移动操作,速度极快,因为不涉及数据复制,只是修改了文件路径的元数据指向。
-
查询结果插入:
从其他表查询数据并插入当前表。INSERT OVERWRITE TABLE my_table PARTITION (dt='20260101') SELECT col1, col2 FROM source_table WHERE dt='20260101';
这种方式常用于ETL流程,将清洗后的数据写入目标实例。
数据清理与碎片整理
随着数据的不断写入,HDFS上会产生大量小文件,这些小文件会严重拖慢NameNode的性能,并增加Hive查询的启动时间。
-
小文件合并:
可以通过设置Hive参数来自动合并小文件。SET hive.merge.mapfiles = true; SET hive.merge.mapredfiles = true; SET hive.merge.size.per.task = 256000000;
在执行完MapReduce或Tez任务后,Hive会自动将输出目录中的小文件合并为接近256MB的大文件。
-
动态分区修剪:
确保在查询中充分利用分区字段,避免全表扫描,对于历史数据归档,可以使用ALTER TABLE ... DROP PARTITION命令物理删除不再需要的数据实例,释放HDFS空间。
Hive与其他存储方案的对比选型
在构建数据仓库时,选择Hive还是其他方案,取决于具体的业务场景,业内共识认为,Hive在离线批处理领域具有不可替代的地位,但在实时性要求高的场景中则显得力不从心。
Hive vs. MySQL
- 数据规模:MySQL适合GB级数据,Hive适合TB至PB级数据。
- 延迟:MySQL提供毫秒级响应,Hive查询通常需要分钟级甚至小时级。
- 扩展性:MySQL垂直扩展成本高,Hive基于Hadoop横向扩展,成本极低。
- 适用场景:MySQL用于在线事务处理(OLTP),Hive用于在线分析处理(OLAP)。
Hive vs. HBase
- 读写模式:Hive适合批量写入、顺序读取;HBase适合随机读写、低延迟查询。
- 数据结构:Hive是面向列的,适合聚合分析;HBase是面向行的,适合键值对查询。
- 实例维护:Hive数据实例是静态的文件,HBase数据实例是动态的StoreFile,需要频繁合并。
对于需要Hive存储的数据实例进行复杂SQL分析的场景,Hive是首选,而对于需要毫秒级随机访问的场景,则应考虑HBase或ClickHouse等方案。
常见问题解答(Hive存储的数据实例)
Hive数据实例损坏了怎么办?
如果HDFS上的数据文件损坏,Hive查询会报错,首先检查HDFS健康状态,使用hdfs fsck命令检测文件完整性,如果确认文件损坏,需从备份源重新加载数据,对于内部表,可以直接重新LOAD DATA;对于外部表,需确保HDFS上的源文件已恢复,并检查元数据路径是否正确。
如何查看Hive数据实例的具体大小?
可以使用DESCRIBE FORMATTED table_name;命令查看表的详细信息,其中Location字段指向HDFS路径,然后使用HDFS命令hdfs dfs -du -h /path/to/table查看该目录下所有文件的大小总和,Hive内部表的大小信息也会记录在Metastore中,可通过查询DBS和SDS元数据表获取估算值。
Hive存储的数据实例支持实时查询吗?
原生Hive不支持毫秒级实时查询,其基于MapReduce或Tez的执行引擎决定了它适合离线批处理,如果需要实时查询,可以使用Hive on Spark结合预计算技术,或者转向Apache Drill、Presto/Trino等基于内存的查询引擎,它们可以直接读取Hive存储的数据实例,但提供的是亚秒级的响应速度。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/463984.html