非神经网络机器学习通过规则引擎、决策树和集成算法解决结构化数据问题,在可解释性、小样本训练和算力成本控制上显著优于深度学习,是传统企业数字化转型的首选方案。
为什么非神经网络模型依然占据企业核心地位
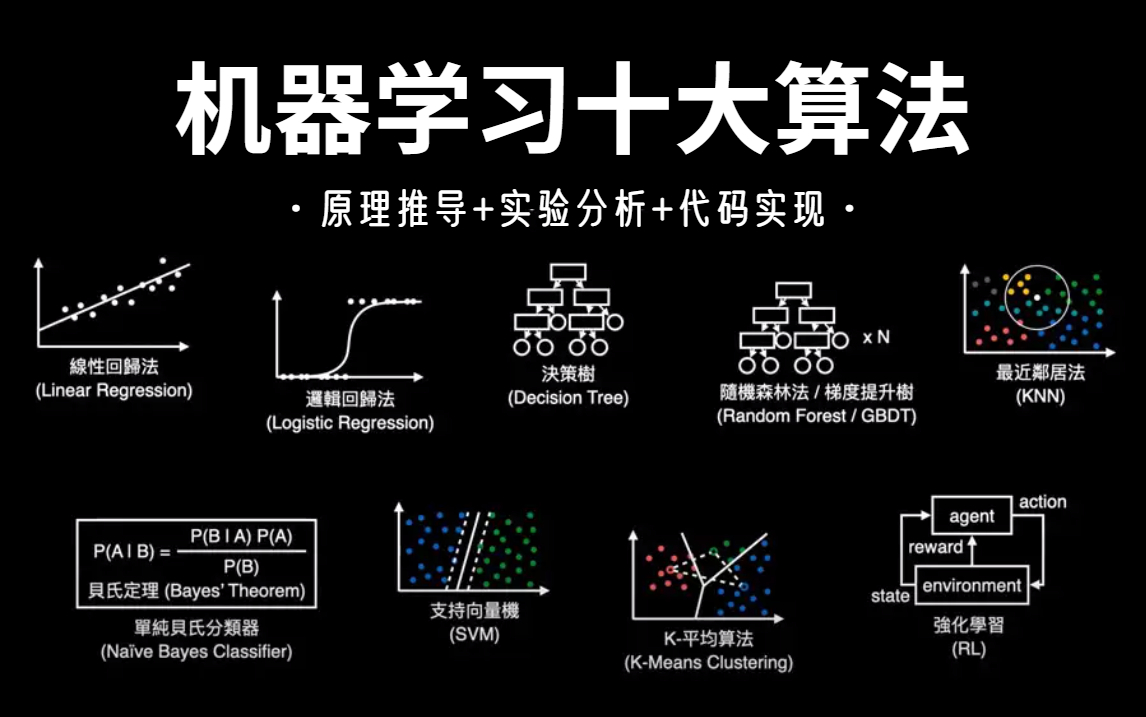
在人工智能热潮中,深度学习常被捧上神坛,但业内专家指出,绝大多数商业场景并不需要复杂的神经网络,非神经网络机器学习(Non-Neural Network Machine Learning)涵盖了从简单的线性回归到复杂的随机森林、梯度提升树(GBDT)等算法,这些模型在处理表格型数据时,往往能取得与深度学习相当甚至更优的效果。
可解释性:黑盒之外的信任基石
金融风控、医疗诊断等高风险领域,模型不仅要给出结果,还要解释原因,深度学习模型如同一个黑盒,输入数据后直接输出预测结果,内部逻辑难以追溯,相比之下,决策树模型可以清晰地展示“如果年龄大于30且收入小于5万,则拒绝贷款”这样的规则路径,这种透明度对于合规审计至关重要。
规则引擎的直观优势
基于规则的系统允许业务人员直接参与逻辑构建,在电商推荐系统中,可以设定“新用户首单打八折”的硬规则,再结合协同过滤算法进行微调,这种混合模式既保证了业务策略的刚性执行,又利用了算法的灵活性。
算力成本与部署效率
训练一个大型神经网络可能需要数百块GPU运行数周,而训练一个XGBoost模型在普通CPU上只需几分钟,对于资源有限的中小企业,非神经网络方案提供了极高的性价比,部署时,模型文件通常只有几MB到几十MB,无需庞大的推理集群,边缘设备也能轻松运行。
主流非神经网络算法实战对比
选择正确的算法是项目成功的关键,不同算法适用于不同的数据特征和业务目标。
决策树与随机森林:分类任务的主力军
决策树通过一系列二元问题将数据分割成不同的类别,其优点在于结构简单,易于理解,单棵决策树容易过拟合,即对训练数据记忆过深,对新数据泛化能力差,随机森林通过构建多棵决策树并取多数投票结果,有效解决了过拟合问题。
- 适用场景:用户流失预测、信用评分、图像分类预处理。
- 操作建议:使用Scikit-learn库中的
RandomForestClassifier,调整n_estimators参数以平衡偏差和方差,通常建议从100棵树开始,逐步增加直到性能不再显著提升。
梯度提升树(GBDT):精度优化的利器
GBDT通过串行训练多棵树,每一棵树都致力于修正前一棵树的残差,XGBoost、LightGBM和CatBoost是GBDT的三大主流实现,它们在Kaggle竞赛中占据主导地位,因其对缺失值处理、类别特征编码的高效支持而备受青睐。
- 核心优势:处理缺失值能力强,支持并行计算,防止过拟合机制完善。
- 参数调优重点:学习率(learning_rate)、树的最大深度(max_depth)和子采样比例(subsample),较低的学习率配合较多的树数量通常能获得更好的效果。
支持向量机(SVM):小样本高维数据的专家
当数据维度极高但样本量较少时,SVM通过寻找最优超平面来区分不同类别,核技巧(Kernel Trick)使得SVM能够处理非线性可分数据,尽管在大数据时代其应用范围有所缩小,但在文本分类、生物信息学等领域仍具独特价值。
非神经网络模型在垂直行业的落地路径
理论需结合实践,以下是几个典型行业的落地场景及操作指南。
制造业:设备故障预测性维护
工厂传感器每秒产生大量振动、温度数据,传统规则难以捕捉复杂的故障前兆。
- 数据预处理:使用滑动窗口提取时域特征(均值、方差)和频域特征(FFT变换后的峰值)。
- 特征工程:利用互信息法筛选与故障相关性最高的特征。
- 模型选择:采用LightGBM进行二分类(正常/故障)预测。
- 部署验证:将模型嵌入边缘网关,实时监测异常,一旦预测概率超过阈值,立即触发报警。
据统计,采用此类方案的制造企业可将非计划停机时间减少30%,维护成本降低
20%。
零售业:精准营销与库存优化
零售商面临海量SKU和用户行为数据。
- 关联规则挖掘:使用Apriori算法分析购物篮数据,发现“啤酒与尿布”式的隐性关联,优化货架摆放。
- 销量预测:利用Prophet或XGBoost结合节假日、天气、促销活动等外部变量,预测未来一周各门店销量,指导自动补货。
如何评估非神经网络模型的性能
评估模型不能仅看准确率,需结合业务目标选择指标。
分类任务指标详解
- 准确率(Accuracy):适用于类别平衡的数据集。
- 精确率(Precision)与召回率(Recall):在欺诈检测中,高精确率意味着误报少;在疾病筛查中,高召回率意味着漏报少。
- F1-Score:精确率和召回率的调和平均数,综合衡量模型性能。
- AUC-ROC曲线:评估模型在不同阈值下的整体排序能力,不受类别不平衡影响。
回归任务指标详解
- 均方误差(MSE):对异常值敏感,适用于误差分布均匀的场景。
- 平均绝对误差(MAE):鲁棒性强,易于解释,代表预测值与实际值的平均偏差。
- R平方(R²):反映模型解释数据变异的比例,越接近1越好。
非神经网络与深度学习的选型决策树
面对具体项目,决策者常陷入“用不用神经网络”的纠结,以下对比有助于快速决策。
| 维度 | 非神经网络(如GBDT, SVM) | 深度学习(如CNN, RNN) |
|---|---|---|
| 数据类型 | 结构化表格数据为主 | 非结构化数据(图像、语音、文本) |
| 数据量需求 | 小样本即可表现良好 |
需要海量数据驱动 |
| 特征工程 | 依赖人工特征提取 | 自动特征学习 |
| 训练速度 | 快,分钟级 | 慢,小时至天级 |
| 可解释性 | 高,规则清晰 | 低,黑盒模型 |
| 硬件依赖 | 低,CPU即可 | 高,需GPU/TPU |
混合架构:最佳实践
现代系统往往采用混合架构,在推荐系统中,使用深度学习处理用户画像和物品内容的嵌入向量,再将这些向量作为特征输入到GBDT模型中进行最终排序,这种组合兼顾了特征表示能力和排序精度。
常见问题解答
非神经网络机器学习在2026年是否会被淘汰
不会,尽管深度学习在感知任务上占据主导,但在结构化数据分析和因果推断领域,非神经网络模型因其高效、透明和低成本,依然是工业界的标准配置,随着数据隐私法规趋严,轻量级、可解释的模型更受青睐。
非神经网络机器学习适合处理图像识别吗
传统非神经网络如SVM或随机森林处理原始像素数据效果极差,因为缺乏空间层次特征提取能力,但对于经过预处理的特征数据(如HOG、SIFT),它们仍能有效工作,若需直接处理图像,建议结合深度学习提取特征后再使用传统算法分类,或直接使用轻量级CNN。
非神经网络机器学习的学习资源与价格是多少
学习成本较低,开源库如Scikit-learn、XGBoost提供丰富文档和社区支持,无需购买昂贵授权,主要成本在于人力投入和数据清洗,对于初学者,建议从Python基础语法入手,掌握Pandas进行数据操作,再逐步深入算法原理,实际项目中,云服务提供商通常提供免费额度供测试,无需预先投入大量资金。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/463220.html