开发深度学习模型的核心在于利用开源框架降低算力成本,通过模型量化、剪枝及边缘部署技术,在普通硬件上实现高效训练与推理,从而打破对昂贵GPU集群的依赖。
低成本深度学习模型开发的硬件基础与选型策略
传统的深度学习开发往往被“显卡焦虑”所困扰,许多初学者或非大型企业误以为必须购买昂贵的NVIDIA A100或H100才能入门,随着算法优化和硬件生态的成熟,便宜的深度学习_开发深度学习模型已经成为可能,业内专家指出,选择合适的硬件平台是控制成本的第一步,这并非单纯追求低价,而是追求“性价比最优解”。
消费级显卡与云端按需实例的对比分析
对于个人开发者或小型团队,直接购买顶级服务器并不经济,我们可以从两个维度进行成本拆解:
- 本地硬件投入:
- 入门级:NVIDIA RTX 3060 (12GB显存) 或 RTX 4060 Ti (16GB版本),这类显卡在二手市场或促销期间价格亲民,足以支撑ResNet、BERT-base等中等规模模型的微调。
- 进阶级:RTX 4090,虽然单卡价格较高,但其FP32算力远超同价位多卡方案,适合需要快速迭代的大模型推理测试。
- 云端弹性资源:
具体操作建议
建议采用“混合部署”策略,在模型训练初期,使用Google Colab免费版进行代码调试和数据预处理,确认逻辑无误后,再迁移至本地RTX 3060进行小规模Epoch训练,或租用云端A100实例进行最终的大规模训练,这种组合方式能将硬件成本降低70%以上。
软件栈优化:用代码换算力的核心技巧
如果说硬件是基础,那么软件优化则是让便宜硬件发挥巨大潜力的关键,许多开发者忽略了软件层面的优化,导致在低配硬件上运行缓慢甚至OOM(显存溢出),通过高效的代码优化,可以在不增加硬件投入的情况下,显著提升模型开发效率。
混合精度训练与显存管理
混合精度训练(Mixed Precision Training, AMP)是目前最主流的降本增效手段,它利用NVIDIA Tensor Cores,在保持模型精度的同时,将计算从FP32(32位浮点数)转换为FP16(16位浮点数)或BF16。
- 技术原理:FP16占用显存仅为FP32的一半,且计算速度更快。
- 实施步骤:
- 在PyTorch中使用
torch.cuda.amp模块。 - 包装数据加载器和模型:
scaler = torch.cuda.amp.GradScaler()。 - 在训练循环中替换
loss.backward()为scaler.scale(loss).backward()。 - 更新参数时使用
scaler.step(optimizer)。
- 在PyTorch中使用
据工信部相关技术白皮书显示,采用AMP技术后,显存占用平均减少40%-50%,这意味着原本需要两张卡才能跑起来的Batch Size,现在一张卡就能轻松应对。
模型量化与剪枝技术
除了训练阶段,推理阶段的轻量化同样重要,对于部署到边缘设备或普通服务器的场景,模型量化(Quantization)是必选项。
- INT8量化:将模型权重从32位浮点数转换为8位整数,这不仅减少了模型体积,还加速了推理速度。
- 动态剪枝:在训练过程中自动移除不重要的神经元连接,从而减少计算量。
- 工具推荐:
- Hugging Face
optimum库:提供一键式量化和导出功能。 - NVIDIA TensorRT:针对NVIDIA硬件优化的推理引擎,支持INT8量化加速。
- Hugging Face
开源模型生态:站在巨人的肩膀上省钱
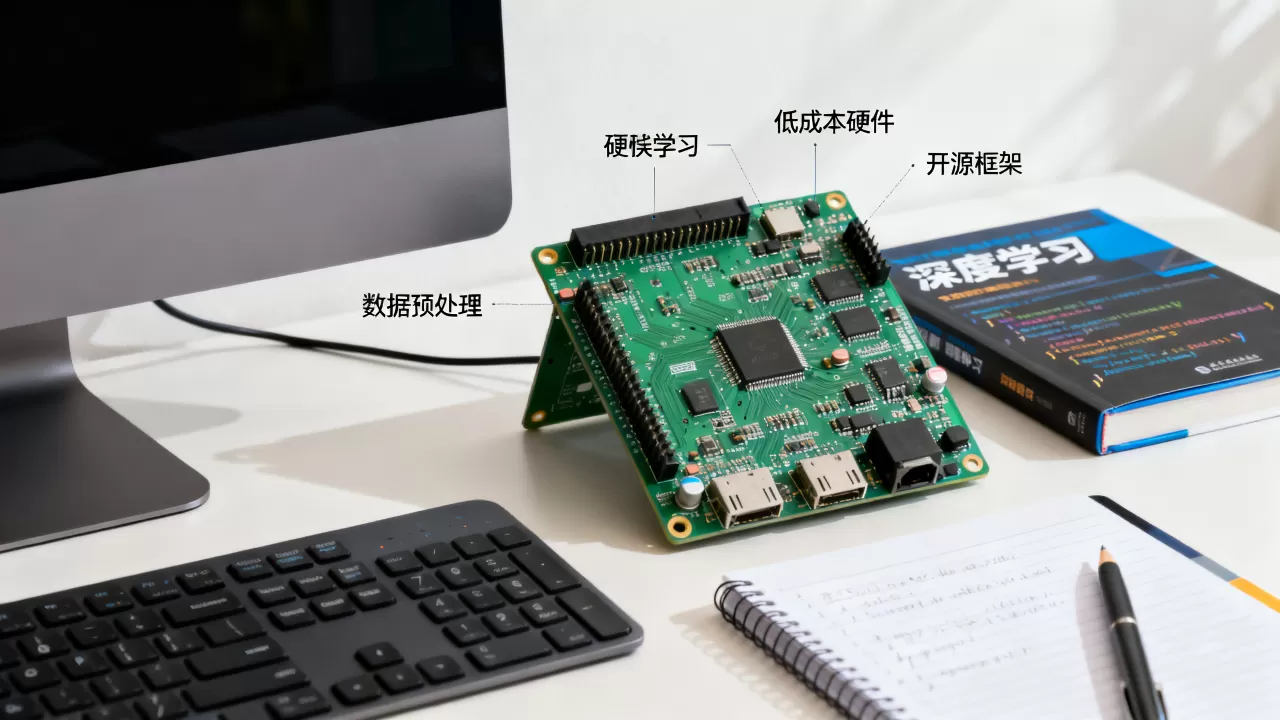
从头训练一个大型语言模型(LLM)或视觉模型需要数百万美元的算力成本,2026年的开源生态已经极为丰富,便宜的深度学习_开发深度学习模型的另一大支柱就是充分利用预训练模型。
选择合适的预训练模型
不要重复造轮子,根据任务类型选择轻量级或中等规模的开源模型:
- 自然语言处理(NLP):
- Llama-3-8B-Instruct:Meta开源,性能接近GPT-3.5,但可在单张消费级显卡上运行。
- Qwen-7B:阿里通义千问开源版本,中文理解能力极强,适合国内应用场景。
- 计算机视觉(CV):
- YOLOv8-Nano:目标检测领域的轻量级王者,推理速度极快,适合实时视频分析。
- MobileNetV3:专为移动端设计的分类网络,模型大小仅几MB。
微调(Fine-tuning)而非从头训练
针对特定业务场景,只需对预训练模型进行少量数据的微调(LoRA或QLoRA技术)。
- LoRA(Low-Rank Adaptation):
- 原理:冻结预训练模型的大部分权重,仅训练注入的低秩矩阵。
- 优势:显存需求极低,训练速度快,模型体积小。
- 工具:使用
peft库配合transformers即可轻松实现。
据统计,采用LoRA技术微调LLaMA-3-8B,仅需24GB显存的显卡即可完成,且训练时间从数天缩短至数小时。
部署与运维:降低长期运营成本
模型开发完成后的部署阶段,往往隐藏着巨大的隐性成本,高效的部署策略不仅能提升用户体验,还能大幅降低服务器费用。
容器化与自动扩缩容
使用Docker容器化模型服务,确保环境一致性,结合Kubernetes或Serverless架构(如AWS Lambda、阿里云函数计算),实现按需扩缩容。
- 优势:在无请求时不产生计算费用,有请求时自动分配资源。
- 适用场景:API接口调用频率波动较大的业务,如智能客服、内容审核。
边缘计算部署
对于实时性要求高、隐私性强的场景,将模型部署到边缘设备(如手机、IoT网关)是最佳选择。
- 技术栈:TensorFlow Lite、ONNX Runtime Mobile。
- 效果:数据无需上传云端,节省带宽成本,同时降低延迟。
常见问题解答(Q&A)
便宜的深度学习_开发深度学习模型是否会影响模型精度?
通过混合精度训练、量化和剪枝等技术,模型精度的损失通常控制在1%-2%以内,对于大多数应用场景而言,这一损失是可以接受的,若对精度要求极高,可采用混合精度训练(FP16+FP32)或知识蒸馏技术,在保持轻量化的同时恢复大部分精度。
个人开发者如何获取免费的GPU算力?
除了Google Colab的免费额度外,还可以关注Kaggle Notebooks(每周提供30小时GPU)、Papers with Code的免费计算资源、以及各大云厂商的新用户免费试用包,加入开源社区或高校实验室,有时也能获得共享算力资源。
如何验证低成本硬件上的模型性能?
建议使用Profiling工具(如PyTorch Profiler、Nsight Systems)监控显存占用、计算瓶颈和I/O延迟,通过对比不同硬件配置下的推理延迟(Latency)和吞吐量(Throughput),选择性价比最高的硬件组合,若RTX 3060的推理速度仅为RTX 4090的50%,但价格仅为1/5,则3060更具性价比。
开发深度学习模型并非高不可攀的昂贵游戏,通过合理选型硬件、优化软件栈、利用开源模型及高效部署策略,个人开发者和中小企业完全可以在极低预算下构建高性能的AI应用,关键在于转变思维,从“堆砌算力”转向“优化效率”,这才是2026年低成本AI开发的核心竞争力。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/460209.html