规则引擎解析数据的核心在于将非结构化或半结构化的业务数据,通过预设的逻辑规则进行自动化清洗、转换和路由,从而实现业务逻辑与代码的解耦,让不懂编程的业务人员也能直接配置数据处理流程。
为什么传统代码处理数据越来越吃力
硬编码带来的维护噩梦
在早期的系统架构中,数据清洗和规则判断往往直接写死在Java、Python或C++的代码里,这种做法在项目初期看似高效,但随着业务复杂度提升,问题接踵而至,每当营销部门想要修改“满减”活动的门槛,或者风控部门需要调整“高风险用户”的定义,开发人员就必须修改源代码、重新编译、测试并部署,这种流程不仅耗时,而且极易引入新的Bug。

业内专家指出,超过半数的企业级应用维护成本,都消耗在业务逻辑变更导致的代码重构上,当规则分散在几十个不同的模块中时,排查一个数据异常可能需要翻阅数百行代码,效率极低。
业务响应速度的滞后
互联网行业的竞争本质是速度的竞争,当市场活动需要临时增加一个“新用户首单立减”的规则时,如果依赖传统开发模式,从需求提出到上线可能需要3-5天,而采用规则引擎后,业务人员可以在后台界面直接配置规则,分钟级生效,这种敏捷性对于电商、金融、物流等高频变动场景至关重要。
规则引擎解析数据的核心机制
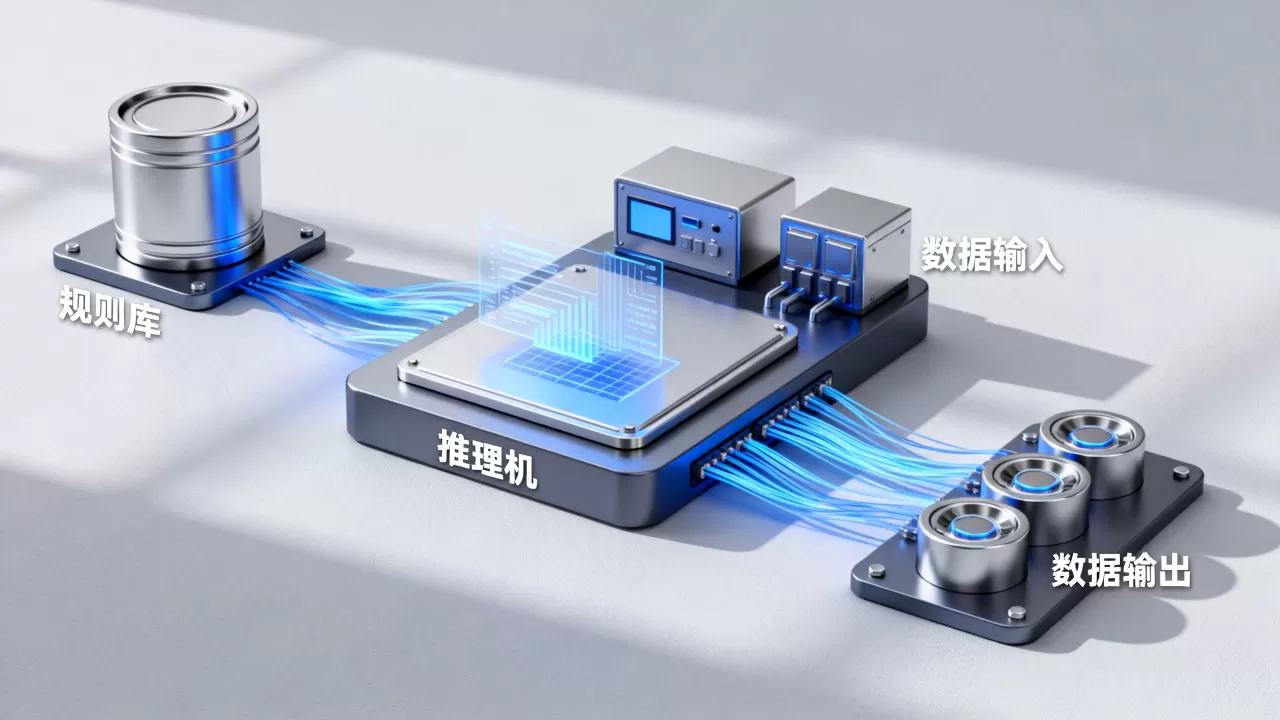
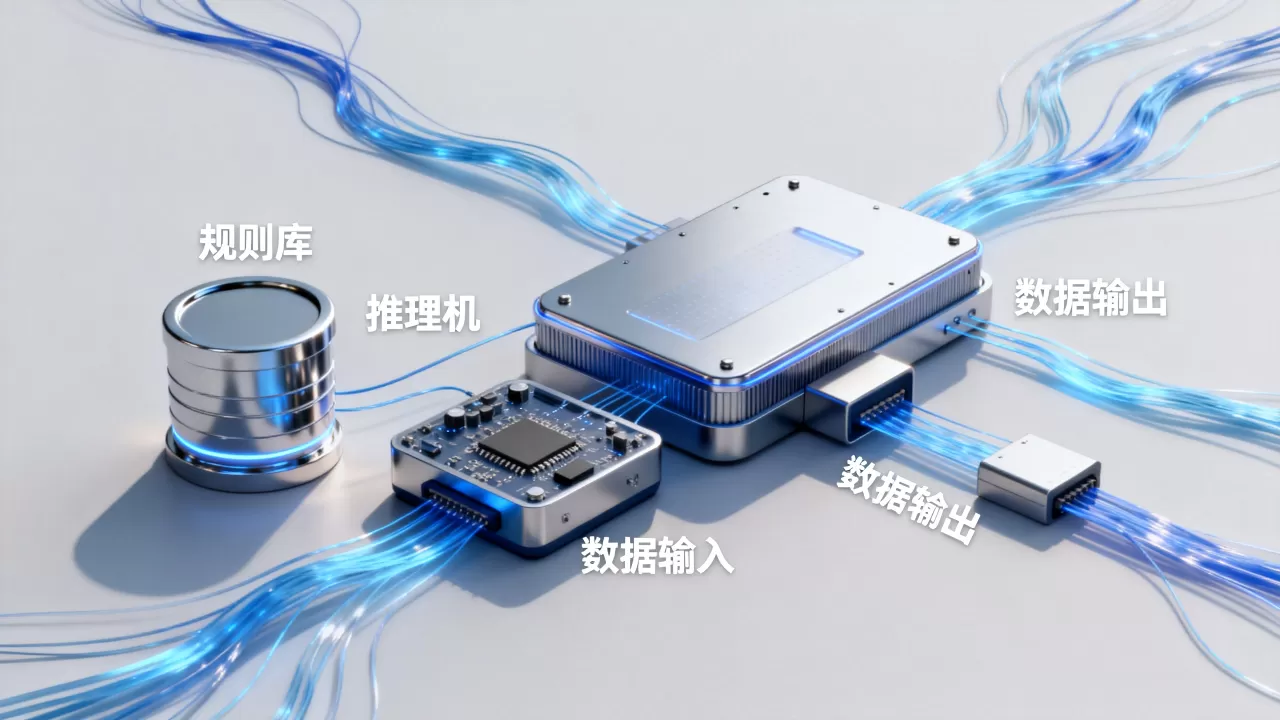
规则引擎并非简单的“那么”判断,它是一个完整的决策执行框架,它通过解析数据模型,匹配预定义的规则集,并执行相应的动作。
数据输入与标准化
规则引擎的第一步是接收数据,这些数据可能来自数据库、API接口、消息队列或用户上传的文件,为了确保规则能准确执行,数据必须经过标准化处理。
- 数据清洗:去除空值、修正格式错误(如日期格式统一为YYYY-MM-DD)。
- 字段映射:将不同来源的字段名映射到统一的数据模型中,将“user_age”和“年龄”统一映射为“age”。
- 上下文构建:将处理后的数据封装成规则引擎可识别的上下文对象(Context),供后续规则调用。
规则解析与匹配
这是规则引擎最核心的部分,常见的规则解析方式包括:
- 决策表:适合处理多条件组合的场景,根据“用户等级”和“订单金额”两个维度,决定折扣力度,决策表以表格形式呈现,直观易懂。
- 决策树:适合处理具有层级关系的逻辑,根据用户的浏览路径,层层筛选出潜在高价值客户。
- Drools等引擎的DSL:对于复杂逻辑,使用领域特定语言(DSL)编写规则,既保持了可读性,又具备强大的逻辑表达能力。
执行与输出
规则匹配成功后,引擎会执行相应的动作,这些动作可以是简单的数据修改,也可以是复杂的业务流程触发,如发送通知、更新数据库状态或调用外部API,执行结果会被记录在日志中,便于后续审计和优化。
不同场景下的规则引擎应用对比
为了更清晰地理解规则引擎的价值,我们对比几种典型的应用场景。
电商营销场景
在电商大促期间,优惠券规则极其复杂。“满200减30”、“满300减50”、“新用户专享券”等规则可能存在互斥或叠加关系。
| 场景 | 传统代码方式 | 规则引擎方式 |
|---|---|---|
| 规则变更 | 需修改代码,重新部署,耗时数天 | 后台配置,即时生效,耗时分钟级 |
| 规则复杂度 | 逻辑嵌套深,难以维护 | 可视化配置,逻辑清晰,易于理解 |
| 测试成本 | 需回归测试所有相关模块 | 仅测试变更的规则,回归成本低 |
金融风控场景
金融机构需要实时判断交易风险,规则引擎可以结合用户画像、交易行为、地理位置等多维度数据,实时计算风险评分。
- 实时性要求:风控规则需要在毫秒级内完成计算,规则引擎的高性能执行能力是关键。
- 规则版本管理:风控策略经常调整,规则引擎需提供完善的版本管理和灰度发布功能,确保策略变更不影响线上服务。
物流路由场景
物流公司需要根据订单的重量、体积、目的地、时效要求等因素,自动选择最优的物流渠道,规则引擎可以配置复杂的优先级逻辑,如“优先选择顺丰,若顺丰无货则选择京东”,实现自动化路由决策。
如何落地规则引擎解析数据
对于企业而言,引入规则引擎并非一蹴而就,需要遵循科学的实施路径。
第一步:梳理业务规则
不要急于选型工具,首先要梳理清楚现有的业务逻辑,将分散在代码、文档、口头沟通中的规则提取出来,形成结构化的规则清单,明确规则的输入、输出、优先级和互斥关系。
第二步:选择合适的引擎
目前市面上主流的规则引擎包括Drools、Easy Rules、Aviator等,选择时需考虑以下因素:
- 性能:是否支持高并发、低延迟的执行。
- 易用性:是否提供可视化的规则配置界面,是否支持业务人员直接操作。
- 集成性:是否易于与现有的Spring Boot、微服务架构集成。
- 社区支持:是否有活跃的社区和完善的文档,便于问题解决。
第三步:数据模型设计
设计清晰、规范的数据模型是规则引擎高效运行的基础,避免使用过于复杂的对象结构,尽量扁平化数据,减少规则引擎解析数据的负担。
第四步:规则开发与测试
在开发过程中,应遵循“单一职责”原则,将复杂的规则拆分为多个小的、可复用的规则片段,建立完善的测试用例,覆盖正常场景、边界场景和异常场景,确保规则的准确性和鲁棒性。
第五步:监控与优化
上线后,持续监控规则的执行情况,包括执行耗时、命中率、错误率等指标,根据业务反馈和数据变化,不断优化规则逻辑,提升系统性能。
规则引擎解析数据的常见误区
规则引擎能解决所有问题
规则引擎擅长处理逻辑判断和流程控制,但不擅长处理复杂的数学计算或机器学习模型,对于需要高精度预测的场景,应结合AI模型,规则引擎仅作为模型结果的执行器。
规则越多越好
规则数量过多会导致系统性能下降,维护成本增加,应定期清理无效规则,合并相似规则,保持规则集的简洁和高效。
忽视数据质量
规则引擎的执行效果高度依赖于输入数据的质量,如果输入数据存在大量错误或不一致,规则引擎也无法输出正确的结果,数据治理是规则引擎落地的重要前提。
Q&A:规则引擎解析数据常见问题
规则引擎解析数据的价格大概是多少?
规则引擎的价格因厂商、功能模块、部署方式(开源或商业版)以及授权规模而异,开源引擎如Drools免费,但需要自行投入人力进行维护和二次开发,隐性成本较高,商业引擎通常采用按节点或按并发量收费的模式,价格从几万元到几十万元不等,对于中小型企业,选择成熟的云服务或轻量级开源方案往往更具性价比,而大型金融机构则更倾向于购买具备高可用性和技术支持的商业版引擎。
规则引擎解析数据与硬编码相比有哪些具体优势?
核心优势体现在敏捷性和可维护性上,硬编码将业务逻辑与代码紧密耦合,修改规则需重启服务,风险高且周期长,规则引擎将逻辑外置,支持热加载,业务人员可直接配置,无需开发人员介入,规则引擎提供可视化的管理界面,便于审计和追溯,而硬编码的逻辑往往隐藏在代码深处,难以直观理解。
规则引擎解析数据在实时性上能否满足高并发场景?
主流规则引擎经过优化,完全能够满足高并发实时场景的需求,Drools通过KIE Server提供集群支持,结合内存计算和规则缓存技术,可实现毫秒级的规则匹配速度,在实际应用中,如电商秒杀、金融交易风控等场景,规则引擎均能稳定支撑每秒数万次的请求,关键在于合理设计数据模型和规则结构,避免在规则中执行耗时操作,如频繁访问数据库或调用外部接口。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/459547.html