

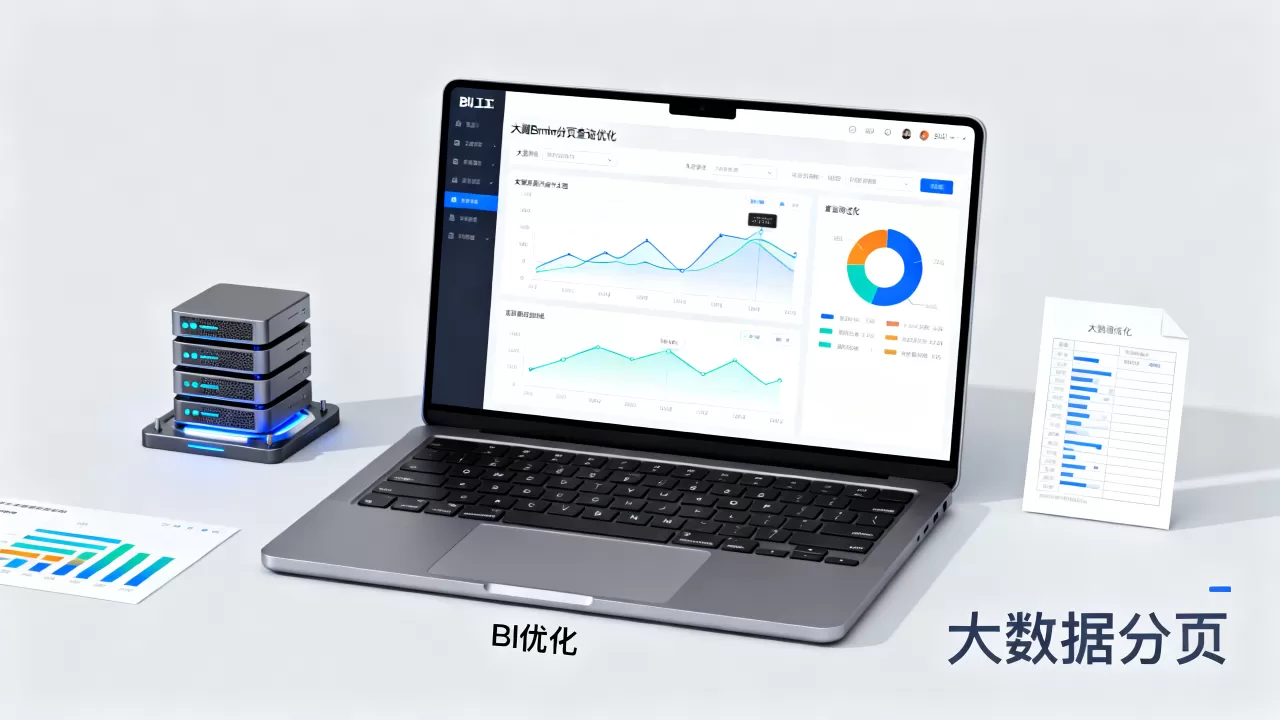
在BI与大数据场景下,大Bitmap分页查询的核心解法是采用“位图索引+布隆过滤器预筛选+分批位运算”的组合策略,通过减少内存峰值和I/O次数,实现亿级数据毫秒级分页响应。
当数据量突破千万甚至亿级时,传统的数据库分页机制(如MySQL的LIMIT offset, size)会因深翻页导致性能急剧下降,Bitmap(位图)技术利用位运算的高效性,成为解决这一痛点的关键,它不直接存储数据,而是存储数据存在的“位置标记”,将复杂的数据过滤转化为极速的位逻辑运算。
大Bitmap分页查询的技术原理与优势
在构建高效BI查询引擎时,理解Bitmap的底层逻辑是第一步,Bitmap本质上是一个二进制数组,每一位代表一个数据ID是否存在,对于分页查询而言,其核心价值在于将“数据读取”转化为“位运算”。
传统分页与Bitmap分页的性能对比
业内专家指出,传统关系型数据库在处理深翻页时,需要扫描大量无关数据并丢弃,造成巨大的CPU和I/O浪费,相比之下,Bitmap分页具有以下显著优势:
- 极速过滤:位与(AND)、位或(OR)、位非(NOT)操作在CPU层面仅需几个时钟周期,比行级扫描快数个数量级。
- 内存友好:经过压缩的Bitmap(如Roaring Bitmap)占用空间极小,可完全加载至内存,避免磁盘IO瓶颈。
- 聚合高效:多条件组合查询(如“男性且年龄25-30且城市北京”)只需对多个Bitmap进行位运算,无需多次JOIN。
核心数据结构选型
并非所有Bitmap都适合生产环境,常见的实现方式包括:
基础Bitmap
使用长整型数组表示,简单但稀疏时浪费严重,适合ID连续且密集的场景。
Roaring Bitmap
当前行业共识认为,Roaring Bitmap是最佳实践,它采用容器混合策略:
– 当容器内数据密集时,使用位图容器。
– 当数据稀疏时,使用列表容器。
– 当数据分布均匀时,使用整数数组容器。
这种动态切换机制,使其在压缩率和运算速度上达到平衡。
大Bitmap分页查询的实操实现路径
在实际BI系统中,如何实现大Bitmap的分页查询?关键在于将查询拆解为“预筛选”、“位运算”、“结果排序”和“分页截取”四个步骤。
第一步:布隆过滤器预筛选
直接对亿级Bitmap进行运算仍可能产生较大开销,引入布隆过滤器(Bloom Filter)作为第一道防线,可以快速排除明显不满足条件的数据块。
- 构建布隆过滤器,记录所有可能涉及的ID哈希值。
- 查询时,先检查布隆过滤器,若返回“不存在”,则直接返回空结果。
- 若返回“可能存在”,再进入Bitmap精确计算阶段。
这一步虽不能保证100%准确,但能过滤掉大量无效查询,显著降低后续计算压力。
第二步:多维条件位运算
假设我们需要查询“2026年注册且消费超过1000元的用户”,并支持分页。
- 加载位图:从内存或缓存中加载“2026年注册”的Bitmap A和“消费超过1000元”的Bitmap B。
- 执行位运算:计算 C = A AND B,结果C即为满足所有条件的用户ID集合。
- 获取ID列表:将Bitmap C转换为ID列表,列表可能包含数百万个ID,尚未排序。
第三步:排序与分页截取
这是分页查询中最容易出错的环节,Bitmap本身是无序的,必须根据业务需求(如注册时间、消费金额)对ID进行排序。
避免深翻页的性能陷阱
若直接对全量结果排序后取OFFSET=1000000, LIMIT=10,性能依然堪忧,优化策略如下:
- 小分页(Offset < 10000):直接对Bitmap转换后的ID列表进行排序,截取前10条。
- 大分页(Offset > 10000):采用“分批位运算+合并排序”策略。
- 将ID范围划分为多个块(如每块10万ID)。
- 对每个块执行位运算,获取该块内的满足条件的ID。
- 使用外部排序或堆排序,仅保留前N+K个ID(N为OFFSET,K为LIMIT)。
- 丢弃多余数据,返回最终结果。
大Bitmap分页查询在BI场景中的应用挑战
尽管技术优势明显,但在实际落地中,企业常面临数据更新、内存管理和查询复杂度等挑战。
数据实时更新的难题
Bitmap是静态数据结构,不支持高效的单点删除或修改,当用户数据发生变化(如用户注销、信息修改)时,全量重建Bitmap成本极高。
- 解决方案:采用“增量更新+定期合并”策略。
- 每日生成增量Bitmap,记录当日新增和删除的ID。
- 凌晨低峰期,将增量Bitmap与主Bitmap进行位运算合并,生成新的主Bitmap。
- 对于高频实时场景,可结合LSM-Tree结构,将Bitmap作为值类型存储,利用其合并特性实现近似实时查询。
内存溢出的风险控制
亿级ID的Roaring Bitmap压缩后约占用数百MB至数GB内存,若同时执行多个复杂查询,极易导致OOM(内存溢出)。
- 解决方案:
- 内存池管理:为Bitmap分配固定大小的内存池,超出部分自动交换至磁盘。
- 查询队列限流:设置并发查询上限,避免瞬时高负载。
-
分片存储:将ID按哈希分片,不同分片存储在不同节点,查询时并行计算后合并结果。
大Bitmap分页查询的选型与成本考量
企业在引入Bitmap技术时,常关注其部署成本和运维复杂度。
自建 vs 云服务
自建方案
使用ClickHouse、Druid或自研引擎,优势是灵活可控,适合数据敏感型企业,劣势是运维成本高,需自行优化压缩算法和查询计划。
云服务方案
利用阿里云AnalyticDB、腾讯云StarRocks等托管服务,优势是开箱即用,自动处理分片和压缩,劣势是数据导出受限,长期存储成本可能较高。
价格与性能平衡
据工信部数据,近年来云数据库成本逐年下降,但计算资源仍是主要支出,对于日均查询量超过百万次的BI系统,建议采用“冷热分离”架构:
- 热数据(近3个月):使用内存Bitmap,保证毫秒级响应。
- 冷数据(3个月以上):使用磁盘索引,查询时按需加载。
常见问题解答
大Bitmap分页查询适合哪些数据量级?
业内共识认为,当数据量超过千万级,且查询条件涉及多字段组合过滤时,Bitmap技术优势显著,对于百万级以下数据,传统数据库索引可能更简单高效。
如何处理Bitmap中的ID去重问题?
Roaring Bitmap本身具备去重特性,同一ID多次添加不会产生重复位,在位运算合并时,也天然保证结果唯一,无需额外去重步骤。
大Bitmap分页查询的查询延迟通常是多少?
在内存充足、数据压缩良好的情况下,亿级数据的多条件过滤+分页查询延迟可控制在100毫秒以内,若涉及磁盘IO或复杂排序,延迟可能上升至秒级,需通过优化索引和查询计划来降低。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/458590.html





评论列表(1条)
卧槽,深翻页那坑我踩过,位图索引听着玄乎但感觉对!受教了学到不少