Hive行式存储主要适用于需要频繁检索单行完整数据的场景,如用户画像查询或日志详情查看,但在大规模数据聚合分析中,列式存储才是性能更优的选择。
在大数据生态系统的演进过程中,存储格式的选择直接决定了查询效率与资源消耗,很多初学者容易混淆Hive中不同存储格式的应用边界,往往在需要全表扫描聚合时误用了行式存储,导致任务运行缓慢甚至超时,理解行式存储(Row-based Storage)的本质,是优化Hive数据仓库架构的第一步。


行式存储的核心机制与底层逻辑
数据排列的物理特性
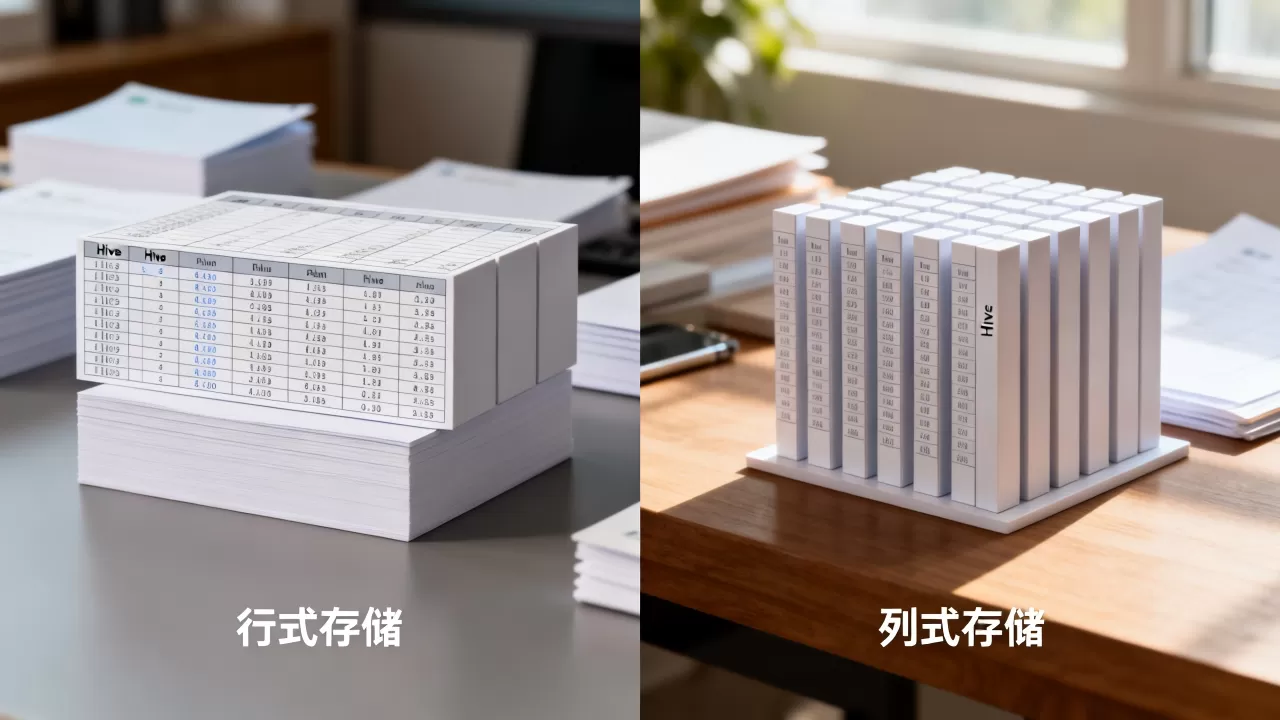
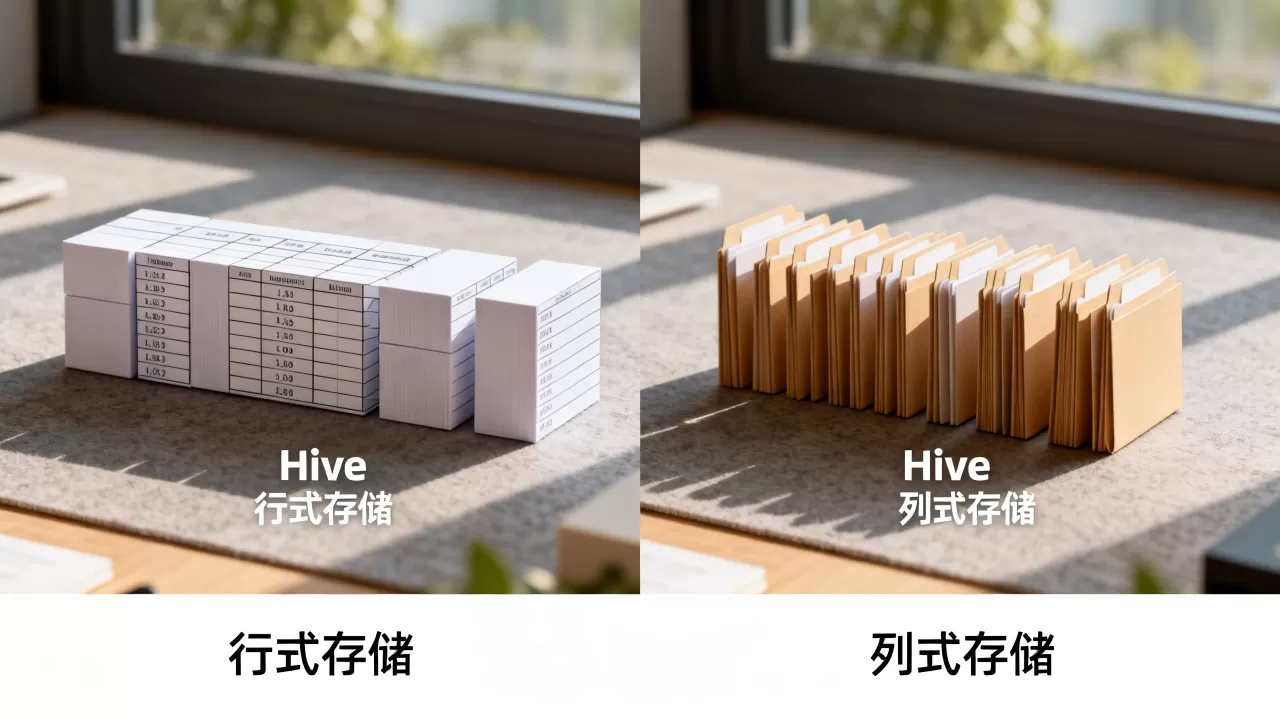
行式存储的设计理念非常直观,它按照行的顺序将数据连续存储在磁盘上,想象一下传统的Excel表格,每一行代表一条完整的记录,包含该记录的所有字段,在Hive中,如果使用TextFile或SequenceFile等默认行式格式,当HDFS读取一条记录时,会一次性将该记录的所有列数据加载到内存中。
这种机制带来了两个显著特点:
- 写入速度快:因为不需要复杂的列索引构建,数据可以流式写入,非常适合高并发的实时数据接入场景。
- 单行查询友好:如果业务需求是获取某个特定用户ID(user_id)的所有详细信息(姓名、年龄、地址、电话等),行式存储只需读取一次磁盘块即可返回完整结果,无需跨列拼接。
与列式存储的本质差异
业内专家指出,行式存储与列式存储(如ORC、Parquet)的根本区别在于数据在磁盘上的组织方式,列式存储将同一列的数据连续存放,不同列的数据分散存储。
为了更清晰地对比,我们可以通过以下场景分析:
统计平均薪资
假设有一张包含1亿条员工记录的大表,字段包括ID、姓名、部门、入职日期、薪资、绩效等。
- 行式存储做法:Hive需要读取每一行的所有字段,即使你只关心“薪资”这一列,这意味着大量的无用数据(姓名、日期等)被读取并传输到Reduce节点,造成极大的I/O浪费。
-
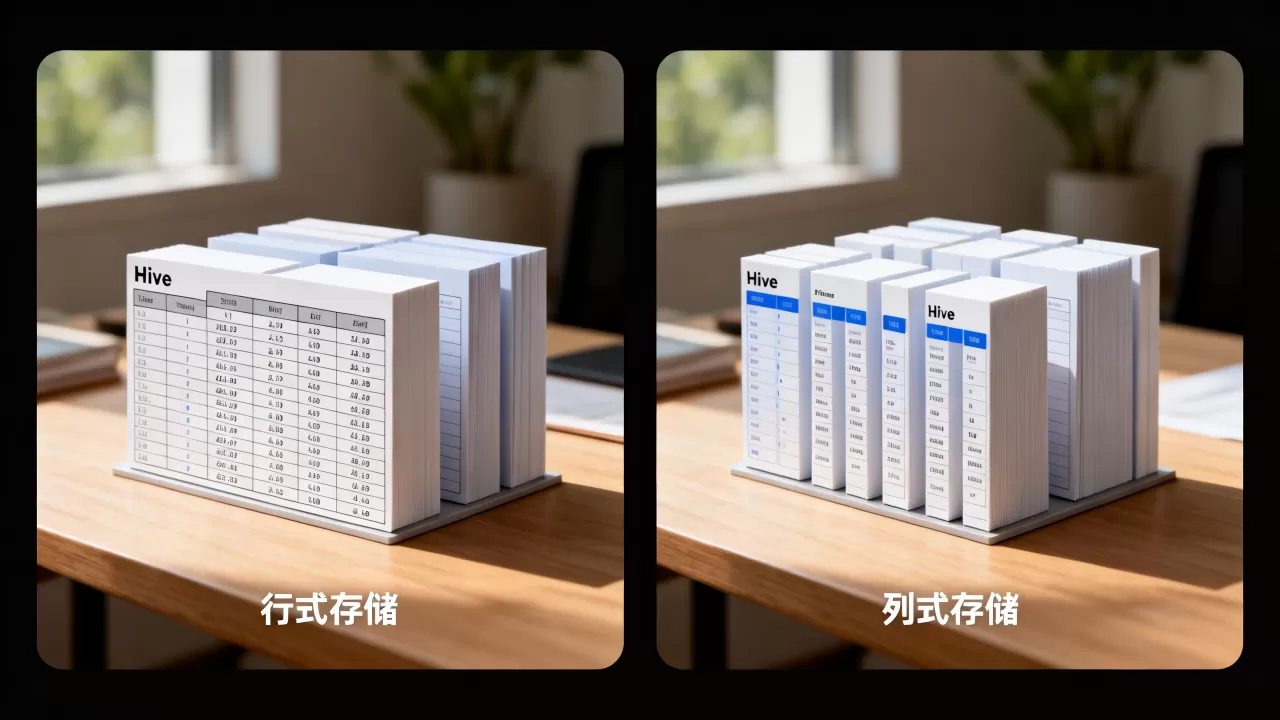
列式存储做法:Hive只读取“薪资”这一列的数据,忽略其他所有列,这不仅减少了磁盘I/O,还能利用列数据的重复性进行高效压缩。
条件过滤查询
当执行SELECT FROM employees WHERE department = 'IT'时:
- 行式存储:必须加载整行数据到内存,然后在内存中判断department字段是否匹配。
- 列式存储:可以直接定位到department列的数据块,利用谓词下推(Predicate Pushdown)技术,在读取阶段就过滤掉非IT部门的数据,大幅减少后续计算量。
Hive行式存储的典型应用场景
尽管在OLAP(联机分析处理)场景中列式存储占据主导地位,但行式存储并未被淘汰,它在特定领域依然具有不可替代的价值。
高频单点查询需求
如果你的业务系统需要频繁根据主键查询单条记录的完整信息,例如电商系统中的“订单详情查询”或社交网络中的“用户个人资料页”,行式存储是更合适的选择。
在这种场景下,查询往往涉及全字段返回,使用行式存储可以避免列式存储在读取少量列时产生的额外开销,对于小数据量的维表(Dimension Table),行式存储的查询延迟通常更低,因为不需要复杂的列解码过程。
数据写入密集型任务
在数据湖架构中,原始数据(Raw Data)通常以行式格式(如JSON、CSV或TextFile)落地,这是因为:
- 兼容性高:行式格式对Schema变更的容忍度较高,新增字段不会破坏原有数据的读取。
- 写入性能极致:对于Kafka等消息队列接入的数据,行式存储能够实现毫秒级的写入延迟,确保数据不丢失。
混合负载中的临时表
在ETL流程中,中间临时表(Staging Tables)通常使用行式存储,这些表数据量巨大但生命周期短,主要用于数据清洗和转换,由于后续步骤通常会将其转换为列式存储格式以进行最终分析,因此在中间环节使用行式存储可以节省转换成本,提高整体流水线效率。
性能优化与选型建议
在实际生产环境中,盲目选择存储格式会导致资源浪费,以下是基于行业共识的选型指南。
何时选择行式存储
- 数据量较小:当表数据量在百万级以下,且查询频率不高时,行式存储的简单结构足以应对。
- 全字段查询为主:绝大多数查询都需要返回表中所有或大部分列。
- 高并发写入:需要支持每秒数千次的插入操作,且对写入延迟极其敏感。
何时避免使用行式存储
- 大规模聚合分析:涉及SUM、AVG、COUNT等聚合函数,且数据量达到亿级。
- 列裁剪场景:查询只涉及表中少数几个列,但表包含数十个甚至上百个列。
- 存储成本敏感:需要大幅压缩存储空间以降低成本,行式存储的压缩率通常低于列式存储。
优化技巧:结合索引与分区
如果必须使用行式存储,可以通过以下手段提升性能:
- 分区裁剪:确保查询条件中包含分区字段,减少扫描的数据块数量。
- 桶表(Bucketing):对常用查询字段进行分桶,利用Map-side Join或分桶抽样加速查询。
- 索引表:为高频查询字段创建Hive索引表,虽然维护成本高,但在特定场景下能显著加速定位。
常见误区与实战避坑
行式存储完全不支持压缩
这是一个常见的误解,Hive的行式存储(如TextFile)支持多种压缩算法,如GZIP、Snappy等,由于行式存储中不同行的数据结构相似但内容差异大,压缩率通常不如列式存储高,某些压缩格式(如GZIP)不支持切片(Split),会导致MapReduce任务无法并行化,从而降低查询效率,若使用行式存储,建议优先选择支持切片的压缩格式,如Snappy。
行式存储查询速度慢于列式存储
这个结论过于绝对,在单行全字段查询场景下,行式存储往往比列式存储更快,因为列式存储需要解码多个列的数据块并拼接,而行式存储只需读取一个连续的数据块,不要一概而论地认为行式存储就是“慢”,关键要看查询模式(Query Pattern)。
所有Hive表都适合转换为列式存储
虽然ORC和Parquet是主流选择,但转换过程需要消耗计算资源,对于频繁更新(Update/Delete)的表,列式存储的重写成本较高,Hive对列式存储的更新支持有限,通常采用“删除+插入”的方式实现,这在行式存储中更容易实现,对于需要频繁小批量更新的表,行式存储可能更合适。
Q&A:关于Hive行式存储的常见问题
Hive行式存储与列式存储哪个更省钱?
从存储成本来看,列式存储(如ORC、Parquet)通常具有更高的压缩率,能节省30%-70%的存储空间,因此在存储费用上更省钱,但从计算成本来看,如果查询模式是全字段扫描,行式存储可能减少CPU和内存消耗,从而降低计算资源费用,综合来看,对于分析型数据仓库,列式存储因减少I/O而整体成本更低;对于日志类或高频写入场景,行式存储因写入效率高而更具性价比。
如何在Hive中将行式存储转换为列式存储?
可以通过创建新表并插入数据的方式实现转换,首先创建目标列式存储表,CREATE TABLE target_table STORED AS ORC AS SELECT FROM source_row_table;
执行该命令后,Hive会读取源表的所有数据,并按照ORC格式写入新表,这个过程是计算密集的,建议在业务低峰期执行,并确保集群有足够的资源,转换完成后,可以删除源表或将其重命名为备份表。
行式存储是否支持向量化查询?
Hive的向量化执行引擎(Vectorized Execution Engine)主要针对列式存储格式进行了优化,能够批量处理数据列,显著提升聚合查询速度,对于行式存储,虽然Hive也支持一定的向量化优化,但效果远不如列式存储明显,因为行式存储在内存中是非连续存储的,CPU缓存命中率较低,难以发挥SIMD(单指令多数据流)指令集的优势,若追求极致查询性能,建议将行式数据转换为列式存储。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/457226.html