Hadoop大数据系统架构的核心在于通过HDFS实现分布式存储,利用YARN进行资源调度,并借助MapReduce或Spark等计算框架处理海量数据,从而构建高容错、高扩展性的企业级数据底座。
在2026年的今天,谈论Hadoop已经不再是讨论“要不要用”,而是“如何用好”,尽管云原生和实时计算引擎如Flink、Spark Streaming日益流行,但Hadoop生态依然是离线批处理、数据湖仓一体化以及冷热数据分层的基石,它不仅仅是一套软件,更是一种处理PB级甚至EB级数据的哲学。
Hadoop核心组件的深度解析
Hadoop并非单一工具,而是一个由多个模块组成的生态系统,理解其架构,首先要拆解其三大支柱:存储、计算与资源管理。
HDFS:分布式文件系统的基石
HDFS(Hadoop Distributed File System)是Hadoop的存储层,业内专家指出,HDFS的设计初衷是为了解决单机存储容量有限和可靠性不足的问题,它采用“一次写入,多次读取”的模式,非常适合大数据分析场景。
HDFS的核心架构包括NameNode和DataNode:
- NameNode:负责管理文件系统的元数据,如文件目录树、文件到数据块的映射关系等,它是HDFS的“大脑”,但也是单点故障的风险点(尽管通过HA机制已解决)。
- DataNode:实际存储数据块的节点,它定期向NameNode发送心跳和块报告,确保数据的健康状态。
数据块机制与副本策略
为了提高吞吐量和容错性,HDFS将大文件切分为固定大小的数据块(默认128MB或256MB),每个数据块默认存储3个副本,分别位于不同机架的不同节点上,这种“机架感知”策略确保了即使整个机架断电,数据依然可用。
YARN:资源调度的中枢
早期的Hadoop版本将MapReduce既作为计算框架,又作为资源管理器,导致耦合严重,YARN(Yet Another Resource Negotiator)的出现实现了资源管理与计算框架的解耦。
YARN的核心组件包括:
- ResourceManager:全局资源管理者,负责分配资源给各个应用。
- NodeManager:单个节点上的资源管理者,负责启动和监控容器(Container)。
- ApplicationMaster:每个应用的负责人,负责向ResourceManager申请资源,并与NodeManager通信以执行任务。
这种架构使得Hadoop不仅可以运行MapReduce,还可以轻松支持Spark、Tez、Flink等多种计算引擎,极大地提升了生态的灵活性。
Hadoop在2026年的应用场景与对比优势
在云计算和大数据技术飞速发展的背景下,Hadoop的定位发生了微妙变化,许多企业在选型时,会纠结于“Hadoop vs 云数据仓库”或“Hadoop vs 实时流处理”。
Hadoop与传统数据仓库的对比
传统数据仓库(如Oracle、Teradata)擅长结构化数据的复杂查询和事务处理,但扩展性差、成本高,Hadoop则擅长处理非结构化、半结构化数据,且基于廉价硬件,扩展性极强。
| 特性 | Hadoop (HDFS) | 传统数据仓库 |
|---|---|---|
| 数据类型 | 结构化、非结构化、半结构化 | 主要是结构化数据 |
| 扩展性 | 水平扩展,支持千节点集群 | 垂直扩展为主,扩展受限 |
| 成本 | 低,基于通用硬件 | 高,依赖专用硬件 |
| 查询延迟 | 高延迟,适合批处理 | 低延迟,适合交互式查询 |
| 数据一致性 | 最终一致性 | 强一致性 |
据工信部数据显示,近年来超过半数的大型互联网企业和金融机构仍在使用Hadoop作为数据湖的底层存储,用于原始数据的沉淀和离线分析。
Hadoop与实时计算引擎的关系
很多人误以为Hadoop只适合离线批处理,Hadoop生态中的Spark和Hive-on-Tez已经大大提升了查询速度,但在2026年,对于毫秒级响应的实时场景,Flink等流处理引擎更为合适,Hadoop的角色逐渐转变为“实时数据的热数据层”或“历史数据的归档层”。
数据湖仓一体化的实践
Hadoop HDFS是构建数据湖的理想选择,通过引入Iceberg、Hudi或Delta Lake等表格格式,Hadoop可以支持ACID事务、时间旅行和数据更新,从而弥补传统HDFS在数据管理上的不足,这种“湖仓一体”架构已成为行业共识认为的未来趋势。
Hadoop集群运维与最佳实践
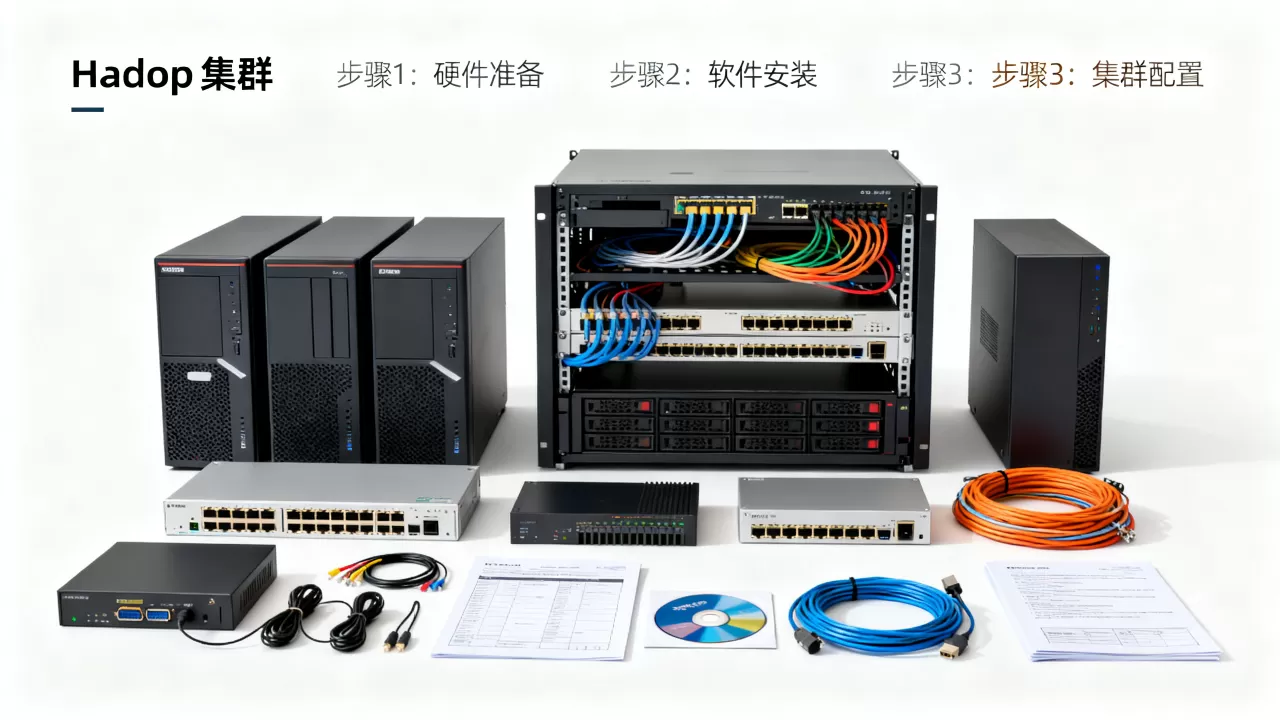
搭建Hadoop集群容易,但稳定运行并发挥其性能则极具挑战,以下是几个关键的运维要点。
硬件选型与网络优化
- 磁盘:建议使用大容量机械硬盘(HDD)存储数据,使用固态硬盘(SSD)存储元数据(NameNode)或作为缓存层。
- 网络:确保节点间网络带宽充足,避免网络成为瓶颈,机架感知配置必须准确,以优化数据本地性。
容量规划与扩容策略
Hadoop的优势在于线性扩展,在规划集群时,应预留至少20%-30%的剩余空间,以应对数据倾斜和副本复制,扩容时,只需添加新的DataNode和NodeManager节点,并修改配置文件即可,无需停机。
监控与故障排查
实时监控是保障集群稳定运行的关键,常用的监控工具包括:
- Hadoop Web UI:提供集群状态、任务进度等基本信息。
- Ambari / Cloudera Manager:提供图形化的集群管理、告警和自动化运维功能。
- Prometheus + Grafana:用于自定义指标监控和可视化展示。
当出现任务失败时,应首先查看日志,MapReduce任务的日志位于/var/log/hadoop-mapreduce,Spark任务的日志可通过Spark UI查看,常见的错误包括数据倾斜、内存溢出(OOM)和磁盘故障。
Hadoop大数据系统架构常见问题解答
2026年Hadoop是否会被完全取代?
不会,虽然云原生数据湖和分析引擎正在兴起,但Hadoop的分布式存储理念(HDFS)和资源调度理念(YARN)已被广泛吸收,Hadoop正在向云原生化、轻量化方向发展,成为混合云架构中的重要组成部分,特别是在需要数据主权和私有化部署的场景中。
Hadoop与Spark如何选择?
Spark是运行在YARN(或Standalone)之上的计算引擎,而非Hadoop的替代品,如果你需要处理大规模离线数据,且对迭代计算或交互式查询有需求,Spark是比MapReduce更好的选择,Hadoop提供存储和资源管理,Spark提供计算,二者是互补关系。
Hadoop集群的维护成本如何?
自建Hadoop集群的运维成本较高,需要专业的DBA和运维团队,对于中小型企业,建议使用云厂商提供的托管Hadoop服务(如AWS EMR、阿里云EMR),这些服务自动处理故障转移、扩容和补丁更新,显著降低了运维门槛,据行业统计,使用托管服务可将运维人力成本降低约40%。
Hadoop大数据系统架构并未过时,而是在不断进化,它从单纯的离线批处理平台,演变为支持多计算引擎、多数据格式、多场景应用的通用数据底座,对于2026年的企业而言,关键在于如何结合云原生技术,将Hadoop融入更灵活、更智能的数据架构中,以释放数据的真正价值。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/455462.html