Python中的SVD++算法通过引入隐式反馈机制,显著提升了推荐系统的准确率,尤其适用于电商、视频等用户行为稀疏的场景,其核心优势在于能挖掘用户未显式评分但实际消费的内容偏好。
在推荐系统领域,协同过滤一直是基石技术,但传统的矩阵分解方法往往忽略了用户“没做什么”背后的信息,SVD++正是为了解决这一痛点而生,它由Netflix Prize冠军团队提出,不仅利用了显式的评分数据,还巧妙地将隐式反馈融入模型,从而在数据稀疏性问题上取得了突破性进展,对于正在寻找高效推荐算法解决方案的开发者来说,掌握SVD++的实现细节至关重要。
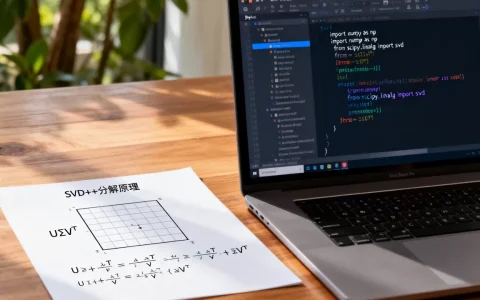
深入理解SVD++的核心机制与原理
要真正用好这个算法,不能只把它当作一个黑盒工具,理解其背后的数学逻辑,能帮助你在面对复杂业务场景时做出更精准的调优决策,业内专家指出,SVD++的本质是对传统SVD模型的扩展,它通过增加一个用户隐式反馈的偏置项,来捕捉用户潜在的偏好。
显式反馈与隐式反馈的区别
在传统的矩阵分解中,我们主要关注用户给出的明确评分,比如电影评分1到5分,在现实世界中,大部分数据是隐式的,你在抖音刷了100个视频,只点赞了3个,这3个赞是显式反馈,而剩下的97个视频虽然没点赞,但你看完的行为本身就是一种隐式反馈,暗示你对这些内容有一定兴趣或至少不反感,SVD++的关键创新就在于它把这种“看完”、“点击”、“浏览时长”等隐式行为也转化为了模型可学习的特征。
数学模型的直观解读
SVD++的公式看似复杂,但逻辑很清晰,它假设用户的最终偏好由两部分组成:一是用户自身的固有偏好,二是物品本身的属性,更重要的是,它引入了一个集合$N_u$,代表用户$u$产生过隐式反馈的物品集合,在计算用户偏置时,不仅考虑了用户的历史评分,还叠加了这些隐式反馈物品的潜在向量,这意味着,即使用户没有打分,模型也能通过他浏览过的物品,推测出他可能的口味,这种机制极大地缓解了数据稀疏问题,特别是在新用户或新物品加入系统时,效果尤为明显。
Python实战:使用Surprise库实现SVD++
对于大多数开发者而言,从零手写SVD++的矩阵分解代码既耗时又容易出错,业界最主流且稳定的做法是使用Python的推荐系统库Surprise,它封装了底层复杂的线性代数运算,提供了简洁的API,让你能迅速将算法应用到实际数据中。
环境搭建与数据准备
你需要安装必要的依赖库,在终端中执行以下命令是最基础的一步:
pip install surprise numpy pandas
数据准备阶段,建议将原始日志数据清洗为标准的三元组格式:(用户ID, 物品ID, 评分),如果只有隐式反馈数据,如点击或浏览,通常需要将行为转化为置信度评分,或者直接使用二值化的0/1表示是否发生行为,一个电商数据集可能包含用户ID、商品ID和购买次数,你可以将购买次数归一化后作为评分输入。
核心代码实现路径
以下是使用Surprise库构建SVD++模型的典型流程,这段代码展示了如何加载数据、定义模型、进行交叉验证并评估效果。
from surprise import Dataset, Reader, SVDpp
from surprise.model_selection import cross_validate
# 1. 加载数据,指定分隔符和评分范围
reader = Reader(rating_scale=(1, 5))
data = Dataset.load_from_file('user_item_ratings.csv', reader=reader)
# 2. 初始化SVD++模型
# n_factors: 潜在因子数量,通常设为50-200
# n_epochs: 迭代次数,越多越准但越慢
# lr_all: 学习率,控制更新速度
# reg_all: 正则化参数,防止过拟合
algo = SVDpp(n_factors=100, n_epochs=20, lr_all=0.005, reg_all=0.02)
# 3. 执行交叉验证
# 使用RMSE(均方根误差)作为评估指标
cross_validate(algo, data, measures=['RMSE', 'MAE'], cv=5, verbose=True)
在这段代码中,n_factors是一个关键超参数,它决定了潜在向量的维度,维度太低可能导致模型欠拟合,无法捕捉复杂模式;维度太高则容易过拟合,且在大规模数据上训练成本极高,通常建议从50开始尝试,逐步增加到200,观察验证集上的RMSE变化。
SVD++与其他推荐算法的对比分析
在选择算法时,盲目追求最新或最复杂的技术往往不是最佳策略,SVD++有其特定的适用场景和局限性,通过对比,你可以更清晰地定位它在技术栈中的位置。
SVD++ vs 传统SVD
传统SVD仅利用显式评分矩阵,在数据稀疏时性能急剧下降,而SVD++通过引入隐式反馈,在相同数据量下通常能获得更低的预测误差,特别是在用户行为数据远多于显式评分数据的场景中,SVD++的优势巨大,SVD++的计算复杂度略高于传统SVD,因为它需要额外处理隐式反馈集合,如果数据非常稠密,即每个用户都对大量物品进行了评分,传统SVD的性能可能与SVD++相差无几,此时选择计算更快的传统SVD更为划算。
SVD++ vs 基于深度学习的模型
近年来,基于神经网络的推荐模型如NeuMF、DIN等备受关注,这些模型擅长捕捉高阶非线性特征,但在数据量不足或解释性要求高的场景下,SVD++依然具有不可替代的价值,SVD++模型结构简单,训练速度快,且结果具有良好的可解释性你可以清晰地看到哪些潜在因子对用户偏好影响最大,对于初创公司或资源有限的团队,SVD++往往是性价比最高的起步方案。
优化策略与常见陷阱规避
即使使用了成熟的库,实际部署中仍会遇到各种挑战,以下是一些经过验证的优化建议,能帮助你将SVD++的效果提升到最佳状态。
冷启动问题的缓解
新用户或新物品没有历史行为数据,SVD++同样面临冷启动,解决思路包括:引入用户画像(如年龄、性别)或物品属性(如类别、品牌)作为额外特征,虽然Surprise库本身不直接支持多模态输入,但你可以通过预处理,将这些属性转化为虚拟的“评分”或偏置项,融入训练数据中。
超参数调优指南
不要依赖默认参数。lr_all(学习率)和reg_all(正则化)是影响模型收敛速度和泛化能力的关键,建议采用网格搜索或随机搜索的方法,在验证集上寻找最优组合,较小的学习率配合较多的迭代次数,能获得更稳定的结果。n_epochs不宜设置过大,一般20-50次迭代即可收敛,过多的迭代只会增加计算时间而收益递减。
Q&A:关于Python SVD++的常见疑问
SVD++在处理大规模稀疏数据时性能如何?
SVD++在稀疏数据上的表现优于传统协同过滤,但随着数据规模呈指数级增长,其计算复杂度也会显著上升,对于千万级用户的数据集,直接使用Surprise库可能会遇到内存或时间瓶颈,业内共识认为,此时应考虑使用Spark MLlib等分布式框架,或采用近似最近邻搜索等加速技术,对于中等规模数据,SVD++依然是平衡精度与效率的优秀选择。
如何评估SVD++模型的最终效果?
除了常用的RMSE和MAE,建议结合业务指标进行评估,在电商场景中,Top-N推荐准确率(Precision@K)和召回率(Recall@K)比单纯的评分预测误差更具业务价值,你可以将模型输出的预测评分排序,选取前N个物品,计算实际购买或点击的比例,这种基于排序的评估更能反映模型在真实推荐场景中的有效性。
SVD++是否支持实时推荐?
标准的SVD++训练过程是批处理的,不适合毫秒级的实时响应,可以通过增量更新策略来近似实现实时性,当新用户产生行为时,可以快速更新其隐式反馈向量,而不必重新训练整个模型,可以将SVD++作为离线训练的基础模型,结合在线学习算法或缓存机制,构建混合推荐系统,从而在保证精度的同时满足实时性要求。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/455050.html