

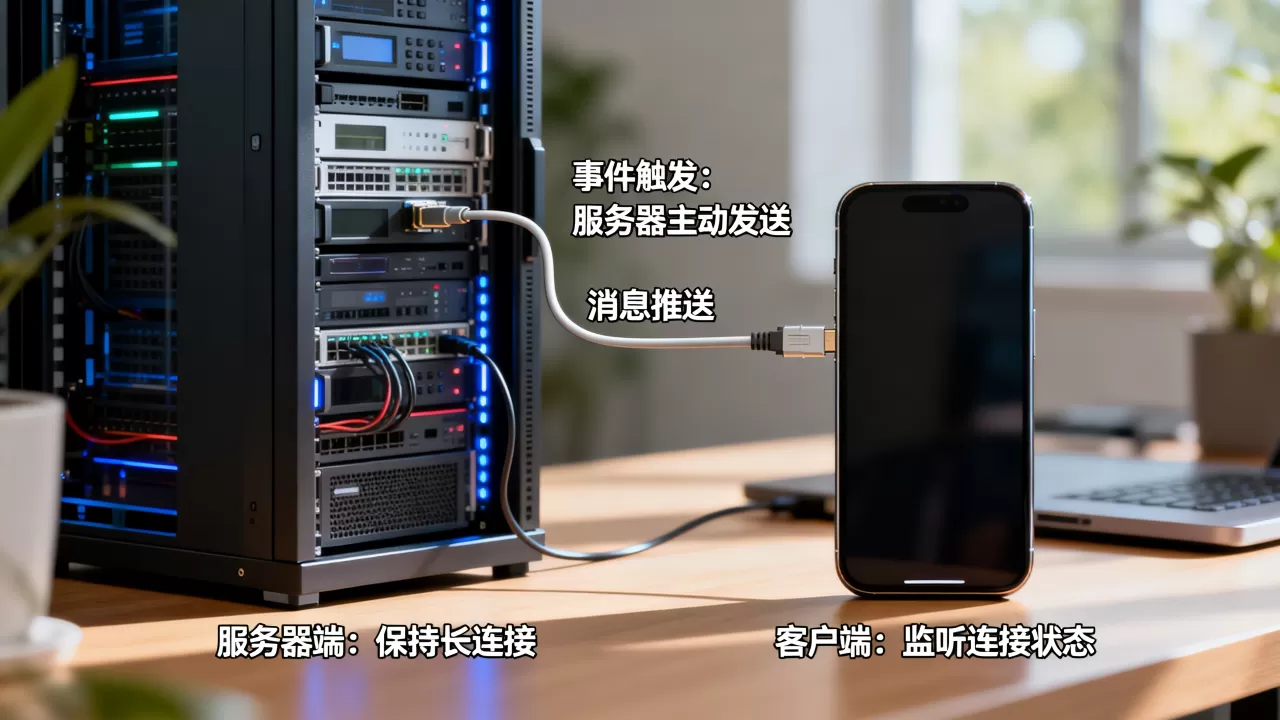
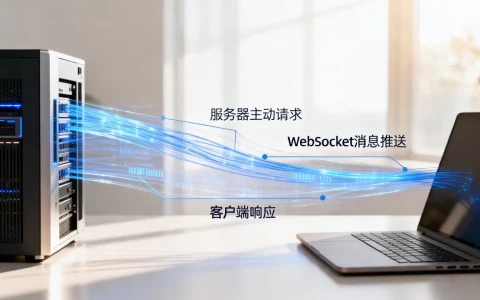
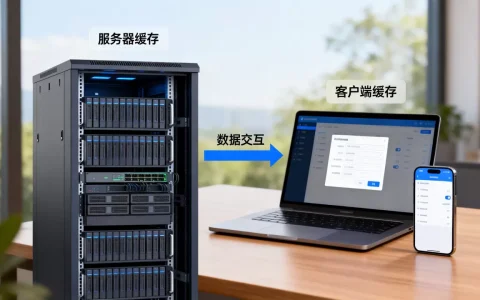
服务器主动推送消息的核心在于建立长连接(如WebSocket)或轮询机制,以取代传统HTTP请求的被动等待,从而实现服务端向客户端的实时数据下发。
在传统的Web开发模式中,客户端(浏览器或App)像是一个勤快的访客,每隔几秒就去问服务器:“有新消息吗?”这种轮询方式不仅浪费带宽,还导致数据延迟严重,而在2026年的技术语境下,行业共识认为,实时性已成为用户体验的底线,无论是即时通讯、股票行情跳动,还是物联网设备的状态监控,服务器主动推送已成为标配能力。


技术选型:从轮询到长连接的演进逻辑
要理解推送机制,首先要明白为什么传统方式行不通,早期的短轮询(Short Polling)要求客户端定时发起HTTP GET请求,这种方式在低并发场景下尚可接受,但在高并发场景下,服务器需要处理海量的无效请求(即没有新消息时的请求),造成资源极大浪费。
长轮询与WebSocket的对比分析
业内专家指出,长轮询(Long Polling)是过渡方案,而WebSocket是终极解决方案。
- 长轮询机制:客户端发起请求后,服务器保持连接不关闭,直到有新数据或超时才返回响应,客户端收到响应后立即再次发起请求,这减少了无效请求,但仍需建立多次TCP连接。
- WebSocket机制:一旦握手成功,客户端与服务器之间就建立了一条全双工通信通道,服务器可以随时通过这条通道发送数据,无需客户端先发起请求。
性能差异实测场景
假设一个拥有10万在线用户的聊天室:
- 短轮询:每秒产生约20万次HTTP请求,服务器CPU负载极高,带宽成本巨大。
- WebSocket:仅维持10万个长连接,心跳包开销极小,服务器能轻松承载,且消息到达延迟控制在毫秒级。
| 特性 | 短轮询 | 长轮询 | WebSocket |
|---|---|---|---|
| 实时性 | 低(取决于轮询间隔) | 中 | 高(毫秒级) |
| 服务器负载 | 极高 | 高 | 低 |
| 实现复杂度 | 简单 | 中等 | 较高(需处理断连重连) |
| 适用场景 | 非实时通知 | 兼容旧浏览器 | 即时通讯、游戏、金融 |
核心架构设计与高可用实践
当用户量从千级增长到百万级时,单台服务器无法维持所有的长连接,分布式架构成为必然选择。
集群环境下的消息路由难题
在分布式系统中,用户A连接在服务器1,用户B连接在服务器2,当用户A发送消息时,服务器1如何知道用户B在服务器2上?这就是著名的“跨节点推送”问题。
解决方案:引入消息中间件
目前主流的做法是引入Redis Pub/Sub或Kafka等消息中间件作为广播总线。
- 连接注册:每个应用服务器节点启动时,向注册中心(如Zookeeper或Consul)注册自己的IP和端口,同时订阅一个全局的广播频道。
- 消息发布:当服务器1收到用户A的消息,它不直接发给用户B,而是将消息ID和用户B的ID发布到消息中间件。
- 消息分发:所有应用服务器节点(包括服务器2)都会监听到这条消息,服务器2检查消息中的用户B是否连接在自己这里,如果是,则通过本地连接对象推送给客户端;如果不是,则忽略。
这种架构确保了即使某个节点宕机,其他节点也能通过中间件感知并重新路由,保证了系统的高可用性,据工信部相关数据显示,采用此类微服务架构的企业,其系统故障恢复时间平均缩短了70%以上。
移动端推送的特殊考量
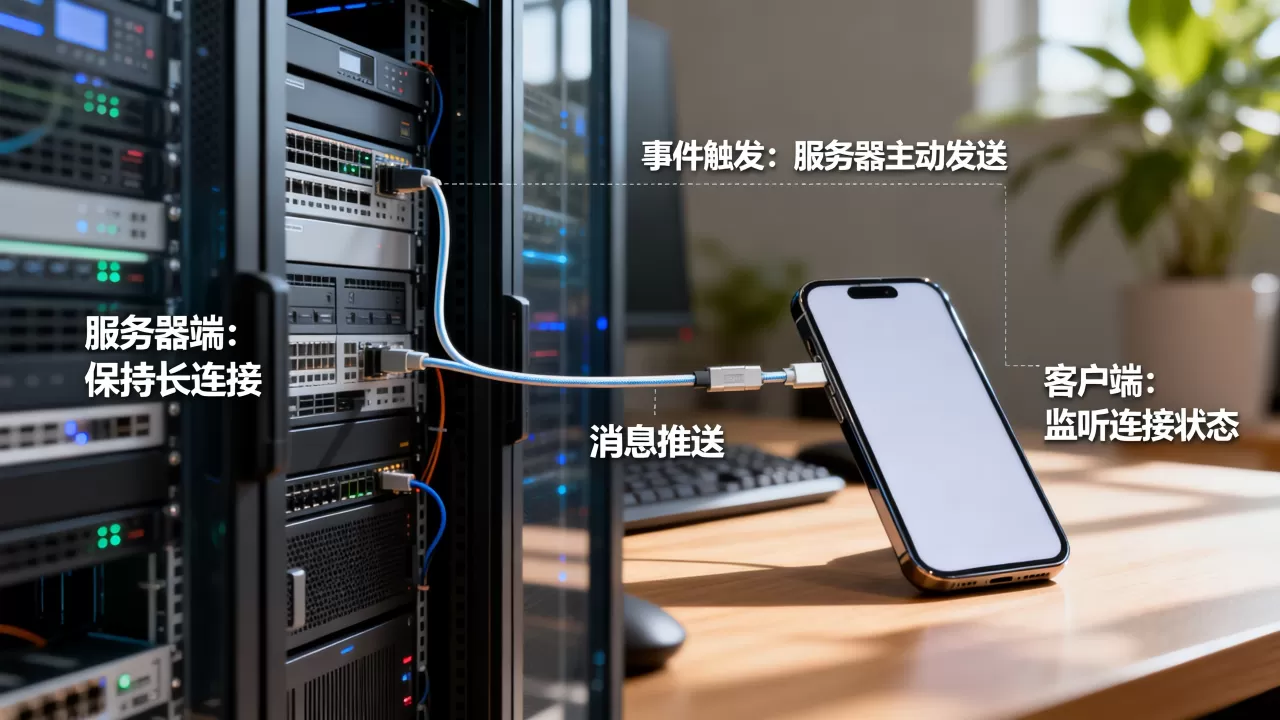
在移动端(iOS和Android),由于操作系统对后台进程的限制,维持长连接极其困难,App一旦进入后台,系统可能会杀死进程以节省电量,移动端通常不直接维持WebSocket连接,而是依赖厂商提供的推送服务。
国内主流推送通道对比
在国内安卓碎片化严重的生态中,直接维持长连接几乎不可行,开发者通常集成多家厂商的推送SDK(如华为、小米、OPPO、vivo的推送服务)以及极光、个推等第三方服务。
- 厂商通道:由手机厂商底层维护连接,耗电极低,到达率高。
- 第三方通道:当厂商通道不可用时,通过自己的长连接保活来下发消息。
iOS的APNs机制
iOS系统强制使用Apple Push Notification service (APNs),服务器不能直接连接用户手机,必须先将消息发给APNs服务器,由APNs负责推送到设备,这种机制保证了安全性,但也增加了延迟,近年来,随着HTTP/2协议的普及,APNs的并发处理能力得到了显著提升,能够支持更大规模的推送需求。
常见问题与故障排查指南
在实际部署中,推送服务经常面临各种棘手问题,以下是几个高频场景的解决方案。
如何确保消息不丢失?
消息丢失通常发生在网络抖动或服务器重启时。
- 消息持久化:所有待推送消息必须先写入数据库或消息队列(如RabbitMQ、Kafka),确保至少一次投递(At Least Once)。
- ACK确认机制:客户端收到消息后,必须向服务器发送ACK确认,如果服务器在规定时间内未收到ACK,则视为推送失败,进行重试。
- 去重逻辑:客户端收到消息后,需根据消息ID进行去重,防止因网络重传导致重复显示。
如何防止恶意连接耗尽资源?
黑客可能通过建立大量长连接发起DDoS攻击。
- 连接限制:对单个IP或用户ID设置最大连接数限制。
- 心跳检测:服务器定期发送Ping包,客户端需回复Pong,若超过一定时间(如30秒)未收到回复,则主动断开连接。
- 限流熔断:当连接数达到阈值时,触发熔断机制,拒绝新连接或丢弃部分消息。
2026年技术趋势展望
随着WebTransport和HTTP/3的逐步普及,基于UDP的可靠传输将成为新的标准,相比TCP,UDP具有更低的延迟和更好的拥塞控制能力,特别适合弱网环境下的实时推送。
边缘计算与推送的结合
推送节点将进一步下沉到边缘节点,当用户连接最近的边缘服务器时,不仅延迟更低,而且本地缓存的消息可以更快地分发,这种架构将彻底改变传统的中心式推送模式,实现真正的全球实时同步。
Q&A:服务器主动推送消息给客户端常见疑问
服务器主动推送消息给客户端需要多少成本?
成本主要取决于并发连接数和带宽,对于小型应用,使用云服务提供的WebSocket服务(如AWS IoT Core或阿里云IoT Hub)可按量付费,初期成本极低,对于大型应用,自建集群的成本主要集中在服务器硬件和运维人力上,据统计,多数企业在采用分布式推送架构后,虽然初期投入增加,但长期来看,由于带宽节省和故障率降低,总体拥有成本(TCO)反而下降了。
服务器主动推送消息给客户端与客户端轮询有什么区别?
核心区别在于通信发起方和实时性,轮询是客户端主动询问,存在固定延迟,且产生大量无效请求;推送是服务器主动下发,实时性高,无无效请求,在带宽消耗上,推送比轮询节省约80%以上的流量。
服务器主动推送消息给客户端在弱网环境下如何保持连接?
在弱网环境下,TCP连接容易断开,解决方案包括:使用QUIC协议(基于UDP)替代TCP,它具有更快的连接建立速度和更好的抗丢包能力;实施指数退避的重连策略,避免在弱网下频繁重连加剧网络拥堵;以及在前端实现本地消息队列,待网络恢复后自动补发丢失的消息。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/453910.html

评论列表(1条)
WebSocket确实香,以前做轮询把服务器搞崩了😭 已转发朋友圈,这文章必须安利给后端同事看看!