Python中并没有名为getelement的标准内置函数,获取网页元素通常需要使用Selenium、BeautifulSoup或Playwright等第三方库,具体选择取决于你是需要解析静态HTML还是操控动态渲染的页面。
在2026年的Web自动化与数据抓取领域,”python getelement”这个搜索词背后,其实隐藏着开发者对DOM元素定位、提取和交互的深层需求,很多初学者会误以为Python像JavaScript那样有原生的getelement方法,但实际上,Python本身只处理逻辑,不直接操作浏览器DOM,你需要借助工具来充当”眼睛”和”手”,去抓取或操控网页上的特定信息,本文将拆解不同场景下的最佳实践,帮你避开常见的坑,找到最适合你项目的方案。
为什么Python原生无法直接获取元素
Python是一种通用的编程语言,它的核心优势在于数据处理、算法逻辑和后端服务,而不是直接渲染或解析网页结构,浏览器(如Chrome、Firefox)负责解释HTML、CSS和JavaScript,并构建DOM树,Python想要”看到”这个DOM树,必须通过中间件与浏览器进行通信。
业内专家指出,直接通过Python标准库urllib或requests获取的只是原始的HTML文本字符串,而非结构化的DOM对象,这意味着你无法直接使用类似document.getElementById这样的命令,你必须引入专门的库来解析这些文本,或者启动一个真实的浏览器实例来执行JavaScript并暴露DOM接口,这种架构分离虽然增加了复杂性,但带来了更高的安全性和灵活性,避免了在浏览器环境中直接运行不可信代码的风险。
静态页面解析:BeautifulSoup的首选地位
如果你的目标网站是静态的,即页面内容在服务器端生成后直接发送给客户端,没有复杂的JavaScript动态加载,那么BeautifulSoup是性价比最高的选择,它不需要启动浏览器,运行速度快,资源占用极低。
获取元素的核心步骤如下:
- 安装库:在终端运行
pip install beautifulsoup4 requests。 - 发起请求:使用requests库获取网页的HTML内容。
- :将HTML字符串传入BeautifulSoup构造函数,指定解析器为
html.parser或lxml。 - 定位元素:使用
find或find_all方法,配合CSS选择器或属性匹配来提取数据。
获取一个ID为”main-content”的div标签,代码逻辑为soup.find('div', id='main-content'),这种方法适合批量抓取新闻列表、博客文章等结构化数据,对于需要处理大规模数据且对实时性要求不高的场景,这种轻量级方案能显著降低服务器成本。
动态页面操控:Selenium与Playwright的较量
依赖JavaScript异步加载,或者需要用户交互(如点击、滚动、登录)才能显示时,BeautifulSoup就无能为力了,这时,你需要模拟真实用户的浏览器行为,目前主流的选择是Selenium和Playwright。
Selenium是老牌王者,生态成熟,文档丰富,但配置相对繁琐,运行速度较慢,Playwright则是后起之秀,由微软维护,支持多浏览器内核,自动等待机制更智能,执行效率更高,在2026年的技术选型中,新项目更倾向于使用Playwright,尤其是面对反爬虫机制日益严格的今天。
Selenium定位元素的常见陷阱
在使用Selenium时,开发者最常遇到的问题是”ElementNotInteractableException”或”TimeoutException”,这通常是因为页面尚未完全加载,或者元素被其他层遮挡。
解决策略包括:
- 显式等待:不要使用
time.sleep()进行盲目等待,而是使用WebDriverWait配合expected_conditions,直到元素可见或可点击后再执行操作。 - iframe切换:如果目标元素位于iframe框架内,必须先使用
switch_to.frame()切换到对应的框架,否则无法定位。 - Shadow DOM处理:现代Web组件常使用Shadow DOM封装内部结构,Selenium默认无法直接穿透,需要借助JavaScript执行器或特定插件来访问。
Playwright的自动化优势
Playwright通过其内置的自动等待机制,大幅简化了定位元素的难度,它会自动等待元素出现在视口中且处于可操作状态,Playwright支持录制模式,你可以直接在浏览器中操作,自动生成Python代码,这对于不熟悉CSS选择器的新手来说非常友好。
在对比Selenium和Playwright时,多数情况下,Playwright在脚本稳定性和执行速度上表现更优,特别是在处理复杂的多标签页和弹窗场景时。
不同场景下的技术选型与成本考量
选择哪种工具,不仅取决于技术可行性,还取决于项目的具体需求和预算。
| 特性 | BeautifulSoup | Selenium | Playwright |
|---|---|---|---|
| 运行速度 | 极快(纯文本解析) | 较慢(需启动浏览器) | 快(原生协议通信) |
| 资源占用 | 低 | 高 | 中 |
| 动态支持 | 不支持 | 支持 | 支持 |
| 学习曲线 | 低 | 中 | 低 |
| 反爬对抗 | 弱 | 中 | 强(自带隐身模式) |
对于小型个人项目或一次性数据提取,BeautifulSoup足以应付,对于需要模拟用户登录、填写表单的自动化测试或爬虫,Selenium是稳妥的选择,而对于追求高性能、高稳定性的企业级应用,Playwright正逐渐成为行业标准。
地域与合规性注意事项
在进行数据抓取时,必须遵守目标网站的robots.txt协议及当地法律法规,在中国大陆地区,爬取公开数据需注意不得侵犯个人隐私及商业秘密,据工信部相关指引,未经授权大规模抓取商业平台数据可能面临法律风险,在部署爬虫前,务必评估数据来源的合法性,并设置合理的请求频率,避免对目标服务器造成压力。
Python获取元素常见问题解答
python getelementbyid怎么用
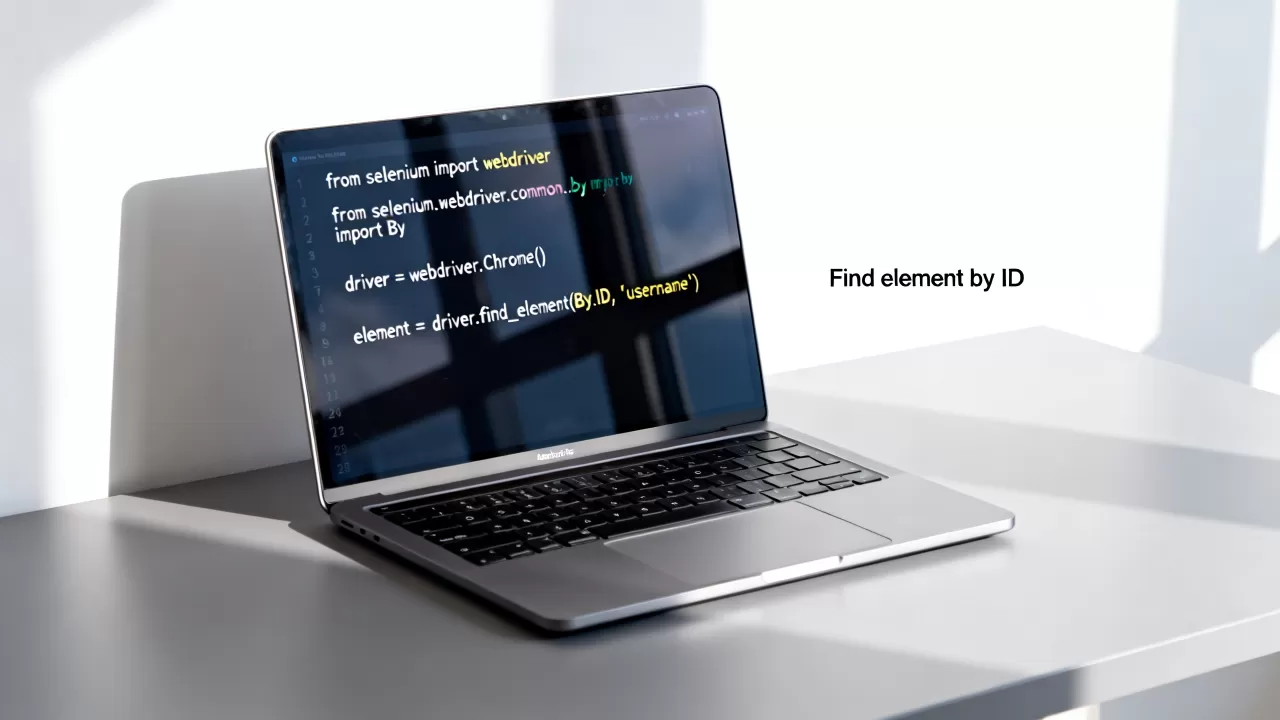
Python中没有直接的getelementbyid函数,如果使用BeautifulSoup,应使用soup.find('tag', id='element_id'),如果使用Selenium,应使用driver.find_element(By.ID, 'element_id'),注意Selenium 4版本后推荐使用By枚举类来定位元素,以替代已弃用的find_element_by_id方法。
python selenium 获取元素失败怎么办
获取元素失败通常由三个原因导致:元素未加载、元素位于iframe内、或选择器写错,首先检查网络请求,确认数据是否通过API异步加载,使用浏览器的开发者工具检查元素是否在iframe中,若是,需先切换框架,复制完整的CSS选择器或XPath,并在控制台测试其有效性,确保路径准确无误。
python 爬虫 获取元素 速度慢怎么优化
优化速度的核心在于减少不必要的浏览器启动和解析开销,对于静态页面,坚决使用BeautifulSoup或lxml,它们比Selenium快数十倍,对于必须使用浏览器的场景,考虑使用无头模式(Headless Mode)启动浏览器,关闭图片加载和CSS渲染,可以显著提升加载速度,使用连接池复用HTTP连接,以及合理设置并发线程数,也能有效缩短整体抓取时间。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/453121.html