

Hive导出数据最稳妥的方式是使用Beeline CLI配合重定向或Sqoop/Spark等ETL工具,避免直接使用Hive CLI,以确保数据完整性与格式可控。
在数据仓库的日常运维中,将Hive中的海量数据提取到外部系统(如MySQL、Oracle或本地文件)是极为常见的场景,许多初学者往往直接复制粘贴查询结果,这在处理百万级数据时会导致内存溢出或格式错乱,业内专家指出,构建标准化的导出流程不仅能提升效率,更能保障数据在流转过程中的准确性,本文将深入剖析几种主流导出方案,从命令行操作到自动化调度,帮助你找到最适合当前业务场景的解决方案。
命令行工具导出:Beeline与重定向实战
对于小规模数据或临时性分析需求,直接使用Hive的客户端工具是最快捷的路径,需要注意的是,旧版的Hive CLI已逐渐被弃用,目前行业标准推荐使用Beeline。
Beeline基础连接与查询
Beeline是基于JDBC的命令行工具,支持更稳定的连接管理和SQL语法,在实际操作中,你可以通过以下命令连接HiveServer2:
- 启动Beeline客户端:
beeline -u jdbc:hive2://<host>:<port>/<db> - 执行查询并指定分隔符:使用
SET hive.cli.print.header=true;开启列头显示,配合SET hive.cli.print.row=true;显示行数据。
利用Shell重定向实现文件导出
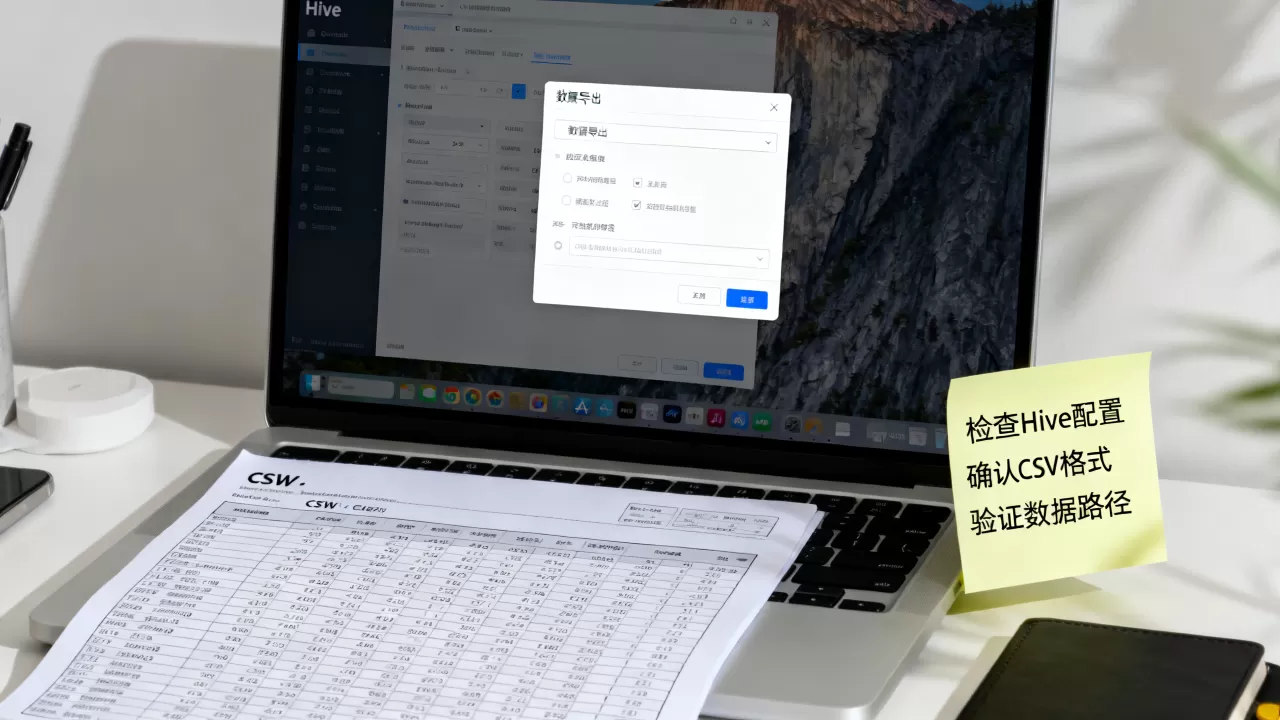
当需要将查询结果保存为CSV或TSV格式时,Linux Shell的重定向功能非常强大,这种方法无需编写复杂的Java或Python脚本,适合运维人员快速执行。
具体操作路径如下:
- 编写SQL脚本文件(如
query.sql),确保SQL语句末尾无分号,或者使用!quit控制退出。 - 在Shell中执行命令:
beeline -u jdbc:hive2://... -f query.sql > output.csv - 关键技巧:如果数据中包含逗号,直接重定向会导致CSV解析错误,建议在SQL中使用
concat_ws函数自定义分隔符,SELECT concat_ws('t', col1, col2) FROM table;
,然后导出为TSV格式,后续再用脚本转换为CSV。
注意事项与局限性
- 性能瓶颈:Beeline逐行读取结果,当数据量超过百万行时,客户端内存消耗巨大,容易导致OOM(内存溢出)。
- 编码问题:默认编码通常为UTF-8,若目标系统需要GBK编码,需在Shell层面使用
iconv工具进行转换。
大数据生态组件:Sqoop与Spark的高效迁移
面对TB级别的数据,命令行重定向已无法满足需求,需要借助大数据生态中的专用迁移工具,Sqoop和Spark是目前企业级应用中最主流的两个选择。
Sqoop:关系型数据库的桥梁
Sqoop(SQL-to-Hadoop)专门用于在Hadoop和关系型数据库之间传输数据,它通过MapReduce任务并行导出数据,极大地提升了吞吐量。
- 适用场景:将Hive表数据全量或增量导出到MySQL、Oracle等传统数据库。
- 核心命令示例:
sqoop export --connect jdbc:mysql://host/db --username user --password pass --table target_table --export-dir /user/hive/warehouse/source_table --input-fields-terminated-by 't' - 优势:支持断点续传,具备完善的错误处理机制,能够自动处理类型映射。
Spark:内存计算带来的速度飞跃
随着Spark在集群中的普及,越来越多的团队选择使用Spark SQL进行数据导出,相比Sqoop,Spark利用内存计算,速度更快,且能灵活处理复杂的数据清洗逻辑。
- 操作路径:
- 使用
spark-sql或pyspark读取Hive表。 - 通过
df.write.mode("overwrite").format("jdbc").option("url", "...").option("dbtable", "...").save()将数据写入目标数据库。 - 或者导出为Parquet/CSV文件:
df.write.csv("hdfs://path/to/output", header=true)
- 使用
业内共识认为,Spark在处理非结构化数据或需要复杂ETL逻辑的场景下,比Sqoop更具灵活性,Sqoop在纯关系型数据库同步方面依然拥有更成熟的生态支持和更低的配置门槛。
场景化选择:如何决策最佳导出方案?
在实际工作中,没有“最好”的工具,只有“最合适”的方案,选择导出策略时,需综合考量数据量、目标系统、实时性要求及团队技术栈。
| 维度 | Beeline重定向 | Sqoop | Spark |
|---|---|---|---|
| 数据规模 | GB级以下 | TB级 | PB级 |
| 目标系统 | 本地文件 | RDBMS | RDBMS / 数据湖 / 文件 |
| 技术门槛 | 低 | 中 | 高 |
| 实时性 | 近实时 | 批量 | 批量/微批 |
常见误区与避坑指南
- 忽视数据倾斜:在使用Sqoop或Spark导出时,若未指定合理的
split-by字段,可能导致某些Reducer处理数据量过大,造成任务卡死,建议根据数据分布选择主键或均匀分布的字段进行切分。 - 字符集冲突:Hive默认使用UTF-8,而部分老旧业务系统使用GBK或Latin1,在导出前,务必在目标端或转换层明确字符集转换逻辑,否则会出现乱码。
- 小文件问题:频繁的小批量导出会产生大量小文件,影响HDFS性能,建议合并小文件后再进行大规模导出,或调整Hive的
hive.merge.mapfiles参数。
自动化与监控:构建稳定的数据出口
单次导出成功只是第一步,构建可重复、可监控的自动化流程才是数据工程的核心。
调度系统集成
将导出脚本集成到Azkaban、Airflow或DolphinScheduler等调度系统中,可以实现定时自动执行,在脚本中嵌入邮件报警机制,当导出失败或数据量异常波动时,立即通知运维人员。
数据校验机制
在导出完成后,必须执行数据校验,常见的校验方法包括:
- 行数比对:统计Hive源表与目标表的记录数是否一致。
- 摘要校验:对关键字段进行Sum、Count等聚合计算,比对前后结果。
- 抽样检查:随机抽取少量记录,人工核对字段内容的完整性。
据统计,相当一部分数据质量问题源于导出过程中的格式截断或类型转换错误,因此校验环节不可省略。
hive导出数据常见问题解答
hive导出数据到mysql乱码怎么办?
乱码通常由字符集不一致引起,首先检查Hive表的存储格式是否为UTF-8,在Sqoop导出命令中,显式指定--input-encodng UTF-8和--output-encodng UTF-8,若目标MySQL库为GBK,需在MySQL端配置character_set_server=gbk,或在应用层进行编码转换。
如何高效导出Hive大表到本地文件?
直接SELECT 会导致数据倾斜和内存溢出,建议使用DISTRIBUTE BY和SORT BY对数据进行预处理,生成多个小文件,然后使用hadoop fs -get命令并行下载,或者,使用Spark的coalesce或repartition将数据重组为合适数量的分区,再写入本地HDFS目录,最后批量下载。
hive导出数据和hive查询结果有什么区别?
hive -e或beeline -e执行的是交互式查询,结果直接打印在控制台,适合临时查看少量数据,而hive -f或Sqoop/Spark导出是将结果持久化存储到文件或数据库,适合生产环境的数据流转,前者受限于终端显示缓冲,后者受限于存储资源和ETL工具配置。
数据导出的本质是数据价值的传递,选择正确的工具和方法,不仅能节省计算资源,更能确保数据在跨系统流转中的完整与安全,掌握上述核心技能,你将能从容应对绝大多数数据导出场景。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/452684.html




评论列表(1条)
卧槽这标题一看就踩过坑!“避免直接使用Hive CLI”——笑死,去年我真这么干过,INSERT OVERWRITE D