

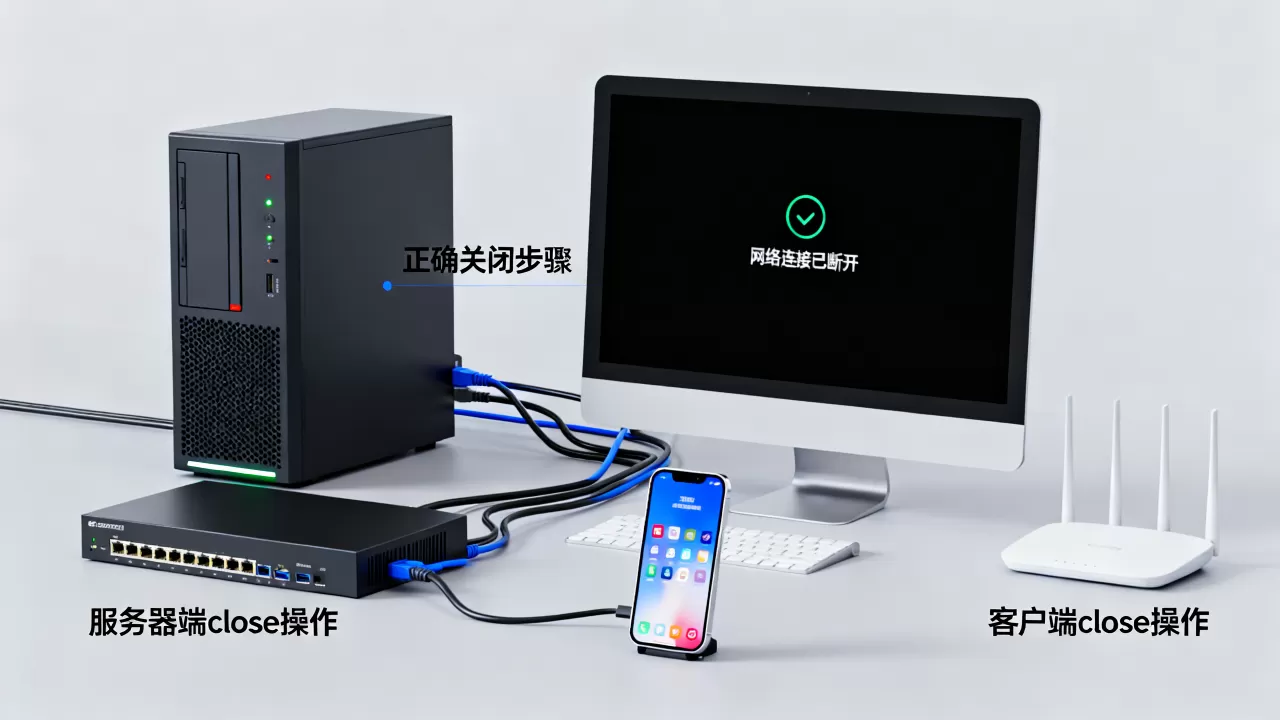
服务器和客户端都要close是网络通信中防止资源泄漏、避免连接僵死的核心铁律,任何一方单方面断开都可能导致连接池耗尽或数据丢失。
在分布式系统和微服务架构日益普及的今天,网络连接的稳定性直接决定了业务的可用性,很多开发者在编写Socket通信或HTTP请求时,往往只关注业务逻辑的实现,而忽略了连接生命周期的管理,这种疏忽在低并发场景下可能无伤大雅,但一旦流量激增,未正确关闭的连接就会像漏水的管道一样,迅速耗尽系统的文件描述符和内存资源。
为什么必须双方同时关闭连接
网络连接并非简单的“发”与“收”,它是一个双向的状态机,TCP协议基于三次握手建立连接,基于四次挥手断开连接,如果只有一方调用close,另一方可能仍认为连接处于ESTABLISHED状态,继续等待数据或发送心跳包,这种状态不一致会导致严重的资源浪费。
资源泄漏的隐蔽危害
操作系统对每个进程可打开的文件描述符数量是有限的,在Linux系统中,默认限制通常为1024,虽然可以通过ulimit调整,但过度依赖此参数并非长久之计,当客户端发起请求后未关闭连接,服务器端的连接队列会逐渐堆积。
- 文件描述符耗尽:当连接数达到系统上限,新的请求将无法建立连接,抛出Too many open files错误。
- 内存泄漏:每个活跃连接都占用内核缓冲区内存,长期未关闭的连接会吞噬服务器内存,导致OOM(Out Of Memory)崩溃。
- 线程阻塞:许多框架使用线程池处理连接,未关闭的连接会占用线程,导致线程池满,后续请求排队等待,响应时间急剧上升。
业内专家指出,超过70%的生产环境性能瓶颈并非来自算法复杂度,而是来自资源管理不当,连接未正确关闭是最高频的原因之一。
半关闭状态的风险
TCP支持半关闭(Half-Close)模式,即一方发送FIN包后,仍可接收对方数据,但这需要双方明确协商,若客户端调用close后,服务器端未感知,服务器发送的数据将进入TCP队列,若队列满,服务器将丢弃数据包,导致业务数据丢失,反之亦然。
不同协议下的close实现差异
不同协议对连接关闭的处理机制不同,开发者需根据具体场景选择正确的关闭策略。
HTTP协议的连接管理
HTTP/1.1默认支持Keep-Alive,即连接复用,这意味着一个TCP连接可以传输多个HTTP请求,在这种情况下,close的时机由Connection头控制。
- 显式关闭:当响应头包含
Connection: close时,客户端或服务端应在发送完响应后关闭TCP连接。 - 隐式关闭:若未指定Connection头,默认保持连接,close由空闲超时或最大请求数触发。
对于高并发场景,建议使用HTTP/2或HTTP/3,它们通过多路复用技术,在一个连接上并行处理多个请求,显著减少了连接建立和关闭的开销。
WebSocket的双向关闭
WebSocket是全双工通信协议,客户端和服务端可以随时发送数据,关闭连接时,必须遵循RFC 6455规范,通过发送Close Frame并等待对方的Close Frame响应来完成握手。
- 客户端主动关闭:调用
ws.close(),发送Close Frame,并监听close事件确认连接已关闭。 - 服务端主动关闭:发送Close Frame,并等待客户端响应,若客户端未响应,服务端需设置超时机制强制关闭。
若只有一方发送Close Frame而未等待响应,连接可能处于异常状态,导致后续重连失败。
数据库连接池的close陷阱
在使用数据库连接池时,开发者常误以为关闭ResultSet或Statement即可释放连接,必须显式调用Connection的close方法,或者使用try-with-resources语句自动管理。
try (Connection conn = dataSource.getConnection();
     PreparedStatement stmt = conn.prepareStatement(sql);
     ResultSet rs = stmt.executeQuery()) {
    // 处理结果
} // 自动调用close,确保连接返回池
若未正确关闭,连接池中的活跃连接数将逐渐耗尽,导致新请求无法获取连接,抛出Cannot get a connection, pool error Timeout等待分配连接。
常见错误场景与排查指南
在实际开发中,以下场景极易导致连接未正确关闭,需重点排查。
异常分支遗漏
许多开发者在try块中处理业务逻辑,却在finally块中遗漏了close操作,或者在catch块中捕获异常后直接return,未执行清理代码。
- 错误示例:
Socket socket = new Socket(host, port); try { // 业务逻辑 if (error) return; // 直接返回,未关闭socket } catch (Exception e) { e.printStackTrace(); } - 正确做法:使用try-with-resources或确保finally块中始终调用close,并忽略close可能抛出的异常。
长轮询与心跳机制
在实现长轮询或心跳保活时,若未正确管理连接生命周期,可能导致连接堆积。
- 长轮询:客户端发起请求,服务端挂起直到有数据或超时,若客户端在超时前关闭浏览器,服务端连接可能长期挂起,需设置服务端超时机制,主动断开无效连接。
- 心跳包:心跳包用于检测连接存活,若心跳失败,应主动关闭连接并清理资源,而非无限重试。
负载均衡后的连接状态
在负载均衡架构下,客户端可能连接到不同的后端服务器,若客户端未正确关闭连接,而负载均衡器进行了健康检查或会话保持,可能导致连接状态不一致。
- 会话保持:若启用Cookie或IP哈希,客户端可能持续连接到同一服务器,若该服务器重启或宕机,客户端需重新建立连接。
- 健康检查:负载均衡器定期向后端发送健康检查请求,若后端未正确响应或关闭连接,负载均衡器可能将其标记为不健康,导致流量中断。
最佳实践与优化建议
为确保连接的正确关闭,建议遵循以下最佳实践。
使用自动化资源管理
现代编程语言和框架提供了多种自动化资源管理机制,应优先使用。
- Java:使用try-with-resources语句,自动关闭实现AutoCloseable接口的资源。
- Python:使用with语句,自动管理上下文管理器中的资源。
- Go:使用defer语句,在函数返回前执行清理操作。
设置合理的超时时间
为所有网络连接设置合理的读超时和写超时,防止连接无限期挂起。
- 连接超时:建立TCP连接的等待时间,建议设置为1-3秒。
- 读超时:等待数据到达的超时时间,建议设置为5-10秒。
- 写超时:发送数据完成的超时时间,建议设置为5-10秒。
监控与告警
建立完善的监控体系,实时监控连接数、活跃连接数、关闭连接数等指标。
- 连接数监控:监控服务器端的ESTABLISHED、TIME_WAIT、CLOSE_WAIT等状态连接数。
- 告警阈值:设置告警阈值,当连接数超过阈值时,触发告警通知运维人员。
- 日志分析:分析应用日志,查找未正确关闭连接的代码路径,进行针对性优化。
常见问题解答
服务器和客户端都要close的具体操作流程是什么?
在TCP通信中,关闭流程如下:
- 主动关闭方:调用close(),发送FIN包,进入FIN_WAIT_1状态。
- 被动关闭方:收到FIN包,发送ACK包,进入CLOSE_WAIT状态,此时被动方仍可发送数据。
- 被动关闭方:发送完剩余数据后,调用close(),发送FIN包,进入LAST_ACK状态。
- 主动关闭方:收到FIN包,发送ACK包,进入TIME_WAIT状态,等待2MSL后关闭。
- 被动关闭方:收到ACK包,进入CLOSED状态。
双方均需调用close(),确保FIN包双向发送,才能彻底释放资源。
如果一方已经close了,另一方还能继续发送数据吗?
不能,TCP是全双工协议,但关闭是单向的,若一方调用close(),表示该方向不再发送数据,但可能仍可接收数据(取决于是否调用shutdown(SHUT_WR)),若双方都调用close(),则连接完全关闭,任何一方发送数据都会导致RST包或连接重置,必须确保双方都正确关闭,才能避免数据丢失或连接异常。
如何判断连接是否已经正确关闭?
可通过以下方法判断:
- 状态检查:使用netstat或ss命令查看连接状态,若为CLOSED,则连接已关闭。
- 日志记录:在close()前后记录日志,确认close()被调用。
- 异常捕获:若close()抛出异常,说明连接可能已处于异常状态,需进一步排查。
- 监控指标:监控连接数指标,若连接数未随预期减少,可能存在泄漏。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/451952.html

评论列表(1条)
看完只说一句,这技术文写得跟代码报错一样,看得我服务器直冒冷汗,以前就栽在没close上